前几天听CoRL大佬辩论大模型能带来通用机器人吗?Russ Tedrake这个非常Model Based的人竟然坐在了Learning一方,并反复提及Diffusion Policy。我非常好奇这个Diffusion Policy到底是什么?于是找了这篇论文的资料来看:应用了Diffusion Policy的机器人在任务过程中动作之丝滑,轨迹之连贯,对不同材质物体之广泛适用让我眼前一亮。不禁感慨,This is SOTA(State of the Art)!
那什么是Diffusion Policy?首先Diffusion,它是一种生成方法,如今图像生成领域的成就基本都是基于Diffusion方法,比如常听的Stable Diffusion和Midjourney。其次Policy,它是机器学习算法用来驱动机器人的核心组成部分,它的输入是各种感知信息(比如相机拍到的视频,还有机器人各个关节的位置),而输出的是机器人要执行的动作。所以简单理解,Diffusion Policy就是应用Diffusion这种方法生成机器人动作的一种Policy。
可能看到这里你并没有觉得这个方法有什么特别,虽然不敢夸大Diffusion Policy未来的影响,但我特别相信它会是通用机器人成为现实路上非常重要的工作!这篇关于Diffusion Policy的论文介绍和你以往看过的任何一篇论文介绍都不同,它不是生硬的学术介绍,也不是夸大的媒体PR,它是一篇可以让非学术背景的人看得懂的笔记。为了做到“看懂”,我非常荣幸的邀请到了“Diffusion Policy-Visuomotor Policy Learning via Action Diffusion”这篇论文的一作迟宬博士做采访,也非常感谢他提供的清晰和生动的解释。
关于Diffusion Policy以及它可能带来的无限可能,请找20分钟左右的时间,坚持看到文末,以下,Enjoy!
查看原文目录
以下为本文目录
👇
Diffusion Policy的效果
Diffusion Policy团队介绍
什么是Diffusion Policy
为什么用Diffusion Policy
采访中提到的其他问题
一些想法
1. Diffusion Policy的效果
在将机器人的手牵向人类的手:灵巧操作华人论文综述这篇文章里,我们提到了一个观点:机器人操作的执行(action)是木桶最短的板。在解决机器人灵巧操作执行方面,Diffusion Policy显示了非常好的效果和很大的潜力。作为非学术背景的人,看任何学术工作,最喜欢看视频,效果最直观。在介绍Diffusion Policy之前,我们直接看下它的效果。
摊披萨:在1X速度的情况下,摊披萨酱,机器人手部没有卡顿,尤其是在有人故意拖动披萨的情况下,摸酱的动作依然流畅。
摊披萨#Diffusion Policy(请在微信公众号原文观看)
扣杯子:不管你怎么扔杯子,机器人都可以精确地把它按照希望的角度和位置给扣过来。
扣杯子#Diffusion Policy(请在微信公众号原文观看)
对图:机器人将T精准对到图框里,和Diffusion Policy相比,其他方法在路径上没那么连贯,并且很容易出现在临近图框的位置卡死的情况。
对图#DiffusionPolicy(请在微信公众号原文观看)
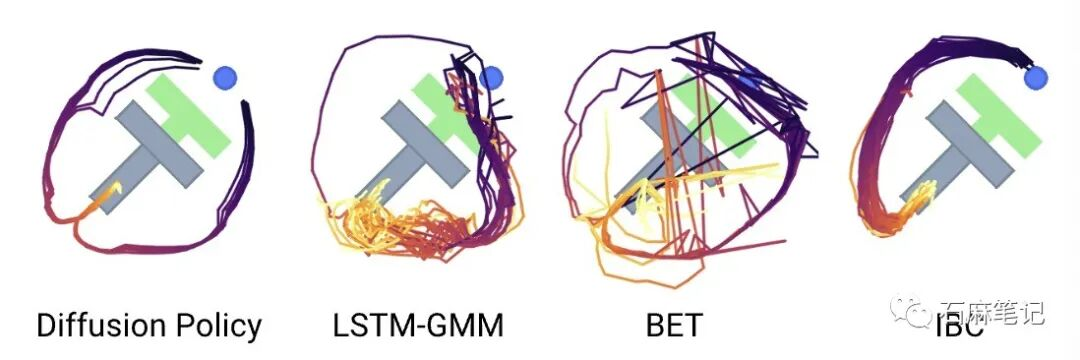
MIT教授兼丰田机器人研究院负责人Russ Tedrake在一个视频中详细的介绍了Diffusion Policy取得的惊人效果,他说每天醒来都期待着机器人能够完成新的技能。
Diffusion Policy #TRI #Russ Tedrake(请在微信公众号原文观看)
根据论文摘要,作者在四个不同的机器人操纵基准的12项任务中对Diffusion Policy进行基准测试,发现它在性能上优于现有的最先进机器人学习方法,平均改进了46.9%。丰田机器人研究院(TRI,oyota Robotics Institution)作为这篇论文的赞助商,也对Diffusion Policy给予了很高的评价:基于扩散策略的突破性生成式人工智能方法,可以快速而自信地教会机器人新的灵巧技能。这一进展显著提高了机器人的效用,是构建机器人“大行为模型(LBMs)”迈出的一步,类似于最近彻底改变了对话人工智能的大型语言模型(LLMs)。
TRI已经使用这种新方法教会机器人超过60种困难的灵巧技能,包括倒液体、使用工具和操纵可变形的物体。这些成就是在不写一行新代码的情况下实现的;唯一的变化是为机器人提供了新的数据。在这一成功的基础上,TRI制定了一个雄心勃勃的目标,到今年年底教授数百项新技能,并在2024年底前教授1,000项新技能。
2. Diffusion Policy团队介绍
Diffusion Policy这篇工作是哥伦比亚大学宋舒然团队和MIT教授Russ Tedrake带领的丰田机器人研究院共同创作。论文的一作迟宬目前是哥伦比亚大学的计算机科学博士生,在宋舒然的指导下做机器人操纵和感知相关的研究。
迟宬的研究兴趣在于计算机与物理世界的交互,他2019年本科毕业于密歇根大学。除了作为Diffusion Policy的一作,迟宬也是RSS 2022 Best Paper “Iterative Residual Policy for Goal-Conditioned Dynamic Manipulation of Deformable Objects”的一作;此外他也参与了RoboNinja(切牛油果)和DextAIRity(吹风叠衣服)两篇很有趣的操作工作(将机器人的手牵向人类的手:灵巧操作华人论文综述)。关于宋舒然我们在(AI+Robotics华人图谱)文章中做过介绍。这篇论文的作者除了迟宬,还有哥伦比亚大学的Zhenjia Xu,MIT Yilun Du,TRI 的Siyuan Feng,Eric Cousineau和Benjamin Burchfiel。
3. 什么是Diffusion Policy?
Diffusion Policy是一种新型机器人行为生成方法(Robot Action Generation),将机器人的视觉动作策略(Visuomotor Policy)表示为条件去噪扩散过程(Conditional Denoising Diffusion Process)。这是来自论文摘要里的一句介绍,但我想大多数和我一样非专业背景的人看到这段话应该是一脸懵,每个字都认识放在一起就不知道什么意思。
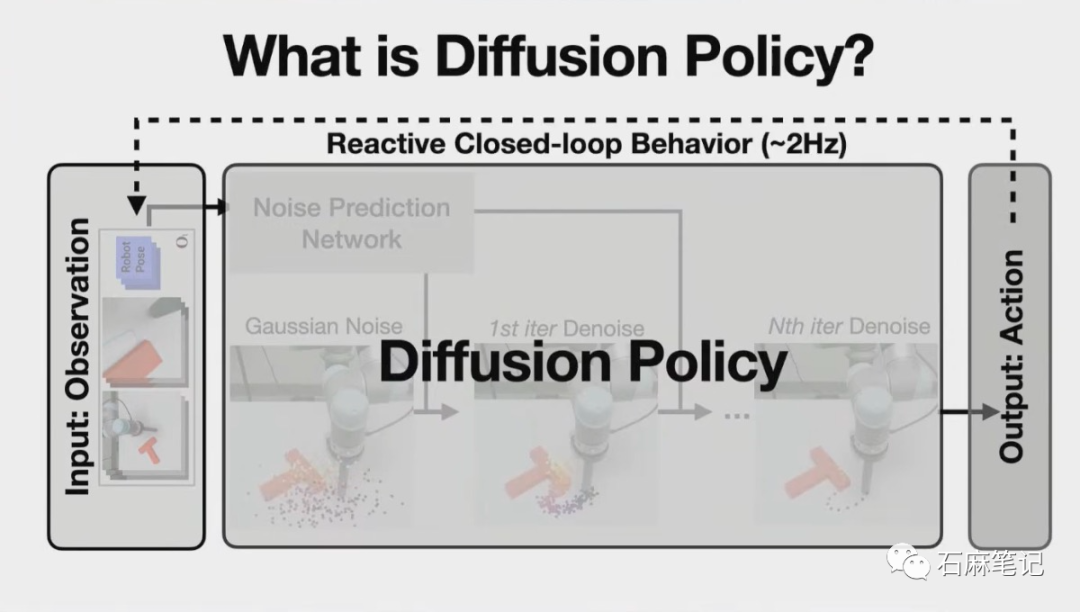
关于什么是Diffusion Policy,迟宬有一段很好的解释:Diffusion Policy其实解决的是一个机器人输出的问题,过往的很多工作大家都注重在解决输入的问题,但机器人最终要执行,我们的工作就在于解决机器人动作和输出的问题。更确切地说,我们的创新聚焦于机器人的动作端而非输入端,在输入端使用的是非常普通的东西。尽管输入端有很多可以提高的地方,但机器人学习方法必须注重输出端,先前的算法在输出端的表现都不够好。因此,无论输入端有多么创新,如果输出端表现不佳,就像"茶壶煮饺子倒不出"一样,将无法发挥潜力。
RSS 2023宋舒然有一段对Diffusion Policy的讲解视频,也非常清晰。
Diffusion Policy和Diffusion Model的关系
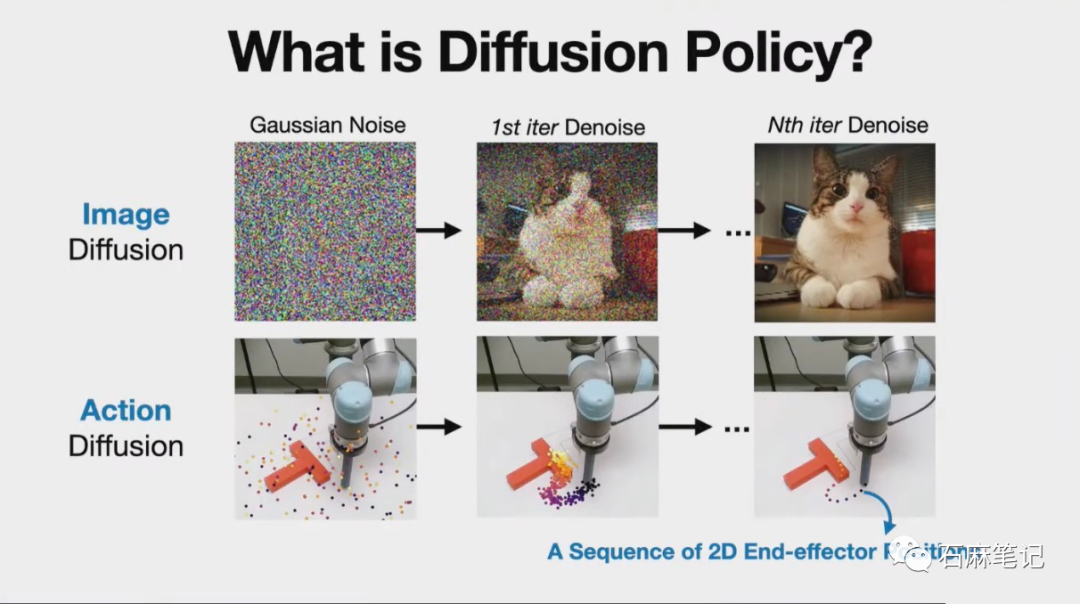
Diffusion Policy可以理解为Diffusion Model在机器人领域的应用。大家都知道Diffusion Model在图像领域的应用产生了非常好的图像生成模型,比如Stable Diffusion这些,比GAN这类图像生成模型的效果好很多。同样的,Diffusion Policy可以理解为这套Diffusion Model在机器人动作生成领域的应用,尤其是部署到物理机器人领域的动作生成。
4. 为什么用Diffusion Policy?
Diffusion Policy解决的核心问题
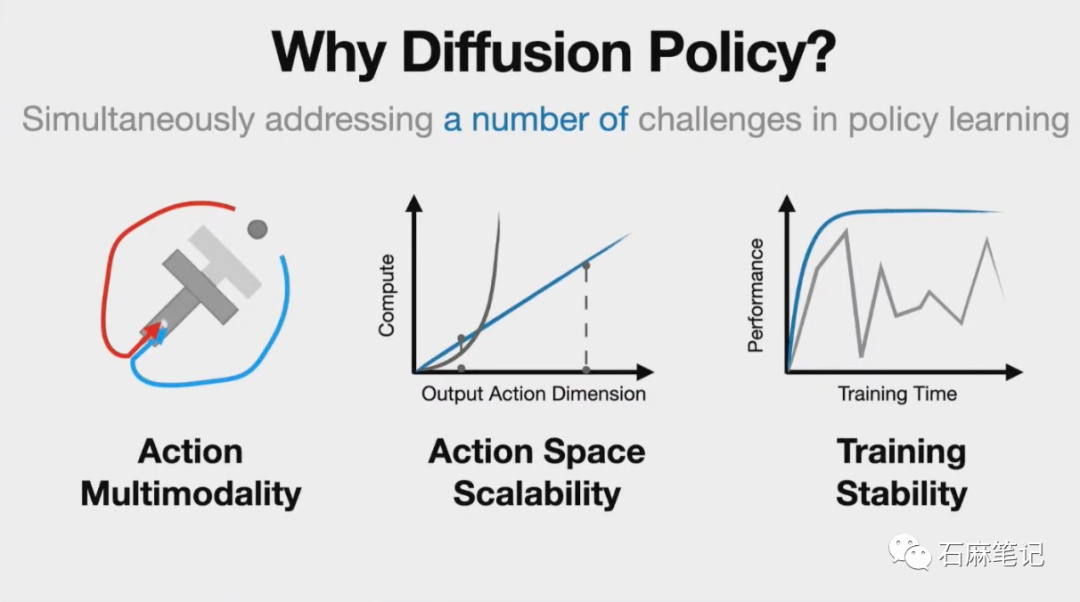
从最简单的形式来看,从演示中学习策略可以被表述为学习将观察映射到动作的监督回归任务。然而,在实践中,预测机器人动作有一系列挑战,比如存在多模态分布、时序相关性和训练稳定性的要求。
解决机器人Multi-Modal分布问题
机器人Multi-Modal的问题,简单理解,现实世界中解决某一特定任务的方式是多样的,而不是唯一的。但神经网络预测只能给出单一的方式,无法应对可能有多种方式的任务情况。
关于什么是机器人Multi-Moda问题,迟宬给了非常清晰的解释:假设我现在在开车,前面有一棵树。比如说,我雇佣了100个司机来解决这个问题。在这种情况下,有可能有50个司机选择往左拐,绕过树的左边,还有50个司机选择从树的右边绕过去。在这种情况下,往左绕和往右绕都是完全合理的。然而,当我们将所有这些解决方案合并为一个时,问题就变成了一个多模态分布,即我看到的相同场景有两种不同的选择。这对传统神经网络的预测来说并不友好,因为它通常使用均方误差(MSE)损失进行训练,而这无法有效处理Multi-Modal情况。
前馈神经网络本质上是一个函数,即对于给定输入,只有一种输出。然而,在某些情况下,一个输入可能对应两种不同的输出。这导致了一个问题,即我想要神经网络执行的任务和它能够执行的任务存在冲突。强行让神经网络处理这种情况,通常是通过预测一个中间值,试图最小化与数据之间的距离。但这可能导致不符合预期的行为,例如直接往树上撞。为了解决这个问题,引入了概率分布,使得神经网络不再是一个输入一个输出的函数,而是一个输入可以有多个输出的函数。这种方法提供了更大的灵活性,可以表示各种概率分布,解决了原有方法的限制。
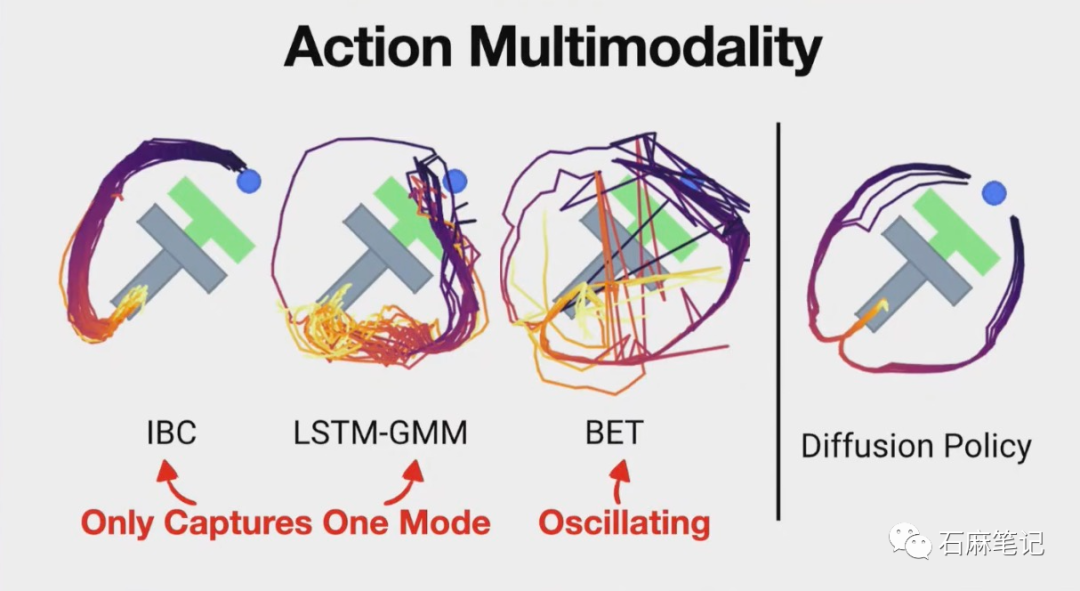
引入概率分布的方法提供了更大的灵活性,让机器人有机会在相同的情况下选择不同的行为,从而避免陷入不可预测的循环。这种非确定性的特性在实际应用中表现出很大的优势,可以防止算法陷入一成不变的状态。但这和传统机器人控制需要对机器人动作严格控制的思路相违背,每次只执行一项任务,整个机器人系统都被认为是受到严格控制的。这也是为什么大多数人没有把机器人动作生成表现为一个概率分布的原因。
但仔细想下人类在决策时也具有一定的非确定性,即在相同情境下可能做出不同选择。比如说,就像我刚才说的,正前方有棵树。你可能今天心情好,你就往右拐;今天心情不好,你就往左拐。这种非确定性对人类来说可能是一种优势,而不是劣势,对机器人同样如此。举例来说,假设我在机器人的算法里有个bug,就是看到一个锥筒,机器人就会绕着它打转。如果我的算法是确定性的,比如说你现在在这条路上开车,我往路上扔一个锥桶,你就开始绕着这个锥桶打转,可能一辈子也开不出来。然而,如果我的机器人预测不是单一模型,而是一个概率分布,有一定的概率它会绕着打转,有一定的概率它会往直走,这样它就能够突破这个无穷打转的情况,最终回到正常的状态。这个性质在实际应用中对提高算法的鲁棒性有很大的影响,它可以防止算法陷入在某些不太熟悉的情况下一直打转的困境。
Action Space Scalability的问题
关于Action Space Scalabiltiy或者sequential correlation问题,我简单理解就是机器人对未来动作的预测不应该只局限于眼前的一步两步动作,而应该更有前瞻性,可以往前预测数十步动作。
针对这个问题,迟宬给了非常清晰的解释:数据预测有两种方法:一是直接输出一个数值,另一种是将可能的数值分成几个区间,进行离散预测。在预测Multi-Modal Action的时候,人们倾向于采用离散预测,将连续值问题转化为分类问题,但这样做涉及的算力成本很高,尤其在处理高维空间时。此外,针对机器人控制问题,如果采用分类方法,每一步都需要预测下一步要执行的动作,而实际需求是希望一次性预测多步动作,这就涉及到了连续控制中的动作一致性问题。解决这个问题的挑战在于平衡成本和对高维连续控制的需求。
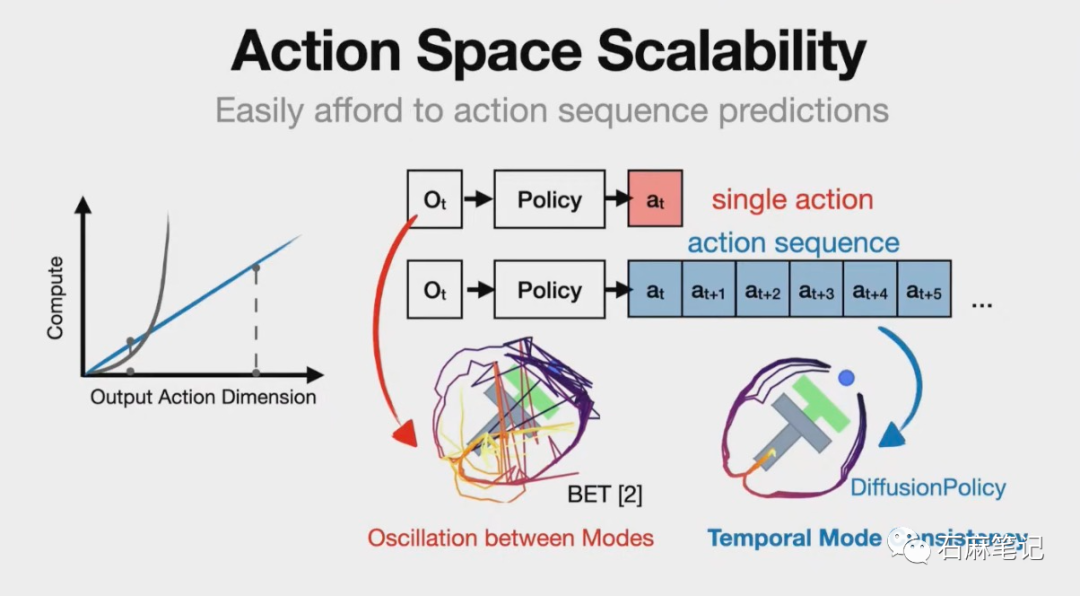
假设我们仍然在进行驾驶操作。我们有选择往左或往右拐的能力,将这个过程比喻为方向盘的控制,这是唯一的控制维度。我们将这个控制维度划分成了100个段。接着,我通过神经网络让它在这100个段中选择我们要采取的方向。这种方法理论上是可行的,但问题在于实施的成本非常高昂。如果我们只有一个维度,例如方向盘,那么使用分类是可行的。但假设我要控制的是一个具有六个自由度的机械手,甚至考虑到夹爪开关,有七个自由度,这时如果我要对其进行分类,就不再是在一个维度上切分成100份,而是每个维度都要切分成1000份。然后,将所有这些切分的部分相乘,才能得到我们整个空间的方法。如果采用这种方法,成本将会非常非常高。随着维度的增加,成本会呈指数级增长。
我们再回到了之前提到的问题。假设我们在驾驶车辆,我们可以在下一步稍微往左偏一点,再下一步再进一步左偏。实际上,我们所绘制的行车轨迹有两种可行的选择。一种是持续向左开,从左侧绕过去,一直保持这种路径。另一种是持续向右开,从右侧绕过去。在预测这个动作时,我们可以逐步进行预测,即在每个时刻,预测下一步应该怎么走。然而,采用这种方式可能会导致问题,例如,如果我稍微向左偏了一点,我可能会左右摇摆;如果我稍微向右偏了一点,也有可能左右摇摆。这个问题被称为动作不一致(Action Inconsistent),即当我希望向左行驶时,神经网络的预测中仍然存在一定概率是向右的情况,这时候就会发现决策非常犹豫,时而向左,时而向右,这是一个问题。
在我刚刚提到的分类中,由于它们预测高维空间的成本非常高,因为它们只能预测一步,接下来的步骤是什么。如果再加上更多的步骤,维度就会变得越来越高,它们就无法胜任。然而,实际上我们现在追求的是具有以下特性的方法:不仅可以预测每一步,而且可以在高维连续控制中实现。对于我们来说,我们可以直接预测未来每一步,无论是接下来的20步还是100步,是向左还是向右,而不是在每一步预测之后再执行,再决定下一步该怎么走。
Training Stability问题
Diffusion Policy和其他使用生成式模型的策略比,他的最大特点是训练过程非常稳定。
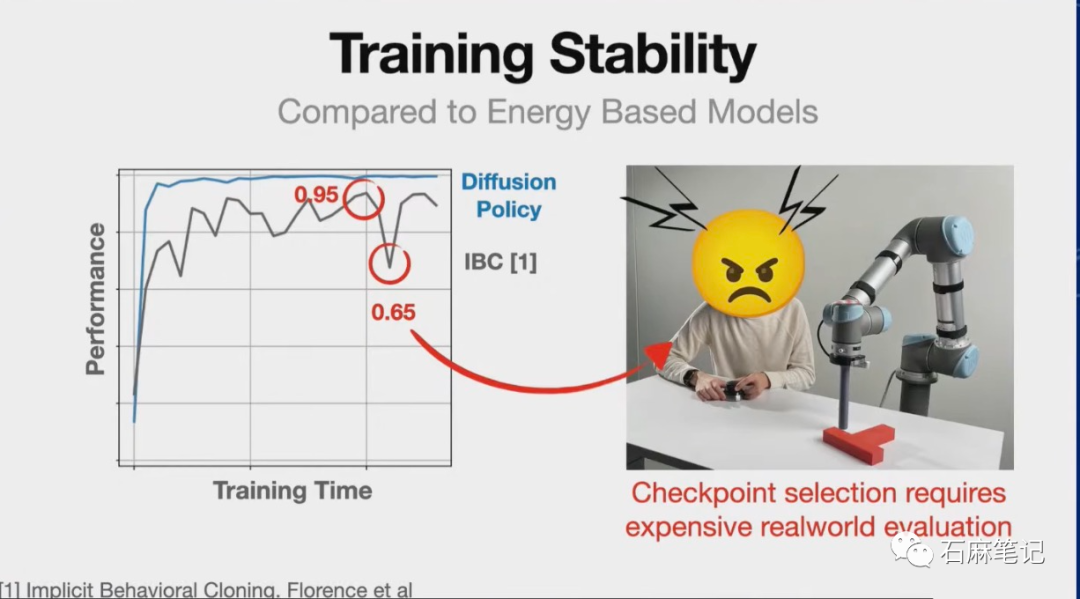
关于训练稳定性,迟宬的进一步解释是:在Robot Learning领域,机器人动作执行主要有三种方法:包括直接回归、分类预测和生成式模型。第一类回归,即将神经网络视为一个函数,输入是图片,输出是一个动作。这是最常见的方法,绝大多数强化学习都采用这种方式。然而,这种方法存在一些问题,正如之前提到的。第二类分类预测,这种方法通过预测分类来生成动作,前文已经大致描述,不再详细赘述。第三类生成模型,理论上所有的生成模型都可以预测连续的多模态分布,但很多生成模型的问题是训练不稳定。
基于Diffusion Model的第三类方法具有一个重要的优势,即训练非常稳定。这也是为什么Diffusion Model当前在图像生成方面取得了成功,而当时的生成对抗网络(GAN)并没有成功的原因。在当时,GAN在学术界能够产生一些不错的效果,但当你真的将其应用于产品时,你会发现非常困难。要训练一个有效的GAN,你需要疯狂地调整参数,然后才能训练出可用的生成器。
而Diffusion方法的强大之处在于,它的性能不逊色于GAN,但其训练过程非常稳定。基本上,你可以随便调整参数,生成器就能够输出结果,可能效果不是最优的,但基本上都能work。同时,这也解释了为什么像Stable Diffusion这样的方法,以及现在各种图像生成模型能够在如此庞大的数据集上进行训练,这是因为它们的训练非常稳定。如果你在如此大规模的数据上使用其他方法进行训练,可能会在训练一段时间后出现奇怪的问题,模型无法进一步优化。
5. 采访中提到的其他问题
Diffusion Policy和RL以及Imitational Learning是什么关系?
在Robot Learning领域,机器人操作比较常用的两个路径是强化学习(Reinforcement Learning)和模仿学习(Imitation Learning),Diffusion policy并不与强化学习和模仿学习冲突,它可以应用于两者。该方法是一种策略逻辑,适用于输入图像并输出相应动作的情境。在论文中,我们使用了模仿学习,即由人类遥控机器人执行动作,收集数据,并通过学习将其转化为策略。这种学习过程通过遥控机器人完成一系列动作开始,然后将其迁移到机器人身上。输入数据包括过去几帧的图像,而输出涉及对未来动作的预测。
很多强化学习的人,他们使用强化学习在模拟器中生成大量数据。在这个过程中,为了加速训练,RL policy的输入不是图片,而是一些低维度的底层状态信息。但是由于这些状态信息在现实环境里是无法获得的,因此这个RL policy不能直接用于驱动机器人。这个时候,他们会把RL policy生成的数据用于训练一个图片作为输入的模仿学习策略,这被称为蒸馏。在这种情况下,模仿的对象并非人类,而是一个强化学习“代理”(Agent)。这也是这种方法的应用之一。
操作(Manipulation)和移动(Locomotion)的训练有什么不同?
RL在移动有更好的效果,Sim2Real Gap的问题相对好解决;但在操作,RL存在最大的问题是Sim2Real Gap没法很好的解决。对于操控而言,需要考虑的因素较多,其中一个关键区别是在机器人操作中除了需要考虑机器人本身的物理特性,同时还要适应复杂多变的环境和被操作物体。操控涉及与各种各样的物体进行交互,每个物体都具有独特的物理特性,如重心、摩擦力和动力学。这些在模拟器中难以准确模拟,即便能够模拟,精度通常较低,速度较慢。相比之下,对于locomotion,外界环境大多可以视为一个刚体,物理特性基本可以忽略。这使得可以花费更多时间来建立机器人本体的精确物理模型,以及设计更复杂的物理引擎。这是为什么RL更适合Locomotion,而对有物理机器人部署Manipulation没有那么好的效果。
Diffusion Policy目前会存在什么问题,未来有哪些工作?
目前最大的问题不是Policy本身,而是数据。训练数据对于机器人执行特定任务至关重要。尽管我们已经积累了一些关于遥控机器人执行任务的数据,但要将其部署到实际应用中,比如设计一个家用机器人来洗碗,就需要更大规模、更丰富多样的数据集,类似于ChatGPT的规模。确保机器人能够在各种家庭环境中表现出足够的稳健性。目前,最大的挑战在于如何有效地收集大量、多样化的数据。这是下一步研究的关键,通过数据收集和训练,期望能够解决当前面临的问题,同时也认识到可能会有新的挑战随着数据规模的增加而浮现。
6. 一些想法
直接对话学者是我一直想尝试的一种输出方式,希望以一种更容易理解的方式,将最前沿的学术成果以及它们的可能性展现给更多人。因为担心我自己在一些基础知识上理解的不够深入,提出一些非常“业余”的问题,这个尝试迟迟没有展开。作为第一次尝试,我特别感谢迟博士非常耐心的回答我的很多“业余”问题,并对成文后的很多文字表述给予了非常细致的修改建议。我自己也在交流过程中收获很多。
最近一段时间,我将自己在Robot learning领域学习的内容整理成笔记以公众号的形式分享出来,收到了很多读者的肯定。非常感谢所有读我文字的朋友!关于文字表达,我其实从小到大语文偏科,中文写作是我最讨厌的科目,没有之一。我可能做梦都没有想到我会写文字给别人看。有些投资人朋友问我,为什么我可以这么专注在一个领域,虽然有很多客观因素,但主观上我是真的好奇到底通用机器人是否会到来,什么时候到来,如何到来。以前看很多方向,会为了投成项目而去学习一些资料。但看Robot Learning是反过来的,我在试图从最前沿的学术里面找到一些答案的同时,顺带认识一些优秀的人,看到一些不错的创业项目。
最近在读吴军的《大学之路》,我觉得有一段话特别好分享出来:“教育是一辈子的事情,我们不必担心输在起跑线上,因为世界上大部分人跑到一半就不会再跑了,这就给了那些长跑者以机会。一个善于学习的人,随着年龄的增长,他会找到自己的兴趣点,而那时如果他还能够学习,就有目的性和针对性了。”投资这个行业最大的一个特点是,从业者必须保持持续学习的状态,这也推动了我不断学习。
近一段时间,这波机器人创业和投资的温度都有所下降,也许明年会进一步降温,但对于一个真正感兴趣的人,市场的温度重要吗?
References:
Diffusion Policy Project Page:
https://diffusion-policy.cs.columbia.edu/#paper
Cheng Chi Github:
Russ Tedrake“Dexterous Manipulation with Diffusion Policies”Youtube链接:
https://www.youtube.com/watch?v=whpK0HDtOJ0&t=482s
宋舒然RSS 2023报告:
https://www.youtube.com/watch?v=hEO2-LY5i0o