留心的朋友可以发现,25年开始石麻笔记的采访基本都围绕人形机器人的全身运动控制来展开,无论是连续三期全身运控学者的专访专访Xue Bin(Jason) Peng:探索人形机器人全身运控的通用控制器,专访罗正宜:解密PHC——人形机器人通用控制器,对话李钟毓:如何构建足式机器人的“小脑”还是对开源人形硬件项目的专访OSH EP1:ToddlerBot——来自斯坦福的小型人形机器人开源项目。
最近新开的Human Data系列则是聚焦在人形机器人全身运控的数据来源问题。数据一直是用learning的方式做机器人学习的挑战,我们在2024年做过一个Robot Data系列arobot data,采访了10几篇机器人学习数据金字塔上各个维度数据采集的经典工作。Human Data则会聚焦在如何利用好人体数据来辅助机器人学习,我们会采访8-9篇依托人体动捕数据和人体视频数据来做人形机器人学习和控制的论文。
Human Data第一期采访了TWIST(Teleoperated Whole-Body Imitation System)。TWIST是一个基于全身动作模仿的人形机器人遥操作系统。该系统通过将人类动捕数据(MoCap)重定向(retargeting)到机器人上,生成参考动作片段,然后结合强化学习与行为克隆训练出一个稳健、自适应且高响应的全身控制器。这篇工作的一作是迮炎杰和陈子玄博士。我们这期采访对象是迮炎杰博士,他目前是斯坦福大学计算机科学系攻读博士学位的二年级学生,由Jiajun Wu和C. Karen Liu指导。
对如何利用人体动捕来做人形机器人遥操作感兴趣的朋友,欢迎来了解下炎杰的一些思考。TWIST作为利用动捕遥操人形的系统目前已经开源,欢迎在文末reference部分查看开源链接。
查看原文目录
以下为本文目录
👇
1. TWIST提出的背景
2. TWIST和其他动捕数据驱动控制的区别
3. 人体动作数据获取都有哪些方案
4. TWIST方法介绍
5. 关于Retargeting
6. 关于GMR
7. 使用MoCap遥操的注意事项
1. TWIST提出的背景
DP3和iDP3这两个工作DP3+iDP3:如何利用3D输入提升Diffusion Policy的泛化性主要聚焦在让机器人上半身执行人类类似的动作。在做iDP3的过程中,我开始更深入地接触全身运动控制相关的内容。因为只控制上半身时,机器人的工作空间会受到限制。以 iDP3 为例,我们当时设计了一个能控制腰部和脖子的系统,让机器人的工作空间比普通双臂机器人更大。它可以弯腰触碰前方物体,也能直立完成近距离操作。
当时算法已经能让机器人在特定环境下执行一些动作,比如在前台、客厅或厨房测试时效果不错。但它还不能自主移动,需要人工推着。后来我意识到,机器人应该像人一样,能自主地从一点移动到另一点,并完成任务。于是我们开始思考如何让机器人具备这种能力——先让它被人操纵,先“像人一样动起来”。这成为我们后续研究的起点。
我们做了一些调研,发现要搭建一个能让整个人形机器人像人一样动起来的系统,之前有尝试过,比如利用外骨骼、基于学习的控制或模型预测控制上进行。我们这个系统(Twist)尝试以人体动作捕捉设备作为接口,实时获取高质量的人类动作数据,用这些动捕数据去驱动机器人。这样可以让机器人的全身,包括脚、腰、膝盖、胳膊等部位都与人类动作同步,而不仅仅是上半身或末端执行器。
搭建这个系统之后,我们可以让机器人做真正的人类动作。例如,在厨房里遇到挡路的门,同时手上拿着东西时,机器人可以用脚把门踢开,然后继续走过去。这个例子说明了为什么让人形机器人像人一样动起来非常重要——它是实现机器人执行人类功能的基础。第一步是工业界搭建硬件平台,第二步是我们这些做算法的人去设计系统,使机器人能够真正动起来。
TWIST利用MoCap设备遥操人形机器人
2. TWIST和其他动捕数据驱动控制的区别
我觉得从整个系统设计的角度来看,它确实与之前的很多工作有相似之处。大概十年前或者五年前,在日本就有一些比较早期的尝试,他们通过全身动作捕捉或者外骨骼驱动获取人类数据,然后去驱动人形机器人。当时他们的数据获取平台和我们的思路可能类似,但驱动机器人的方法非常不同。举个例子,他们获取人类数据后,会通过解算一些优化问题,使得人类动作可以匹配到机器人上,如果不匹配,还会加一层模型,比如模型预测控制(MPC)去做采样。这样当时的机器人确实能像人一样动,但这些系统缺乏基于学习的控制,所以只能在受限环境下完成一些动作,比如慢慢走路或蹲下,并没有达到更广泛的功能能力,因此后来这些工作没有持续发展。
最近几年,这方面取得了进展。首先是控制方法的改进,强化学习(RL)已经基本可以取代传统控制方法,几乎所有机器人控制都可以用 RL 来实现。其次是硬件能力的提升,五年前很多硬件还做不到,现在硬件不再是限制因素,使我们可以尝试算法的极限。这也是为什么近期大家重新开始投入这方面研究的原因。相比五年前,现在各个模块都有了显著提升,从长远角度来看,这是对过往工作的升级。
在最近两年的工作,比如OmniH2O和HumanPlus和TWIST很相似,但仍有区别。以HumanPlus为例,它的思路大致分三步:第一,获取全身人类数据;第二,做Real time Retargeting,将人类数据转换成机器人数据,通过关节映射实现 human-to-robot transfer;第三,使用 RL 将数据真实地放到机器人上执行。
虽然思路类似,但TWIST的系统在各个环节都做了提升。首先是获取高质量人类数据非常重要,我们使用了世界上最高质量的人体动作捕捉数据,这保证了基础的准确性。其次,如何将人类数据转换为机器人数据也很关键。我们花大量时间调试了实时 retargeting 算法,它可以很好地保留人类动作结构,同时避免出现崩坏或错误的结果。这一步比当时简单的映射方法提升很大。第三,需要一个强大的 RL 控制器,将转换后的数据物理可行地执行出来。因为直接转换的数据并不符合物理规律,例如接触地面、力学平衡等,我们设计了一个两阶段算法:第一阶段使用大量先验信息生成教师数据,第二阶段使用教师-学生蒸馏,同时提出了新的 RL+BC 框架,使控制器能更好地跟踪高质量动作。
总体来说,相比一年前或五年前的工作,TWIST在四个方面对系统进行了全面提升:获取高质量数据、实时高保真 retargeting、多阶段 RL 控制,以及更强大的硬件支持。正因为如此,TWIST的系统能够展示非常令人印象深刻的全身运动效果,上下半身可以协调、自由运动,几乎像真正的人一样,这也是与过去工作的主要区别。
3. 人体动作数据获取都有哪些方案
获取人体数据大概有三种主要方式。第一种是基于相机的视频或图像,比如互联网视频,或者通过图像进行姿态估计。这种方式最大的优点就是便携、便宜、容易获取,但缺点也很明显,就是精度太差,质量最差。第二种是 VR,它比相机贵一些,普通人也不太会买,但它能提供更高质量的上半身数据,缺陷是没有下半身数据。不过有些研究通过让机器人补偿缺失的部分,或者加一些额外输入,比如遥控器来提供下半身位移,从而部分解决这个问题。第三种就是动捕设备,它的优点是精度最高、质量最好,但缺点就是极其昂贵,不具备便携性。
这里有一个很明显的 trade-off:设备越便携,数据质量就越差;设备越不便携,数据就越好。大家都想要更多更好的数据,因为像大模型成功的秘诀就是 scaling up。但要想规模化,就得依赖便携又便宜的系统,否则几十万甚至上百万的设备没人用得起。
所以我尝试过 VR 和基于单目估计的方法,但实际下来感觉都还不足以提供高质量的全身动捕,尤其是在 root tracking 上问题很大。(Root tracking,就是人在世界坐标系里的整体位置和移动,比如从 A 点走到 B 点。)如果只用一两个相机,是很难实时准确地提供全身在空间中的移动轨迹的,最多只能在静止状态下获取上半身的动作。
因此,基于相机的方案几乎可以排除了,只剩 VR 和动捕。近期也有不少工作尝试用 VR 做全身控制,比如 vision pro 的应用就是只给手和头的 tracking 数据,然后让策略去学缺失的下半身动作。结果证明是可行的,但问题是下半身会出现不稳定或持续调整的情况,比如机器人明明走到了目标点,但它的下半身动作还在微调,因为它缺乏真实的下半身输入。
有的研究会额外用遥控器提供 base 的移动输入,有的则通过对齐头部的全局 tracking 来巧妙绕开问题。无论哪种方式,都说明 VR 是可用的,但下半身精细的动作,比如下蹲、跨步、马步等,几乎做不到。
相比之下,我们现在坚持用完整的全身数据来做开发,好处就是一切都能做,但坏处也非常明显,就是只能依赖动捕。动捕既不便携,又昂贵,即使实验室有,使用起来也不如 VR 那么方便。所以我认为未来的关键是如何让这些系统更便携。我也看到一些厂商在尝试,比如欧洲有家公司,他们用一两个相机就能提供高质量的全身 global tracking,如果这种商业化方案越来越成熟,或许未来全身动捕会越来越 portable。
总体来说,我认为不能因为缺乏某些数据就放弃高精度的控制,而是应该尽可能获取更多、更好的数据,把数据做扎实,让整个系统变得更强大。这是我目前的一个核心想法。
4. TWIST方法介绍
在整个方法里,其实可以分成两个阶段。第一个阶段是数据的准备,第二个阶段是控制器的训练。在数据准备这一部分,我们的 training data 主要来自两个成熟的来源:一部分是过往的论文里公开的数据集,另一部分是一个叫AMASS的数据集,这两个都是比较成熟的全身人体动作数据,被广泛用于 motion tracker 的训练。除此之外,我们还额外采集了一小部分 in-house 的动捕数据。之所以要加这部分,是因为我们研究的目标是 real-time control,也就是实时的 motion tracking。
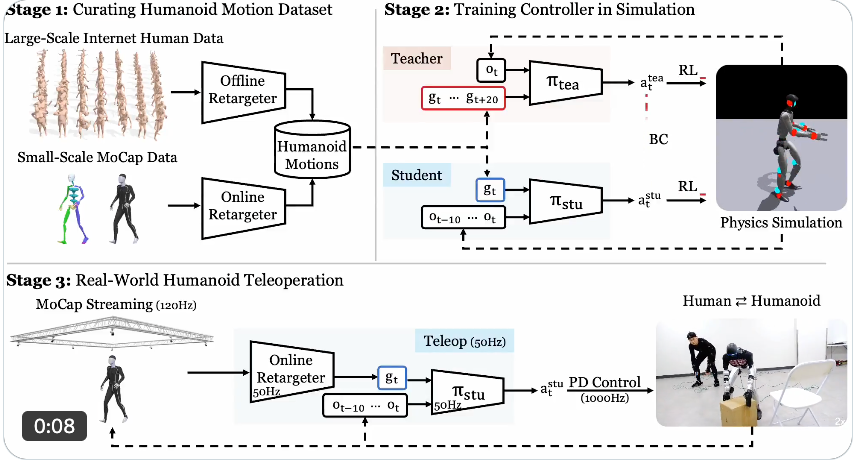
在这之前,其实已经有不少工作研究过 motion tracking,比如跳舞、模仿动作等等,本质上就是给一个 human motion,让机器人去跟踪。但我们发现,如果完全依赖公开数据,controller 的表现并不好,不太能适应我们的任务。原因可能是 motion 本身的质量,也可能是 real-time control 的特性导致的。我们尝试之后发现,只要加上一小部分自己采的 in-house 数据,效果就会明显提升,而且数据量不需要很多,加一点点就够了,多采其实差别不大。因而,这部分内部数据的主要作用在于缩小训练数据与测试数据之间的分布差异。这是我们在数据筛选与整理阶段总结出的一个关键经验。
第二部分是控制器的训练,包含两个部分:RL 和 BC(Behavior Cloning),整个流程比较经典,我们基于开源的 ETH 框架进行修改,使用 PPO 在模拟环境里进行大量 online interaction,通过收集 reward 来训练策略。与之前做走路的工作相比,主要区别在于 reward 的定义以及如何利用训练数据作为 reference motion。
具体来说,每个 time step 机器人都有一个目标坐标系,需要跟踪对应的 motion。如果左手目标在空间中某个点,机器人左手当前位置与目标之间的误差会被转化为 reward,用于 PPO 更新策略。运动跟踪奖励(Motion tracking reward) 的设计非常讲究,可以包括空间位置、旋转,或者局部坐标系下的点和旋转。一个重要结论是,如果缺乏全局信息,就很难实现精确的运动跟踪,控制器的性能也会明显下降。我们将运动跟踪从全局坐标系转换到局部坐标系,这样每一步只关注局部动作,即使上一步偏差了,下一步仍可正常执行,整体效果会好很多。
在这个基础上,我们采用 teacher-student 机制。Teacher 可以访问一些 student 无法获得的额外信息,比如全局位置,用于更好地监督 root tracking 和 rotation tracking。Student 通过 RL + BC 学习,RL能够基于奖励信号进行监督学习,让 student 根据奖励自主调整行为,BC 则作为辅助监督,帮助 student 模仿 teacher 的动作,但不会强行执行每一步动作,从而避免因行为不一致而导致的不稳定或倒地。
此外,在 teacher 端我们还加入了未来 motion 信息,这部分在 student 端不可用,但可以利用 offline 数据集提供给 teacher,以提升指导效果。整体上,RL + BC 框架能够在 online control 任务中保证策略的适应性和稳健性,即便环境或动作出现意外偏差,机器人也能保持合理行为。
在第三步的操控过程中,其实涉及一些真实世界的小设计。整个推理流程是这样的:首先从动捕系统获取人体数据,然后通过然后通过重定向将人体数据转换为类人机器人的整体运动,再通过控制器将这些指令性动作(command motion)转化为机器人实际的动作。这是整个流程的核心,但在真机操作中,会有一些小细节需要处理。
第一个小设计是如何让机器人安全地站立或处于安全状态。穿动捕服的时候,有时你可能想暂时停止控制,例如去上厕所,这时机器人不能一直处于完全受控状态,因此需要退出机制。最笨的方法是关机或手动挂起机器人,但这样下次使用时需要重新启动,非常不便。
为此,我们加了一些辅助装置,比如“手持手柄”,在穿动捕服的过程中,手上握着手柄作为系统的开始和结束控制。例如,当我想结束或暂停控制,让机器人保持站立时,按下手柄上的按键,机器人会进入默认站立姿势,同时停止接受动捕信号,只输出默认的控制指令。这样机器人就安全地站立,我也可以脱手或去做其他事情。
我觉得这个设计非常重要,因为很多人做机器人控制时,只关注中间动作的控制,而忽略了完整的用户体验,包括开始、暂停、继续和结束的连续过程。在成熟的人形系统中,这类设计很常见。例如像 Aloha 的系统,国内一些公司在做类似系统时,也会考虑用户可以随时暂停操作,然后继续时无缝接续数据。
5. 关于Retargeting
公开的动捕数据集和我自己采集的数据集在做 retarget 的时候会遇到很多问题,比如需要大量标定,不同的人穿动捕服可能还需要重新标定,效果也不一样。做 retarget 的时候精度和映射过程中也会出现各种问题。我在从公开数据集到自己穿的动捕服做 retarget 的过程中,首先方法是这样的:这两部分数据的表示形式基本一致,主要把它们作为 3D 空间中的点来使用,每个点有位置和方向,这种表示方式可以通用地从各种动捕数据中提取出来。人体可以理解为由很多骨头和关节组成,每个部分近似为一个刚体,有空间中的位置和旋转量。通过这些描述,就能近似还原一个人体。无论是我自己的数据还是网上的公开数据,最后都可以统一成这种数据格式。
有了这样的表示之后,接下来说怎么做。一般来说,offline 的流程是先人为地建立一个映射关系,把人和机器人各个 body 对应起来。有了这个映射关系之后,就可以利用机器人的运动学或动力学去满足人的关键点约束,比如胳膊在空间中的位置和旋转。这样做的结果就是机器人会表现出与人类似的动作。这基本上就是 retargeting 的过程:把人体的二三十个 body 做好 mapping,然后用机器人的动力学去实现,得到一个看起来跟人差不多的动作。
offline retargeting 和 online retargeting 的区别主要有三点。第一点是优化目标。offline 通常只优化关键点的空间位置约束,并不直接管旋转,因为当位置约束足够多时,旋转就会间接得到保证。但在 online 的时候,我会使用更多的旋转约束。第二点是 smoothness。offline 可以在 trajectory 层面加平滑约束,比如 100 帧每帧独立算出来会抖动很大,但加了 smoothness 后整体就会很丝滑。而 online 虽然也能用历史帧来做平滑,但会导致反应变慢,比如动作只能跟到 0.7 或 0.8,这样就带来延迟,不是好事,所以我在 online 时没有加这个部分。第三点是方法不同。offline 用的是 FK(Forward Kinematics),可以不断 sample,用 gradient-based 的方法算,因为不在意速度。而 online 我用的是 IK(Inverse Kinematics),直接通过 solver 算结果,满足实时性。FK 和 IK 在思路上类似,但一个更适合离线优化,一个更适合实时推理。
整体来说,retargeting 的核心就是统一数据表示、建立人和机器人的映射关系,然后根据 offline 或 online 的需求选择不同的优化目标和方法。
第一点区别主要在于优化目标。在 online 的时候,我们用了更多的旋转约束,而不是像 offline 那样主要关注位置约束。原因是不同人穿动捕服时高度、体型各不相同,每个部分尺寸也不太一样。如果只用位置约束,得到的结果可能会非常奇怪。比如今天一个人穿动捕服做 retarget,按照之前配置好的参数去映射胳膊位置,但第二天换了一个体型或者服装穿法略有不同,结果就会不一样,看起来和印象中的动作差距较大。而使用旋转约束,这个问题就没有那么明显。
旋转相比位置来说更稳定,不容易受到个体差异和配置变化的影响。不过它也有一些问题,比如不容易对齐或者存在其他误差。但总的来说,在 online 时使用旋转约束能减少因为体型和服装差异带来的偏差,因此我们选择在线 retarget 时更多依赖旋转而不是大幅度位置约束。这也解决了不同人穿动捕服时不需要每次都重标定的问题。
至于其他类似的工作是否也使用旋转约束,我了解的不太多。有一篇我们最近做的 cross mission 工作使用了旋转约束(即GMR),但在其他以前的工作中,大家探索的更多是角色动画的视觉效果如何更逼真,而不太涉及在线满足实时约束的问题。总体来说,核心目标都是让动作达到该到达的位置,只是在线场景会有更多现实世界的噪声需要考虑。
第二点区别主要在于轨迹层面的信息处理。offline 的部分更多是提供一些 trajectory-level 的信息,让整个动作看起来顺滑。可以理解为 offline 更像是用来做一些预处理或预训练,而 online 则是用来实时反应和控制动作。虽然严格来说,offline 并不是传统意义上的预训练,它和 online 是在同一个训练框架下,只是 offline 可以提供一个更平滑的初始动作参考。
在实践中,不同数据源的作用也有所不同。比如AMASS数据可能更侧重提取某一部分信息,而自己采集的动捕数据可能更侧重另一部分信息。此外,IK 和 FK 是两种实现 retarget 的方式。IK 是通过逆运动学计算机器人应如何移动以达到目标位置,可能需要迭代处理误差;FK 则通过前向运动学采样,并使用可微分 FK 去计算目标状态。这两种方式都是比较常见的解决方案。
Retargeting 的本质是处理多个关键点的映射和控制。与机械臂不同,机械臂通常只有一个末端,而人体可以看作有二三十个“末端”,包括所有关节和骨骼。因此算法需要同时考虑所有这些末端的约束。总结来说,retargeting 包含两件事:第一,把要映射的部分映射到目标位置;第二,当映射完成后,计算机器人如何移动才能达到这些目标。
6. 关于GMR
GMR 并不是开源原始数据,而是开源了把人类数据映射到机器人数据的过程。简单来说,就是把 retargeting 的方法开源了。对于整个社区来说,这个开源非常有帮助,比如其他人的机器人可以直接用这套 GMR 流程,实现自己的动作映射。
GMR 是一套比较通用的流程,我们已经把一些市面上常见的机器人加入进去,因为很多人会发邮件问能否支持特定机器人,我都帮他们加进去了。我觉得这算是跨本体智能应用的一个重要进展。做跨本体映射,首先需要有统一的数据表示,这样才能把数据整合好,再应用到不同的机器人上。人体是一个很好的媒介,只要能把人体映射到目标机器人,就能利用人类数据作为数据源,这也是 GMR 最大的意义所在。
在 GMR 中,映射过程也包括了前面提到的第一阶段的 offline 和 online 两部分。它提供了一个完整的算法框架,其他人可以在这个基础上做进一步的工程化,这对更多机器人本体公司来说意义很大。TWIST的发布可以让大家在自己的机器人上复现,实现 human-like 的全身动作控制,同时也能推动具身智能人形机器人方向的数据应用向前发展。
目前整个领域还没有形成共识,尤其是在 human-robot 的交互和动作控制方面,大量方法和流程都不是标准化的。比如很多人使用 VR 控制机器人,这是很好的尝试,但如何真正摇动控制机器人,还没有统一的方法和共识,仍然是一个探索中的领域。
7. 使用MoCap遥操的注意事项
在操控过程中,作为操作者,你的动作是有一些关键点的,但我们并没有使用操作者的数据来进行自主训练,更多的是展示方法。从操作者的角度来看,你可能会觉得需要放慢动作或者适应机器人的结构,但实际上不需要做过多适应。机器人比想象中更容易操控,因为它的控制方式和人的动作高度一致。
有一个例子可以说明这一点,我们尝试过一套给新手操作的系统。它使用双臂外骨骼和一些按钮来控制机器人的腰、前后移动以及抓手等动作,总共有 5 到 8 个按键。我自己尝试后发现,整体控制比想象中简单得多。当我们把 human data 直接作为接口去控制机器人时,它的自然映射让操作非常直观:你抬腿,机器人也抬腿,这让新手上手很快。
如果使用传统分开的控制器,比如单独控制腰或下半身,你每次做完一个动作都需要切换控制器,或者需要额外的助手配合,这会让动作非常不连贯,而且需要大量练习才能熟练操作。而全身遥操作系统则不同,上手难度低,而且更自然、连贯。
之前在 5 月份,我们还遇到一些问题,当时 retargeting 和数据流传输有延迟,导致操控体验不够顺畅。但这些问题目前已经得到改善,系统现在可以提供更实时的反馈,使操作感觉更加舒适自然。
我觉得到目前为止,主要的 take away 是搭建这套系统不仅仅是为了让机器人动起来。让机器人动起来只是一个简单的目标,下一步是让大家都能高效地采集数据。也就是说,我希望这套系统真正成为一个工具,让用户能够直接使用它,而不是每次都去手动操作。目前我们只是走了第一步,距离最终目标——让系统真正易用、高效的数据采集工具——还有一定距离。
References:
TWIST Project Page
迮炎杰主页
开源项目:
https://github.com/YanjieZe/TWIST