在Robot Foundation Model(RFM)系列第一期RFM EP01:Pi和π0具身基础模型,我们通过Sergey在CoRL 2024的两个Talk了解了美国具身智能独角兽PI推出的机器人大模型π0。作为RFM的第二期,我们会关注更早一个版本的机器人大模型Octo,以及从Octo到π0的优化过程。
这篇文章是Octo和π0的一作Kevin Black在CoRL 2024,the 1st Workshop on X-Embodiment Robot Learning workshop上题为“From Octo to π0:How to Train Your Generalist Robot Policy”的报告。
这个报告深入浅出的介绍了Octo的成功与失败,以及π0如何在Octo的经验基础上进一步提高。非常难得的一点是,Kevin不吝将他在这两个机器人模型工作的失败经验分享出来。除了详细的介绍了Octo,Kevin也提到了π0训练的一些独到经验。
值得注意的是,这篇文章主要来自于Kevin Black报告的翻译总结,关于他表述的一些细节,我也有很多不理解的地方,所以如果你在阅读文章的过程中,看到一些事实错误,欢迎在文末留言纠正。
查看原文目录
以下为本文目录
👇
1. Octo的提出
2. Octo模型设计
3. Octo模型评估
4. Octo的效果
5. Octo值得借鉴的经验
6. Octo的一些问题
数据
模型设计
7. 在Octo基础上π0如何改进
扩展模型的规模+改进预训练
改进Decoder
解决分布漂移问题:Action Experts
训练与结果
π0有效吗?
1. Octo的提出
Open X Embodiment 数据集,很多领域的人可能都已经听说过这个数据集。它在一年前发布,对于机器人学者来说,这是一项巨大的里程碑。这个数据集的规模远超我们之前使用过的任何数据集,涵盖了来自 21 个机构的贡献、22 台机器人产生的数据,总计约 4000 小时的记录活动。在数据驱动的机器人学中,最关键的因素就是数据,而这个数据集提供了我们一直在等待的数量和多样性。
谷歌并没有止步于此——他们还发布了使用这个数据集的令人印象深刻的成果,他们的模型 RT-2,使用 Open X Embodiment 数据集进行训练,在不同实验室和任务之间表现出了令人瞩目的泛化能力。这是一项不可思议的成就。当我第一次评估这个模型时,我曾经说过“它不可阻挡”,这是 Sergey 喜欢在所有幻灯片中引用的句子,虽然这让我一直很尴尬。
然而,如果我对RT-2提出批评,唯一的问题就是那个“550亿”——指的是它使用的语言模型的规模。这个数字带来了两个重大问题。首先,它使得这个模型本质上成为私有的,这意味着它不太可能被开源。其次,即使它开源了,大多数机器人学者也没有资源来部署,更不用说训练如此庞大的模型了。我们大多数人不习惯启动足够的GPU来处理如此庞大的计算量。
仅仅为了在一个 550 亿参数的模型上进行推理,就需要足够的GPU,更不用说训练了,这可不是一件小事。谷歌确实发布了一个名为RT-1的较小模型,但它也有自己的局限性。例如,训练基础设施并没有开源,并且它并不特别适合微调。
就在这个时候,我和一些在 Berkeley 的朋友看到了一个机会。我们想:“为什么不自己用这些惊人的数据训练一个模型呢?”这个想法并不新颖——其实也没什么深奥的,但值得一试。于是,我们开始了一个叫做 Octo 的项目。
Octo 的主要目标是灵活性。正如我们所知,Cross-Embodiment Learning需要在多种系统和任务中具备适应性,我们希望确保我们的模型能够支持这一点。项目的另一个基石是将整个基础设施开源。这是我们的一大创意:创造出真正能被人们使用的东西。对于很多人来说,这将是第一次直接使用一个在如此大规模、多样化数据集上训练的模型。
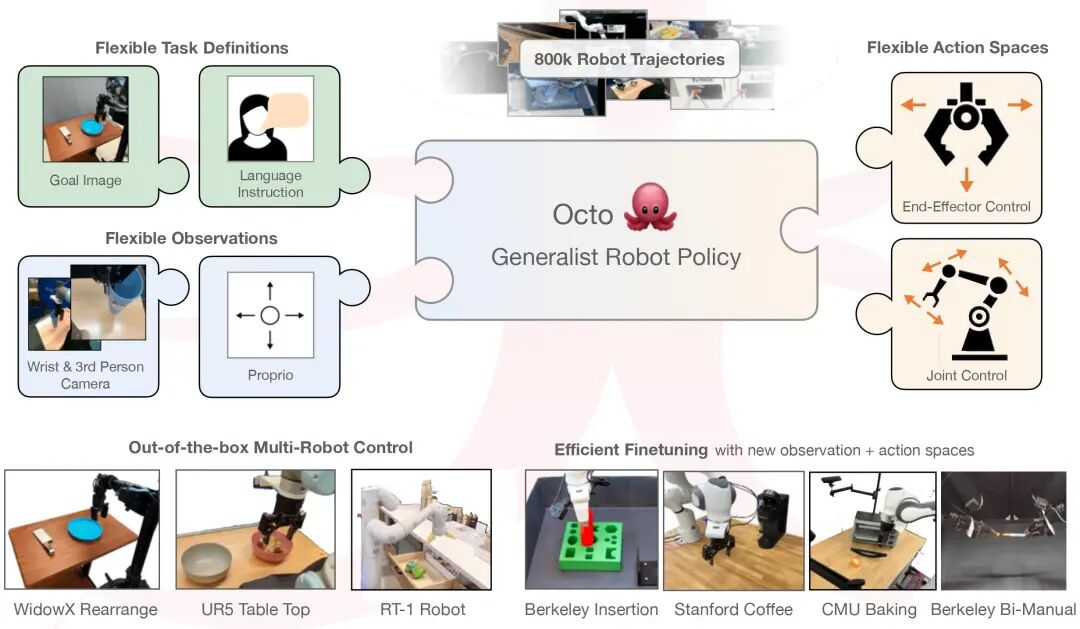
我们希望人们能够真正使用这个模型——这就是我们的核心想法。有一个类比提到,Octo 就像机器人领域的 GPT-2。如果你不熟悉,GPT-2 是一个相对较小的模型,虽然它对于zero-shot 任务并不特别有用——它能生成连贯的内容,但仅此而已。然而,它对于微调非常有用。GPT-2 有大约 1 亿个参数,你可以轻松下载并微调它,应用到生成诗歌等任务上。
Octo 的理念大致也是如此。它可能有些雄心勃勃,但我们的希望是,如果人们能够使用它并取得良好的表现,它将像 GPT-2 对机器人领域的贡献一样,具有类似的实用性。
2. Octo模型设计
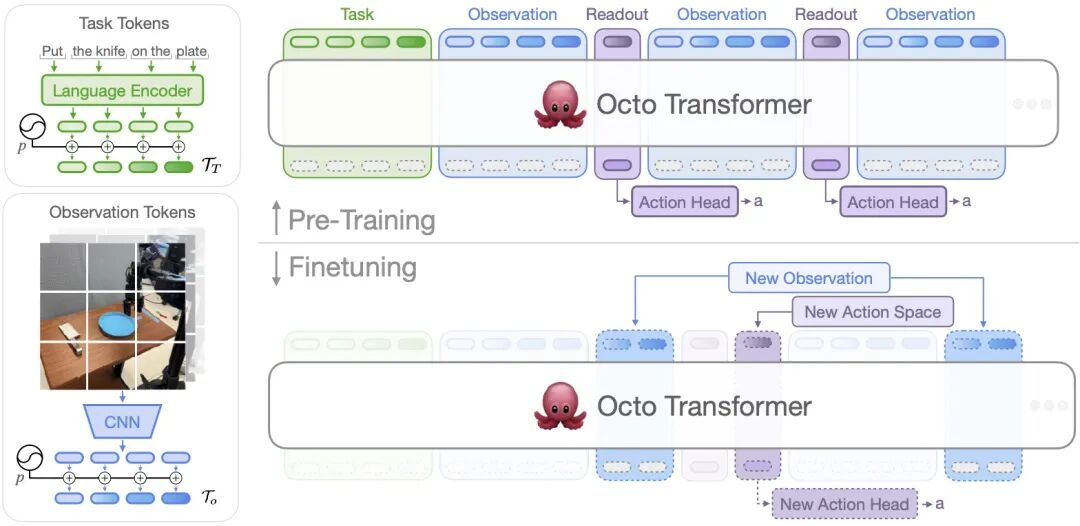
Octo 的设计并不复杂。它基本上是一个大 Transformer。包含一个language encoder处理语言指令,observation encoders处理传感器输入和其他观察数据,然后一切都输入到 Transformer 中。主要创新点是action heads——这些小模块,如 MLPs,用来输出动作。这个设计旨在增加模型的灵活性。如果机器人有一个不在预训练数据中出现的动作空间,你可以简单地替换掉action heads。我们的想法是,尽管action heads会发生变化,庞大的共享encoder仍然能够提供知识转移,而action heads则能轻松适应新的动作表示。
3. Octo模型评估
我们进行了很多评估。对于微调,我们在具有新动作空间的任务上进行了实验,例如 Berkeley Pickup 和 Berkeley Bimanual。这些动作空间在预训练数据中没有出现。预训练使用的是经典的末端执行器位置控制,而这些任务涉及的是关节位置和关节扭矩。
我们还进行了zero-shot 评估,意味着没有微调,而是直接在训练数据中出现的场景上测试。这并不是为了展示泛化能力,而是为了确认模型能够适应它在训练时见过的数据。
我们付出了很多努力让 Octo 更易获取,我们发布了开源代码库;提供了完整的基础设施,包括数据加载器。
4. Octo的效果
那么,它有效吗?人们真的在使用 Octo 吗?嗯……算是吧。但并不是为了微调。大多数人将它作为基准进行对比。坦白说,这也没关系。这仍然是一种影响力,表明我们让系统足够简单,便于人们进行推理。
但如果说实话,人们并没有真正使用 Octo 进行微调,因为它的表现并没有那么好。微调带来的性能提升不足以弥补投入的努力。格式化数据、设置训练基础设施和学习如何使用——这些都需要付出努力。而微调 Octo 所带来的收益并不足以让这些努力变得值得。
在很多方面,Octo 是失败的。我们没有取得我们所期待的突破性成果。但这并不意味着它在各个方面都是失败的。在谈论哪里出了问题之前,我想先花点时间反思一下,我们做对了什么,和在这个过程中我们学到了什么。
5. Octo值得借鉴的经验
我们学到的一件事是,扩散模型(diffusion)非常有效。在我们开始做这个项目时,扩散策略(diffusion policies)已经相对为人所知,但对我个人来说,这个项目真正让我深刻理解了这一点。一开始什么都不行,但在截止日期前大约两周,我们添加了一个diffusion head——突然间,一切开始顺利。这次经历加强了扩散(diffusion)在数据扩展(scale up data)过程中尤其有用的观点,这可能是因为它能很好地处理多模态数据。
另一个重要的启示是action chunking(动作分块)。这并不是一个新想法——像diffusion policy和 ACT 这样的方式,已经使用了某种形式的action chunking。然而,这个项目让我深刻意识到它的重要性。在Berkeley,我们传统上没有在某些任务中使用action chunking,但我们发现,当action chunking的大小在半秒到一秒之间时,性能显著提高。
还有一些看似平凡但同样重要的经验教训——这些东西可能不够光鲜亮丽,不值得写进论文,但在训练这些模型时却至关重要。例如,数据洗牌(shuffling data)证明是极其重要的。机器人学数据有一个不幸的特性——它们高度相关。每条轨迹与自身显然高度相关,甚至同一场景的轨迹也常常非常相似。如果没有适当的洗牌,损失曲线的改善将不如预期。我们是在试错中学到这一点的。一旦我们更有效地进行了数据洗牌,性能得到了显著提升——有时甚至翻倍。
另一个看似微不足道但影响深远的细节是动作表示(action representation)。如何表示gripper的状态?是绝对位置还是相对位置?对于关节,使用位置、增量位置还是扭矩?对于末端执行器控制,使用什么参考框架?这些问题可能看起来微不足道,但它们实际非常重要,尤其是在cross-embodiment训练中。在 PI,我们花了无数小时讨论这些问题。看起来这些问题随着数据规模的扩大可能会变得不那么重要,也许将来是这样,但目前这些细节差异很大。
6. Octo的一些问题
现在,谈谈为什么 Octo 没有成为机器人领域的 GPT-2。我要把问题分为两大类:数据和设计。
数据
在数据驱动的机器人学中,数据始终是最重要的因素。这一点在更广泛的机器学习领域也是如此。关于数据已经有很多讨论了,所以我决定采取一种独特的方式来阐明这一点。我做了一件有些傻的事情:我尝试将文本数据集转换成“小时”,以便与机器人数据集进行比较。
如果你将平均人类阅读速度与文本数据集中的标记数相乘,你可以估算一个普通人阅读完这个数据集所需的时间。例如,GPT-2 的训练数据集,在当时被认为是一个较小的数据集,但它的规模远远超过了任何机器人数据集。
需要明确的是,这种比较有很多局限性。数据集的多样性和质量远比数据的原始大小更为重要,但我认为这个练习仍然突出了一个关键点:我们在机器人学中拥有的数据远远不够。即使是我们现在认为相对较弱的 GPT-2,它在训练时也接触到了比任何机器人模型现在所能获得的更多的数据。
在 Octo 开始时,我们高估了 Open X Embodiment 数据集的规模,认为它非常庞大。但实际上,它与语言数据集相比仍然很小。即使在 PI,我们全天候收集数据,至今也只有大约 10,000 小时的数据——这几乎只是语言模型数据的一小部分。做个对比,现代语言训练数据集包含大约 7.9 亿小时的数据。为了说明这一点,我做了一个图表,展示了它们之间的规模差异,真是令人震惊。
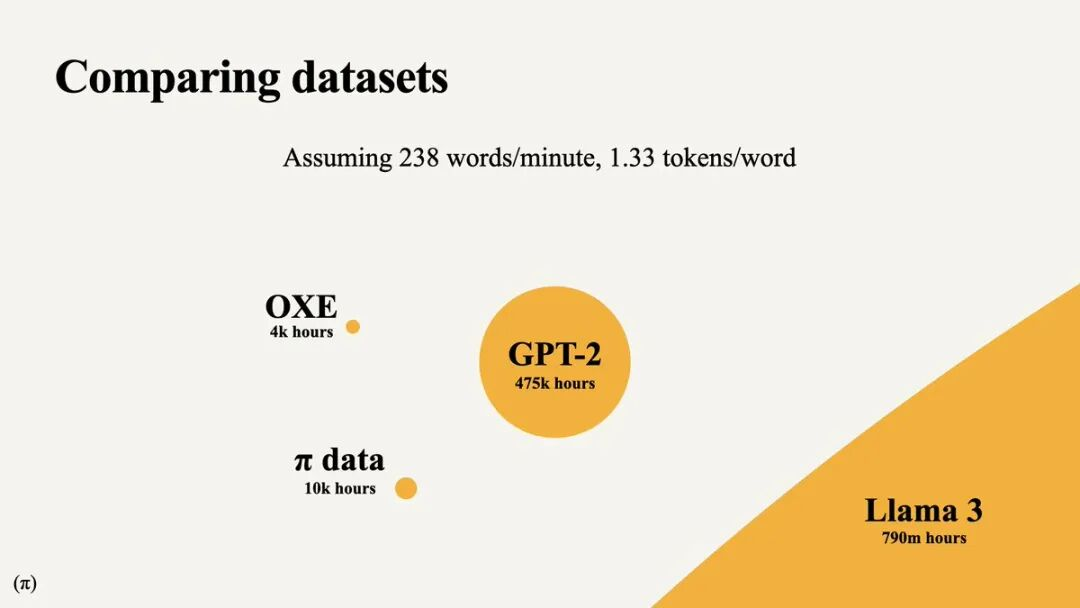
这个比较并不是说我们永远无法在机器人领域达到这样的数据量,但它确实意味着我们需要调整预期。我们不会看到像语言模型中那样的涌现性质,因为我们根本没有足够的数据量、数据多样性或状态空间的覆盖。
设计
虽然数据是最重要的因素,但设计同样非常关键——尤其是在我们扩展规模时(scale up)。如果我们假设机器人数据集会随着时间增长,那么探索合适的设计以及它们如何随着更多数据的引入而扩展,仍然是非常有价值的。
我们在 Octo 中犯了一个大错误,就是没有使用视觉预训练。这与数据密切相关,因为利用大规模的互联网数据集是克服机器人数据集局限性的一个有效途径。在 Octo 中,我们自认为 Open X Embodiment 数据集已经足够大,所以没有对observation encoder进行预训练,只对语言编码器进行了预训练。结果证明这是一个错误。即使是在相对较大的数据集上,视觉预训练也能带来巨大的改进。
在 PI,我们早期进行了一些内部实验,甚至在 ImageNet 或类似数据集上进行简单的预训练(例如,使用 ResNet 或 ViT),也显示出显著的性能提升。这并不是关于泛化能力或抗干扰能力,而仅仅是提高了训练数据中任务的表现。预训练带来的帮助远远超出了我们的预期。
另一个问题是与action head(动作头)相关的。最初的设计是将action head做得很小——占总参数的不到 5%,这样更换新的动作空间时不会丢失太多信息。然而,这证明是一个问题,尤其是在使用基于扩散的目标(diffusion-based objectives)时。随着数据变得更加多模态和复杂,需要一个更大的解码器来有效捕捉数据分布。在 Octo 中,庞大的 Transformer 在单次前向传播中处理输入,而action head (或decoder)则在去噪过程中进行了多次前向传播。更强大的解码器会更适合处理复杂的分布。
我们遇到的另一个问题是高频控制设置,例如当时越来越流行的 ALOHA 类型配置。这些设置建议将动作块大小设为 50 或更多,但 Octo 无法处理这些设置。损失值没有下降,甚至无法拟合数据。在 Octo 发布后,我加入了 PI。在我的第一周,我提出了一种新的架构。这个架构与 Octo 相似,但具有一个显著更大的解码器——大约占总参数的 30%,并且可能在计算成本上占据更大的比例(虽然我没有计算具体数字)。
这个架构仍然基于 Transformer,因为我们知道 Transformer 非常有效,所以没有理由不使用它。该设计受到了“Diffusion Transformer”论文的启发,这篇论文在计算机视觉领域取得了很大的成功。此外,我们通过使用 ImageNet 对视觉骨干进行预训练,解决了预训练的问题。
这个架构表现得非常好。在π0论文中,这个版本被称为“π0 Small”,但从时间顺序来看,这个模型是在 Octo 之前的,我们在扩展之前使用了它很长时间。它的表现异常出色。有趣的是,几乎完全相同的架构也被其他几个项目独立开发出来,例如 ALOHA Unleashed和 DIT Block Policy。多个团队的尝试说明这是一个非常强大的设计。
7. 在PI Scale Up—π0如何改进
扩展模型的规模+改进预训练
在此之后,我们在 PI 的下一个目标是通过两个方面来推动进展:(1) 扩展模型的规模和 (2) 改进预训练。虽然 ImageNet 预训练确实有帮助,但我们很快意识到,使用VLM模型作为骨干网络——即我们现在所称的VLA——会更加有效。其基本思想是,利用一个VLM,并对其进行微调,以输出动作。这种方法已显示出巨大的潜力。
为了在保持扩散目标和整体设计的同时,将现有架构转变为 VLA,我开始进行一些简单的修改。首先,我用一个语言模型替换了原来的大 Transformer 编码器,如GLaM。其次,我将视觉骨干网络升级为更强大的模型,如 SimCLIP。
通常,VLM使用的是decoder-only Transformers,因此语言输入通过cross-attention 和 self-attention mechanisms进行添加——这是VLM研究中的常见做法。此时,模型看起来类似于 PaLM-E,它将 SimCLIP 视觉编码器与GLaM结合起来。PaLM-E 是由 Google 开发的一个优秀模型,专门设计用于在新任务上进行微调。
我们将这种方法集成到现有架构中的初步尝试涉及使用相同的解码器,但将编码器替换为 PaLM-E。它的表现还可以——能够拟合数据,但并没有比我们之前的小模型好多少,而且存在一些问题,比如偶尔的损失不稳定。我尝试了许多修复方法,例如冻结编码器或对编码器使用较慢的预热,但都没有取得很好的效果。
那时,我意识到问题所在:GLaM 是一个decoder-only Transformer,但我们将它当作encoder使用。问题出在其架构上。decoder-only 模型的最终层经过自回归目标训练,并不设计用来生成丰富的表示——它优化的目的是预测下一个token。从理论上讲,如果模型经过完美训练,最终层只会告诉你下一个词,并不会携带有意义的上下文表示。
下一步:改进Decoder
为了解决这个问题,下一步的逻辑是确保Decoder能够从语言模型的每一层获取表示(Representation),而不仅仅是从最后一层。这一改变使得整个系统看起来更像是一个大Decoder。观察输入(如图像)被送入模型,同时动作输入也被加入。
新架构的一个显著特点是将原本的encoder和decoder之间进行了分离。在推理过程中,我们通过encoder部分进行一次前向传播,然后在去噪过程中通过decoder部分进行多次前向传播。为了提高效率,我们使用了 KV 缓存,这使我们能够存储来自encoder的键和值。因此,解码器的计算速度大大提高,因为它不需要重新计算整个前缀的注意力层。
这个设计与“Transfusion”论文中提出的某些概念非常相似,这篇论文大约在同一时间发布。当我看到那篇论文时,我想:“哇,他们有同样的想法!”这通常是判断一个概念好坏的标志——它在不同团队之间产生共鸣。
新的架构比前一个版本表现得要好得多。它在泛化能力上有所提升,特别是在利用VLM预训练时。例如,它能够识别一些之前没有见过的新物体,并展现出较强的鲁棒性。得益于扩散目标,它还能够处理高频控制任务。
然而,仍然存在一个主要问题:收敛非常缓慢。训练时间远比预期要长。我的假设是,这与分布漂移(distribution shift)有关。VLM 的预训练只见过某些类型的输入,因此在微调过程中引入未初始化的线性投影层可能会使模型产生困惑。
解决分布漂移问题:动作专家(Action Experts)
为了解决分布漂移问题,我提出了一个灵感来自专家混合架构的解决方案。核心思路是为新的输入使用不同的权重。概念上,你可以将其视为一个 Transformer 序列,其中不同的 token 使用不同的权重集合。例如:原始输入(例如来自 PaLM-E 的视觉和语言)将使用预训练的权重,保持与模型在预训练期间所见的一致性。新输入(例如机器人状态和噪声动作)将使用一组新的权重,从头开始初始化,以避免分布漂移。
这种分离也使我们能够优化效率。由于自注意力层是共享的,我们可以大大缩小新部分(即“动作专家”部分)的 MLP 块。这节省了参数,减少了训练时间,并大大加快了推理速度,因为动作专家部分在去噪过程中会多次运行。
结果非常有希望。不仅训练变得更快,模型的收敛性也得到了显著改善,导致了更高的性能。这种架构最终成为了π0模型,如我们在π0论文中所描述的那样。唯一的不同是,发布版本中的插图更精美。
π0有效吗?
我们在多个数据集上训练了π0模型,包括所有 PI 数据、OXE 数据集和来自 PaLM-E 的互联网规模预训练数据。它在多个机器人平台上同时进行了微调,展示了其在不同形态和任务上的灵活性。
最大的问题是,π0是否可以被视为机器人领域的 GPT-2 —— 一个尽管不完美,但具有高度适应性和可用性的模型。结果显示,尽管π0取得了进展,但它还未能达到像 GPT-2 那样的变革性水平。
一个突显持续挑战的例子是微波炉任务。有趣的是,在这个任务中,从头开始训练的模型始终优于预训练模型。我们猜测这是因为预训练数据中的某些不理想动作导致预训练模型产生偏差,进而使其在任务过程中“卡住”了,而从头开始训练的模型没有这个偏差。
机器人学非常复杂,评估也可能受到噪音的影响。这些结果表明,仍有很多工作要做,尤其是在理解如何充分利用预训练和后训练范式方面。虽然π0不完美,但它能够执行一些令人印象深刻的任务,其中许多任务是全新的(预训练数据中没有出现过的),并且只需要几小时的微调就能掌握。
References:
the 1st Workshop on X-Embodiment Robot Learning workshop, CoRL 2024.
https://www.youtube.com/live/ELUMFpJCUS0?t=16866s