在机器人基础模型(Robot Foundation Model,RFM)系列,我在RFM EP04:Pi0 vs Helix vs GO-1三类VLA模型框架对比解析总结了以π0为代表的VLA模型结构,在RFM EP01:Pi和π0具身基础模型根据Sergey的Talk总结了关于π0的总体思路和介绍。
今天介绍的Hi Robot是PI在2025年2月末公布的一个工作,它的核心思想是让机器人能够“思考”复杂的指令、反馈和插话。大家都知道VLM可以直接控制机器人,但如果指令太复杂,机器人无法直接理解和执行怎么办?Hi Robot就是用于解决这个问题。我也非常荣幸的邀请到Hi Robot: Open-Ended Instruction Following with Hierarchical Vision-Language-Action Models(基于层级视觉-语言-动作模型的开放式指令跟随)这篇工作的一作史潇洋博士进行访谈。
史潇洋是斯坦福大学计算机专业的博士生,导师是 Chelsea Finn,同时也是 Physical Intelligence(PI)的研究员。此前,她曾在 NVIDIA Research 与 Yuke Zhu 和 Jim Fan 合作工作。她在南加州大学(USC)获得了计算机科学学士学位,导师是 Joseph J. Lim 和 Youngwoon Lee。史潇洋的研究兴趣广泛集中在机器人学习领域,研究目标是打造能够自然完成复杂、长周期任务的通用机器人。
关于π0,相信大家在科技媒体上经常会看到诸如“对标π0大脑”之类的字眼。有些PR文,我深度看完之后会非常困惑,这些创业公司PR的业务和π0并没什么相关性。在阅读今天这篇科普博客之前,各位读者可以思考一个问题:你们理解的π0这类VLA是更偏向High-level policy还是low-level policy?对应到国内的说法是更偏向大脑还是小脑?
查看原文目录
以下为本文目录
👇
1. 关于Hi Robot
2. Hi Robot和π0解决问题的差异性?
3. π0的指令和Hi Robot的指令有什么异同?
4. Hi Robot和直接接入一个VLM有什么区别?
5. 为什么Hi Robot指令理解比VLM做得好?
6. 怎么解决grounding的问题
7. VLA和RL怎么结合?
8. Hi Robot方法介绍
9. 关于π0的数据问题
10. 怎么理解High-Level Policy的训练过程?
11. 怎么理解第2步数据生成VLM
12. Hi Robot使用的数据是怎么构建的
13. Hi Robot模块对VLA是必须的吗?
14. 实时交互场景Hi Robot是必需的吗?
1. 关于Hi Robot
在进入采访内容之前,我们可以先从PI的官网了解一些关于Hi Robot的总体介绍。Hi Robot的初衷是为了让机器人在面对复杂任务时,也像人一样“思考”,有个小声音在脑中指导它下一步该怎么做。Hi Robot将VLA(如 π0)整合进一个两层的推理流程中。π0是反应快速、执行动作的“S1快系统”,而高层的VLM则扮演“S2慢系统”的角色,负责思考和语言理解,通过“自我对话”的方式,把复杂任务拆分成简单的中间步骤,再交给π0去完成。
Hi Robot视频介绍
Hi Robot这个high-level policy是一个VLM,实际上它使用的VLM骨干网络与π0完全相同。它被训练用于处理复杂的指令提示、观察场景,并将任务拆解为π0能理解的小任务,以“耳语”的方式逐步向π0 VLA模型下达具体操作(例如:“拿起一片全麦面包”)。这个高层策略还能够融入实时的上下文反馈。
更重要的是,VLM 是用大规模互联网数据训练出来的,它本身就擅长根据图像和语言上下文生成文字,比如回答“机器人接下来该抓哪个物体”。Hi Robot 利用了这种能力,相当于让机器人具备了“看图理解人说话”的基础常识,不完全依赖自己过往的动作经验,也能像人一样,调动外部知识去做任务。
2. Hi Robot和π0解决问题的差异性
π0是PI开发的一个低层策略(low-level policy)模型,其核心功能是直接生成机器人的控制动作,即动作轨迹,使机器人能够在真实世界中与多种物体进行交互。例如,它可以操作一件 T 恤并将其折叠完成,具备实际执行复杂操作的能力。在π0的设计中,我们重点强调了
dexterity(操作灵巧性)。
同时,π0也具备一定的语言理解能力(language following),可以根据用户的自然语言指令执行任务。也就是说,用户发出指令后,系统能够“听懂”并完成操作。然而,这种语言理解能力存在限制:它只能执行那些在训练数据中出现过、模型已经学习过的任务。比如,当用户说“叠衣服”时,机器人只能按照它训练中学到的方式、在相似环境下、对已知类型的衣服进行折叠。此外,模型所能理解的语言也仅限于一个相对封闭、有限的词汇集合,即训练语料中出现过的词汇或句式。
我们也讨论到在实际应用中的“落地问题”:当机器人部署在真实环境中时,用户的语言表达往往是开放的、自然的,而非严格受限于训练数据。比如,家中长辈可能会对机器人说:“帮我把这杯水端过来。”这类指令可能从未出现在模型的训练数据中,因而系统无法理解。
为了解决这一问题,我们在 Hi Robot 项目中提出了一个目标:构建一个支持开放词汇指令(open-vocabulary instruction)的机器人系统。这个系统允许用户使用任意自然语言表达指令,包括模型未见过的表达、复杂的长指令等。核心机制在于引入一个高层策略(high-level policy),它能理解人类语言,将其转化为机器人能够执行的中间表示,再交由π0这样的低层策略(low-level policy)生成具体动作,从而在真实世界中完成任务。
这种架构的优势主要体现在三个方面:第一,他显著提升了人机交互的通用性,使非专业用户也能够自然指令机器人;第二,系统具备了一定的语言推理能力,可以在语言空间中进行更复杂的理解与转换;第三,在训练阶段具备更强的任务泛化能力,能够在多任务间实现知识共享与迁移学习。
3. π0的指令和Hi Robot的指令有什么异同?
举个例子,比如在π0中,如果我们想让机器人制作一个三明治,输入的指令通常是类似“拿起一片面包”这种格式化的操作指令,它必须是明确、具体、结构化的动作描述。
但在 Hi Robot 中,情况就不同了。你可以直接对机器人说:“我是一个素食主义者,你帮我做个三明治吧。”系统会推理出,“你是素食主义者”意味着桌上的肉类不能被使用。你还可以说:“我对某种食材过敏。”它就能理解并排除相关食材,不会将它们用于制作过程。
只做素食三明治
换句话说,Hi Robot 能够理解更自然、更复杂、更个性化的指令,并据此做出合适的推理与行为选择,而不仅仅依赖预定义的动作脚本。在任务理解或者说指令理解这一层面,Hi Robot 的表现相比π0要更加出色。
当然,在实际开发过程中,Hi Robot和π0是并行推进的。一方面,在π0中我们也在做语义理解相关的工作,比如提高标注阶段的质量,尤其是 label 的定义和精度。与此同时,在 Hi Robot 的开发过程中,我们也在同步优化 synthetic data(合成数据)的质量。
在这个过程中,我们的团队也在协作探索这两个模型(π0和 Hi Robot)之间如何交互,每个模块的架构如何设计,才能让整体系统具备更强的语义理解能力和更好的泛化能力。
4. Hi Robot和直接接入一个VLM有什么区别?
对于 high-level policy,我们其实也尝试过直接使用像 GPT-4 这种大型模型,特别是可以处理图像的版本(例如 GPT-4V),目前在市面上算是最强的通用多模态模型之一。
但问题在于,它其实并不能很好地理解机器人的能力边界——它不知道这个机器人“能做什么、不能做什么”,缺乏 grounding。它本身没有足够强的空间理解能力,也缺乏对任务的持续理解能力。
而我们所做的 Hi Robot,则不同:我们有自己的 VLA,也有自己的机器人数据库,并且我们可以利用这些 VLM 来生成更贴合实际的合成数据。把这些能力整合在一起,我们训练了一个真正为具身智能和机器人控制设计的 high-level policy。
这样的模型在任务理解和指令执行上,表现明显优于那些直接拿来使用的外部模型,比如GPT-4 系列。
5. 为什么Hi Robot在指令理解层面比VLM做的好?
这里面最核心的问题其实就是 grounding。这个“grounding”在科研领域其实是一个老生常谈的话题了。很多大模型,比如说在做数学题、写代码方面表现非常强,但一旦你希望它去控制一个机器人、与真实世界交互、与人进行互动,甚至是执行一个非常简单的动作,比如“把手机拿起来”,它就完全做不了。
这是因为这些模型从未真正与世界发生过交互——它们缺乏反馈(feedback)。在训练过程中,它们只是从静态数据中学习,从来没有真正通过感知和行动去影响环境,也没有建立起对动作后果的因果理解。
而目前的多模态模型,包括很多state-of-the-art的VLM 和VLA,在空间推理(spatial reasoning)方面仍然表现较差。
你可以把 grounding 的问题理解为由两个层面组成,首先是外在 grounding:模型对真实世界缺乏物理空间和时间维度的理解,它不知道物体之间的空间关系、交互逻辑;其次是内在 grounding:模型对它自身控制的实体——比如机械臂、小车等——也没有清晰认知,它不知道“我能做什么,不能做什么”、“做什么会成功,做什么会失败”。
这种缺乏内外双重 grounding 的问题,使得当前的大模型虽然语言强、逻辑强,但在具身智能场景中依然难以真正落地。
6. 怎么解决grounding的问题
这是一个仍然非常开放(open)的研究问题。目前谁都无法给出确切答案,它仍属于科研探索的范畴。但根据我的经验来看,这本质上还是一个数据问题,同时也是训练方法的问题。如果有足够高质量的数据,尤其是那种真实世界中人与环境交互的数据,并且这些数据中包含了明确的反馈,那么模型是有可能学会有效的 grounding 的。
在训练方法上,很多人提到强化学习。强化学习就是一种让智能体能够与环境进行主动交互的机制。比如,它可以尝试做某个动作——“我试试看这样做”、“我换个方式再试一下”——通过不断试错,从环境中获得奖励或惩罚,进而逐步建立起因果关系的理解。
可以说,这种机制是目前在具身智能、机器人控制等领域比较火的一个方向,也是在尝试解决 grounding 问题的重要路径之一。
7. VLA和RL怎么结合?
其中一种可能的类比是类似于 DeepSeek 的方法。它有一个预训练阶段,先利用一个大规模的数据集进行模仿学习,然后再通过强化学习进行微调。
对π0,我们也在考虑类似的思路:既然我们已经完成了基于模仿学习的一整套流程,接下来能不能把模型放到真实或模拟环境中,让机器人自主地进行尝试,从环境中获取 reward(奖励)或估算 value function(价值函数),再利用这些反馈去微调已有的模型,这其实也是一种可能的路径。
至于为什么像 VLM 或 VLA这类模型现在强化学习做得相对较少,倒不是没人做强化学习,而是因为目前能用于训练这些大模型的、带有环境交互能力的数据和平台非常有限。
此外,算力也是一个现实因素。在学校实验室的常规算力配置下,其实是很难训练得起这样规模的模型的,这在实际推动中也是一大限制。其实现在能把这些 VLA 模型真正训练起来的地方就不多。
而即使有能力训练的机构,很多也还没到已经把整个 VLA 的 recipe 在模仿学习阶段完全跑通的程度。大多数还停留在模仿学习阶段,这一阶段里其实还有很多 low-hanging fruit,可以通过比较简单的方法就实现显著提升。
强化学习本身依然是一个非常“科研向”的方向。比如 AlphaGo,它是通过强化学习训练出来的,它一旦成功,效果非常惊人,但问题是:它太难成功了。强化学习有点像在炒非常不稳定的股票——潜力巨大,但极其难以把控。
所以,当训练强化学习模型的成本非常高昂时,很多组织在资源分配上就会更加谨慎。也因此,至今仍有不少地方尚未真正去尝试将强化学习大规模用于此类模型。
8. Hi Robot方法介绍
根据Hi Robot论文里关于整体架构的描述:Hi Robot的整体架构是由高层策略和低层策略组成。高层策略接收开放式自然语言指令,以及来自基础相机和手腕相机的图像输入,生成低层语言指令。低层策略则结合这些语言指令、图像信息以及机器人的状态,生成具体的动作指令,并可选地输出语言回应。
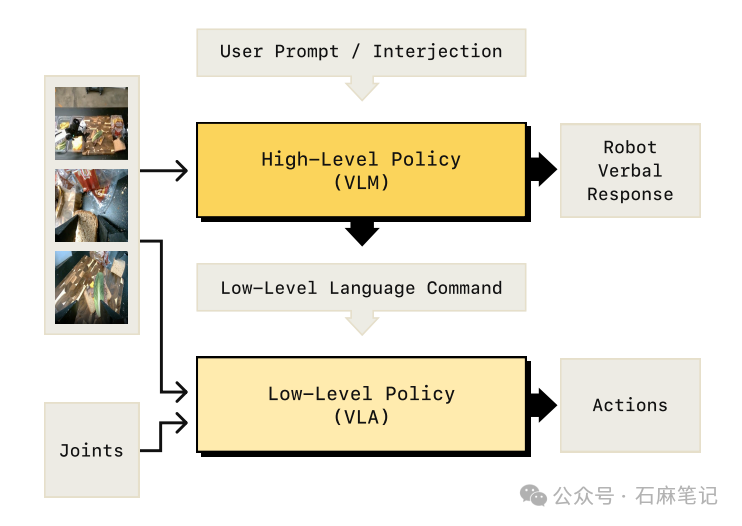
我们这里面分一个high-level policy和一个low-level policy。High-level policy是相当于system two(S2)一样,就是它负责思考;low-level policy像是 system one(S1),或者说它负责执行。
这里面high-level policy向左边这个箭头指向的是一些图片,这些图片来自于机器人本身对世界的观察,就是它各个相机拍下来的现在周围正在发生的事情。然后这个上面写的 user prompt and instruction 是指不管人对它说什么,比如说我说“我想要一个有牛肉、有西红柿、有青菜的三明治”,就是这样一串对机器人的指令被放了进来。这个是它的输入。
它的输出,一个是 low-level language command,也就是给机器人实际执行的指令,比如说它会把刚才这一串指令翻译成“拿起一片全麦面包”或者“拿起一片西红柿”,这样非常具体的操作指令。然后它还会输出另一个内容,是机器人对人的回答,比如说你跟它说“我对某个东西过敏”,它就会回应说它了解了,它不会把这个东西放到你的三明治里。它会有这样一个口头上的回应。
然后这就是刚才说的这个 low-level language command,比如说“拿起一片西红柿”这样的指令,这个连同这些照片一起发给 low-level policy,也就是这里面用的是π0。再加上机器人本身的一些状态信息,比如它的关节(joints)、它自己的观察值、内部的数值,比如它当前的速度。然后通过这个 model inference,它会预测出后续的行为轨迹,然后再执行出来。
这里面high-level policy的确可以理解为“大脑”,但像π0,其实更适合理解为“小脑”。我们做的是端到端的学习,所以在这个架构里,其实并没有 VLM 和 action expert 明确区分的存在,整个系统是连成一体的,是一个整体的模型,负责具体的感知-运动映射,整个模块就是一个S1的结构。
9. 关于π0的数据问题
之所以很难去训练这个 low-level policy,是因为它需要在真机上采集数据,数据必须来自真实硬件的交互过程。而且首先要有足够大的数据量,这就意味着需要非常多的机器人硬件设备。第二个问题是数据的质量,这其实更加关键。高质量的数据对训练效果影响非常大。在数据质量这方面,还有一段路要走。
像在π0这样的项目里,我们其实已经有了一定的经验,知道什么样的数据是“好数据”。这件事情我们已经做了很多年,因此已经积累了一些直觉(intuition),知道哪些数据是有价值的,哪些是不够好的。
所以我们会基于这些经验和直觉去主动控制数据采集的过程,通过优化采集策略、调控环境和操作方式,来尽量确保采出来的数据是高质量的、对训练真正有用的。
数据质量的问题是渗透在方方面面的,比如说,机器人上每一个摄像头放在哪里,这件事都非常关键。很多时候我们看到一些公司在给机器人采数据的时候,相机的位置设置就存在很大问题。比如:有的相机位置太远,导致它根本看不清自己在干什么。人类在操作时可以依靠自身的眼睛做出判断,但相机看的范围和分辨率可能远达不到这个能力;有的相机位置太近,以至于完全不知道周围发生了什么。当机器人犯了错,它也没有足够的信息去判断自己错在哪里,也就不知道下一步该怎么纠正。
所以我们通常不会只用一个相机,会使用至少三个。它们之间如何布置、如何协同,都会直接影响数据中到底包含了哪些信息,以及有哪些本该进入数据的信息却缺失了。
举个例子,我们发现,把相机放在机器人的手腕上会比较有效,这种我们称为 wrist camera。它能在非常近的距离内观察机器人实际在操作的物体,是非常关键的。
这只是一个相机位置的例子,但它反映出来的问题,其实涉及到不同机器人之间的协调、感知信息的设计等等,这些都会直接影响最终的数据质量。
另外,也存在有经验的遥操员和新手遥操员采集到的数据差异问题,在实际训练中,我们不可能只雇佣大量的有经验的遥操员,现实情况是一定会有大量新手数据。这些数据混在一起,该如何处理?如何建模其中的差异性和不稳定性?这其实也是我们在π0中讨论和研究的重要问题之一。
所以这其实也有点像是 ChatGPT 背后的例子。比如说,GPT4同一时期的其他模型,为什么整体表现都不如GPT4?并不是因为 OpenAI 拿到了比其他家多十倍的数据,大家基本上都用的是类似的互联网数据量。
真正的差异在于那些无数个细节,特别是在数据处理这部分——可能需要一千个细节同时做到位,每一个都很关键。尤其是数据的清洗、筛选、组织、权重分配、格式化等,都会对训练结果产生巨大影响。
所以像 Google 发的一些论文,通常会花很多篇幅去讲模型结构、架构层次,但其实最终效果的好坏,往往背后隐藏的是他们在数据处理上做了很多深入、精细的工作。只是这些细节往往不会全部写在 paper 里。
因为模型结构大家都很好奇,而且有时候确实只是换一个模型结构,性能就能提升个 20%。所以大家更关注结构层面的创新,也更愿意在论文里去讲这个。
但实际上,他们通常不会讲数据是怎么洗的。怎么去清洗、筛选、组织这些数据,往往才是决定模型能不能提升 60%、70% 性能的关键。而这些部分,才是真正的“秘密武器”。
10. 用于训练高层策略的数据采集与生成
根据Hi Robot论文里关于训练高层策略的数据采集与生成过程的描述:首先采集由人远程操控的机器人演示数据,并将其分割为短技能片段(例如“拿起一块 KitKat”)。基于这些标注数据,我们使用视觉-语言模型(VLM)生成合成的用户指令(例如:“你能帮我拿点甜的东西吗?”)以及机器人的回应。最终生成的数据集用于训练高层策略,该策略将图像观测和用户指令映射为语言回应和技能标签。
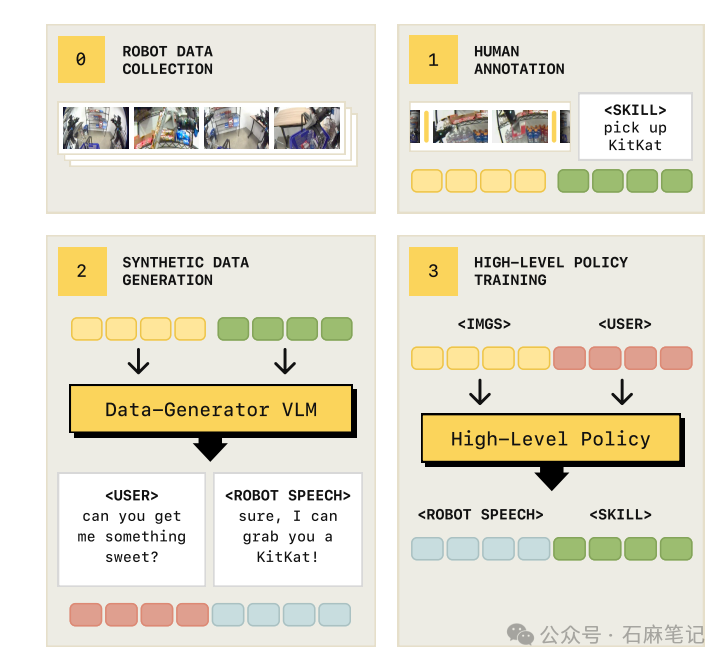
第0步是采集数据的过程,也就是在真实世界中控制机器人执行任务,比如说一个“去超市买东西”的任务。我们会让机器人自主导航,比如说跑到货架前面,然后由人远程操控它进行各种操作。这里需要说明的是,我们采集的原始数据是一整段长序列,比如一条数据可能长达十分钟。
然后进入第1步,我们会把这十分钟的数据切分成几秒几秒的小段,每一小段都对应机器人正在进行的一个动作或任务。我们会给这些小段加上自然语言的标注,描述“机器人此刻正在做什么”。比如在数据中有一段是“把这块巧克力拿起来”,我们就会给这一段加上相应的标签。
但这时候,仅仅有自然语言的动作描述还不够。比如说,某一段数据被标注为“我在超市里,我想吃点甜的”,这类描述非常模糊。机器人并不知道“甜的”和“巧克力”之间有什么联系,它无法从这种模糊描述中准确理解任务。
所以就进入了第2步,我们通过 synthetic data(合成数据)的生成来补充信息。我们会使用一个比较强的 VLM(视觉-语言模型),给它输入一张图片和一个明确的动作标签,比如“拿起一块巧克力”,让模型去想象:如果这是一个真实世界的场景,有一个用户正在与机器人交互,那用户可能会说什么指令?
比如,在这个场景中,用户可能说的是:“你去帮我买一些甜的零食。”然后我们也会让模型想象,如果机器人听到这样的指令,它该如何回应,比如它说:“好,我去给你买一些巧克力吧。”
接下来是第3步,我们会将前面采集的数据、标注的数据以及生成的 synthetic data 全部汇总,用来训练一个 high-level policy,也就是 Hi Robot 中负责“思考”的部分。训练的输入包括图片和用户可能发出的指令;训练的目标是让模型预测两个输出:机器人该如何回应用户的指令;机器人该实际执行什么动作。
11. 怎么理解第2步数据生成VLM
这里生成的是用户的指令。比如我们回到刚才那个三明治的例子,它在这个过程中要“想象”的是:现在正在制作的这个三明治里有生菜、有西红柿、有芝士,但没有白菜,也没有肉。那么它就可以去推理,这样的一个配料组合对应的可能是什么样的用户意图。它可能会联想到,用户说的是:“我想要一个没有肉的三明治。”
所以它的能力在于能从当前行为和视觉信息中联想到用户可能发出的指令,把某种配料组合对应到一类语义场景上,建立起语言和动作之间的对应关系。
当然我们也可以在真实世界中采集人与机器人交互的数据,但这种数据非常昂贵。你不仅需要一个人在控制机器人执行操作,还需要另一个人在现场不停地说话,比如“我想要这个”“我想要那个”“你等会儿”之类的,整个过程人力成本非常高。
但现在的情况是,市面上一些最强的 VLM(视觉语言模型)本身已经具备了这类能力。因为它们是基于整个互联网的大规模数据进行训练的,虽然它们不一定见过“人和机器人”之间的对话,但起码见过大量“人与人”之间的交流。比如,一个人请另一个人帮忙,会怎么表达;那个人是怎么回应的;又是怎么执行对方要求的。
在这种场景中,即使没有明确写出“这个人请求了什么”,模型也可以通过后续的行为来反推他可能说了什么。这种能力使得我们可以通过合成数据模拟“人机对话”的过程,而不用完全依赖真实交互采集。
12. Hi Robot使用的数据是怎么构建的
很大一部分都是来自真实机器人采集的数据。比如说,整个动作理解的过程,其实还是一个监督学习的过程。
也就是说,模型之所以能够理解动作、理解指令,很大程度上是因为它在真实环境中,通过大量人工采集和标注的数据进行训练的。所以这也就解释了你后面提到的问题:它的能力,其实在很大程度上是建立在之前那些高质量、真实交互数据的基础之上的。Hi Robot未来可能会开源,取决于是否有时间。
13. Hi Robot这样的high-level模块对VLA是必须的吗?
我觉得不是,这其实非常取决于具体的用途。比如说,如果这个模型本身并不需要和用户进行任何交互,或者它也不需要在新的场景中进行泛化,那它根本不需要一个像 Hi Robot 这样的高层模块,甚至它都不一定需要一个完整的 VLA 模型。它可能只需要一个很简单的模型就足够完成任务。
所以这其实取决于模型最终要部署在哪个场景中:它有没有交互的成分?有没有需要做逻辑推理的部分?
14. 在需要实时交互的场景,Hi Robot是必需的模块吗?
我只能说,Hi Robot 会赋予它这样的能力,但这并不是唯一的方式。当然也可以想象未来会出现一个单一的大模型,把这些能力全部整合在一起。或者说,现在这个问题仍然是一个非常开放的研究方向(open-ended research question),其实也没人能给出最终的标准答案。
References:
Hi Robot
https://www.pi.website/research/hirobot
π0
https://www.physicalintelligence.company/blog/pi0
Lucy Shi主页