在机器人模仿学习领域,过去一年要说最大的几个突破的话,Diffusion Policy一定可以排到前列,我也非常有幸在半年前,采访了Diffusion Policy的作者迟宬博士Diffusion Policy—基于扩散模型的机器人动作生成策略。在当时的采访中,迟宬博士就提到,数据越多Diffusion Policy的效果越好,为了更便捷的采集更多的数据,他们已经在做一套硬件设备,可以满足随时随地便捷采取操作数据的需求。Diffusion Policy的采访结束没过多久,UMI(Universal Manipulation Interface:In-The-Wild Robot Teaching Without In-The-Wild Robots)论文公开,并被机器人顶会RSS 2024接收。
今年3月,Yihao邀请我一起和UMI的两位一作迟宬博士和许臻佳博士做了个采访,趁着最近上线机器人训练数据连载,也把这个访谈重新整理,作为连载第二篇,分享给感兴趣的读者。
迟宬和许臻佳两位博士都博士毕业于哥伦比亚大学,在宋舒然组里做机器人操纵和感知相关的研究。接下来,让我们一起来了解下他们如何做到在不借助机器人的情况下,直接让人类采集机器人训练需要的末端执行器动作数据。
查看原文目录
以下为本文目录
👇
UMI介绍
UMI硬件结构介绍
UMI解决了什么问题
UMI是遥操作设备吗?
UMI如何使用
基于UMI采集的数据训练的模型效果如何?
UMI如何应对涉及移动的操作问题?
用UMI收集的数据在训练过程中的鲁棒性如何?
UMI有哪些需要改进?
和UMI类似的工作有哪些?
一些补充问题
一些想法
1. UMI介绍
UMI硬件结构介绍
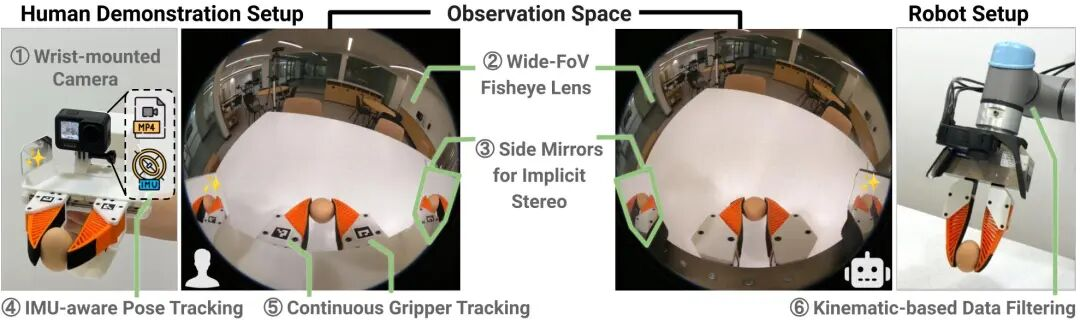
UMI的数据收集硬件是装有GoPro相机的手持并平行爪夹具①。为了收集可部署策略的观察数据,UMI需要捕捉足够的视觉信息以推断动作②(广角鱼眼相机)和深度等信息③(用于隐式立体的侧面镜片)。为了获得可部署策略的动作数据,UMI需要在快速的人体动作下捕捉精确的机器人动作④(IMU)、抓握宽度的微调⑤(连续的夹爪调节),并自动检查每个演示在特定机器人运动学约束下是否有效⑥(基于运动学的数据过滤)。
UMI解决了什么问题?
首先,在使用人类遥控机器人或human in the loop data collection的数据收集这条路线上,有两个极端,一个极端是使用YouTube视频,这不需要任何与机器人相关的数据,这类数据理论上是大量存在的,因为网上有大量的YouTube视频。问题在于,机器人本身的硬件还不够成熟,现有的研究环境中的机器人与人类的物理形态非常不同。因此,即使能够从视频中准确提取人类动作,将其映射到机器人身上是一个非常难的研究问题,目前还没有特别好的解决方法。另一方面,从视频中提取准确的人类动作也是一个非常难的问题。我们可以提取一些看起来合理的动作,但真正的操控精度往往需要达到毫米级别。在互联网上的视频,我们有很多未知的情况,因此如何获取毫米级别精确的机器人动作是一个未解决的问题。
上面这个极端是与机器人物理形态无关,那另一个极端是使用与最终想要的机器人完全相同的机器人进行数据收集。这个方法的好处是没有物理形态的差异,也就是说收集到的数据和测试时的输入输出是一模一样的。这种方法的最大问题是机器人的成本很高,形成了一个所谓的“鸡与蛋”问题。我们没有一个好的数据集,就很难做出好的机器人产品来部署在实际环境中;没有机器人部署在实际环境中,就很难获得好的数据集。我认为这个问题已经存在很多年了。
UMI希望能在这两个极端之间找到一个好的平衡点。UMI的核心是一个物理API,我们找到了一个物理接口,使它既包含了与机器人足够相似的物理形态,同时又不限制于具体的机器人形态,成本也比机器人低很多。我可以从三个方面具体说明。
首先是可移植性(portability)问题。我们假设即使机器人本身成本很低,例如每个机器人只有1000到2000元,按照目前机器人的重量,如果我想去餐厅采集数据,需要把机器人运到卡车上,再开到餐厅,然后卸下来安装调试,基本上半天时间就过去了。每次进入一个新环境都要有这个前期设置成本,这使得获取多样化环境数据的成本非常高。UMI通过其手持设备很好地解决了这个问题。虽然UMI的夹子现在有点重,有800克,但可以放在包里随身携带。因此,我们只要人到了一个环境,比如我们去餐厅吃饭,坐下就可以开始收集数据,两分钟内就能开始工作,大大简化了获取多样化真实世界数据的过程。
其次是物理形态的相似性。在学术界中使用的研究机器人往往是一个工业机器人,加上一个平行夹爪,UMI设计时考虑到了这种常见的机器人形态。因此,UMI记录的是夹爪在空间中的六维运动轨迹,只要机器人能到达任何一个位置,具体的关节角度并不重要,甚至可以用无人机达到所需位置。因此,它在一定程度上实现了对机器人形态的无关性,无论实验室使用的是什么牌子的机器人,只要有六个自由度都可以使用。
最后是数据收集的直观性。例如,我们尝试了一个任务是投掷方块,有两类物体,圆的和方的,机器人前面有两个盆,一个是圆的,一个是方的,任务是将方块投到方的盆里,圆块投到圆的盆里。这是一个高速的动态动作,用遥控机器人来完成是非常困难的。我们之前做实验,15分钟内遥控机器人没有成功投进一个方块。如果用UMI,因为人类用这种夹子的直觉非常强,因此用UMI收集同样任务的数据速度是人类用手的一半,虽然听起来慢,但相比遥控操作任务收集速度为零已经是很大的提升。在另一个任务——转动杯子上,我们发现UMI收集数据的速度是人手的一半,而遥控操作机器人收集数据的速度比UMI慢三倍。这使得UMI在数据收集方面具有显著的优势。
UMI是遥操作设备吗?
UMI不是遥操作设备。遥操作设备需要人来遥控机器人执行任务,UMI不是机器人,它没有电机,它是一个完全被动的硬件。我觉得可以理解成它是个手套,或者手持数据收集设备。
UMI如何使用
安装好的UMI使用非常简单,只要在日常生活中用手拿着UMI进行操作即可,关于UMI的硬件,迟博士在YouTube上也有相关视频介绍,可以参考文末reference部分。
如何使用UMI
用UMI完成各类任务数据采集
在杯子摆放任务中,UMI夹具的速度比传送快3倍以上,达到了人手速度的48%。
UMI和遥操作数据采集效率对比
基于UMI采集的数据进行模型训练的效果如何?
首先,让我解释一下UMI项目的工作流程。在我们的项目中,所有的视频演示都是由模型直接驱动的,完全自动化。在这个过程中,人类操作者没有进行任何干预或指导。对于每个特定任务,我们训练一个独立的模型。例如,如果是洗盘子的任务,那么该模型就专门用于洗盘子,它只知道如何执行这个特定的任务,而不会执行其他操作。可以通过以下视频查看基于UMI采集的数据训练出来的模型部署到机器人的表现情况。
摆设杯子
扔东西
洗盘子
叠衣服
与我们工作平行的是其他项目,他们在进行多任务学习。比如,他们可能通过语音标签来收集多个任务的数据,然后使用语言指令或者图像作为标签来指导机器人执行任务。因此,我们可以将我们当前的工作分为两个阶段:第一阶段是训练阶段,第二阶段是测试或推理阶段。
在训练过程中,我们需要一个数据集,这个数据集包含人类操作者收集的数据,用来训练模型。通常我们会进行数百次的数据收集,然后将这些数据用于训练模型。在推理阶段,也就是机器人执行任务时,它完全由训练好的模型控制。我们人类操作者会将机器人设置好,放置在合适的位置,然后启动任务。之后,操作者不再干预,直到任务完成或者需要停止时,才会再次介入停止机器人的操作。
单任务训练是我们当前项目的工作方式,但这并不意味着我们面临基本限制。理论上,我们的框架可以支持多任务执行。然而,在学术界资源有限的情况下,同时处理多个任务的成本非常高昂,因此我们选择了专注于单一任务。与我们合作的工业界机构,例如丰田研究院(Toyota Research Institute),正在开发能够同时训练多个任务的模型,并且他们的效果还是相当可观的。工业界通常拥有更多的资金和资源,可以雇佣大量人员来收集数据,这使得他们能够在多任务学习方面取得进展。
UMI如何应对涉及移动的操作问题?
在我看来,如果我们的目标是为了完成一个操作任务,只是想让机器人底盘移动的话,其实这些数据是足够的。因为我的目的只是让我的两个手在空间中保持某个位置,这样我就可以反推出来这个机器人底盘需要在哪个位置。我只需要知道周围的环境是什么,然后把机器人底盘移到一个能让两个手都能够到达的位置,再避免碰撞就可以了。我认为这个过程可以使用经典的方法来反推出底盘的位置,这个方法叫做逆运动学(inverse kinematics)。
用UMI收集的数据在训练过程中的鲁棒性如何?
首先,我们在训练时使用了颜色增强(color augmentation)。例如,对于相同的数据,我们在训练过程中会随机调整亮度、色温和饱和度。因此,训练出的模型对光照变化具备一定的鲁棒性。
其次,我们发现一个有趣的现象。我们的观测数据完全是手腕上的相机输入的图像,这些图像几乎不会静止,只要手在动,图像就会不断变化。我们发现这样训练出来的模型对这些干扰因素反而更鲁棒。它只会关注重要的部分,比如杯子的位置,而忽略其他不相关的信息。我认为这是因为在数据收集过程中,相机一直在动,每一帧的背景都不一样。这种运动过程本身也相当于是一种自然的增强(natural augmentation)。
总结一下,我们的视觉鲁棒性主要来自两个方面:第一,在训练过程中加入了手动的颜色增强;第二,在数据收集过程中,通过自然的背景变化实现了增强。
UMI有哪些需要改进?
第一个是让这个设备变得更易用一些。现阶段UMI这个设备还是比较重的,重心也不太稳,所以人在拿它收数据的时候会比较累。比如说,用两个小时后就会觉得很累,所以很难长时间使用。因此,设备在设计上可以更符合人体工程学。
第二个是tracking这部分,现在有一些缺陷。你现在用的是拿GoPro的视频数据加上IMU的数据,配合上SLAM的tracking。其实在有些场景下,准确率并不是很高。这个对数据采集者可能会有一些要求,比如你得知道怎样的行为会让tracking准确率更高。可能随便找一个人拿着它在家里做任何事情,有时候tracking的准确度会不高。
这个有几个可以做的方向,一个是整体提升SLAM的准确度。SLAM是一个相对比较成熟的领域,因为我们不是这个方向的专家,不能很好地优化SLAM。如果相关领域有更懂的同学或者专家可以帮忙解决,那当然是最好的。另外还有一些比较简单的办法,比如可以直接换成iPhone。iPhone有三个摄像头,甚至还有LiDAR,它的AR Kit tracking非常robust,那也是一个可以探索的方向。
再往上大改动的话,可能是兼容不同的末端执行器。毕竟现在只能是两个手指的平行夹爪。很多人会问,如果给你一个灵巧手怎么办?有五个手指,或者给你三个手指怎么办?目前的设备是不能兼容的。怎么把这个想法运用到其他种类的末端执行器上,也是一个很有意义的点,但也会更加困难。
再往后可能就是收集多任务的数据集。毕竟我们现在一个任务收一类数据,然后训练一个模型。如果真的想训练出一个通用的机器人策略,肯定需要多任务的数据集。无论从数据质量还是多样性程度都要提高。很多时候这不是学术界能够有资源做的。
2. 一些补充问题
机器人数据收集的路径有哪些?
整体来看,机器人收集数据有三条路径。第一条路径是在仿真环境中收集数据,第二条路径是在现实世界中机器人自己收集数据,第三条路径是人遥控机器人或者手动收集数据。
第一条路径仿真环境中收集数据,有一个非常大的隐藏成本,即构建仿真环境本身成本非常高。我们在早期的工作中大部分时间都花在构建仿真环境上,基本上这样的项目80%的时间花在构建仿真环境上,只有20%的时间用于研究算法。可想而知,仿真环境本身的成本很高,其中一个非常大的问题是仿真的物理精确性,以及资产创建的成本。因为仿真环境中并没有一个统一的物理模型,也没有一套固定的参数可以精确描述物体的物理性质,因此在这方面需要大量的手工调试,成本很高。
第二条路径是机器人自己在现实世界中收集数据。这其中有两个思路,一个叫做自我监督学习(self-supervised learning),另一个叫做强化学习(reinforcement learning)。它们的核心思想都是机器人通过探索环境,自己学习技能。然而,这两个方向都有一个非常大的隐藏成本。比如说,很多时候我们希望机器人自己学习,但这需要一个自动重置系统(autonomous reset)。想象一下,如果让机器人转动杯子或洗盘子,如果它不小心把盘子摔碎了,系统需要能够自动恢复到任务开始的状态。实现这样的自动重置系统成本很高,甚至比你想要学习的任务还要难,同时它还需要非常可靠。第二个隐藏成本是奖励工程(reward engineering)。也就是说,我需要用数学公式告诉机器人什么样的状态是好的,什么样的状态是不好的。真正将数学奖励与人的偏好对齐是一个非常困难的问题,同时这也是一个非常耗时的过程。因此,自动重置和奖励工程在现实世界中让机器人自己收集数据是一个非常大的障碍。
与这两条路径相比,大家原本认为用人来遥控机器人或者手动收集数据成本很高,但如果考虑到另外两条路径的隐藏成本,人工收集数据的成本看起来就不是那么高了。
关于复杂任务
关于任务复杂度,我认为当前的系统无法解决所有任务。因为它受限于两个平行夹爪,这对于一些任务的限制还是很大的。人类有五个手指,可以更好地握持一些工具,比如拿螺丝刀时,人类的五个手指能够实现更好的抓握。但即使仅有两个平行夹爪,我觉得已经可以完成至少70%到80%的任务了。因此,在短期内,任务复杂度不会成为太大的瓶颈。目前,我们可能连任务的5%都还没做到,所以仅凭现有的平行夹爪技术,还可以在之后很长一段时间内满足需求。
关于可泛化性
关于是否可以泛化到其他物体和场景,很大程度上取决于数据的收集方式。如果数据收集仅限于一个场景和一个物体,那么泛化能力会很有限。但如果数据收集非常多样化,比如在不同的地方收集同一类物体的不同实例,如红色杯子、蓝色杯子、大杯子、小杯子等,我们的实验发现还是可以有较强的泛化性。不过,这前提是能收集到足够多样化的数据。
关于成功率
关于成功率,目前来说,做到80%-90%的成功率问题不大。只要数据量足够,比如单一场景和单一物体的数据量有两三百条,成功率可以达到80%-90%。如果是多任务、多场景,并希望泛化到其他物体,数据量需要更大,比如我们在转杯子任务上收集了1000多条数据,成功率也可以达到80%以上。但如果数据不够,成功率肯定会下降。
即机器人领域是否存在类似于“Scaling Law”的概念?在自然语言处理的大模型领域,已经有很好的Scaling Law建立了。也就是说,如果已知模型的大小和数据量,我们可以在不训练模型的情况下,预测出模型的能力。或者反过来,如果想达到某种能力,我们可以推算出所需的计算量、数据量和模型大小。
然而,在机器人领域,学术界目前还没有建立这样一个Scaling Law。因此,对于具体任务的成功率,我们只能通过实际操作来测量。换句话说,我们目前无法在没有实际实验的情况下预测某个任务的成功率或所需的数据量。这是机器人研究领域需要进一步探索的一个方向。
在我们现在看来,研究机器人的Scaling Law所需的资源、资本和数据量可能超出了学术研究的范围。这意味着,建立一个类似于自然语言处理领域的Scaling Law,需要大量的资源和数据,这在当前的学术环境中可能难以实现。
关于遥操作
我想讲一下遥操作这个概念。其实有两个不同的应用场景。一个是用遥操作来收集数据,另一个是用遥操作来展示演示效果。这两者是非常不一样的。我们之前讨论的遥操作,主要是指用遥操作的方法来收集数据,再训练一个模型。真正展示演示效果时,机器人是自动执行的,这体现了模型的能力。
然而,还有一种情况是,演示过程中直接用遥操作来控制机器人,这主要是受限于硬件的能力,而不是模型本身的能力。在这种情况下,就没有模型的概念了。
至于我们能不能判断一个视频中的操作是遥操作还是由模型生成的,说实话,如果模型是用模仿学习或类似的方法训练的,并且训练得很好,仅仅通过观看视频是很难判断的。这时候就需要依赖发布演示视频的人是否诚实,他们是否承认这个操作是遥操作还是模型生成的。
关于模仿学习
模仿学习实际上是一种广义的概念,其中行为克隆是其子集之一。行为克隆是最简单的模仿学习方法之一。举个例子,输入是一个包含观测和动作配对的数据集。通过这些数据训练出一个模型,该模型直接学习从观测到动作的条件分布,最大化基于观测的动作的条件概率。这种方法被称为模仿学习的一种。
在模仿学习领域,除了行为克隆外,还存在许多其他方法。例如,Dagger(数据聚合,通过专家增强)是另一种广为使用的模仿学习方法。在Dagger中,学习过程不是静态的,意味着不仅仅是收集一些数据来训练模型,然后部署。相反,它是一个在线学习过程,机器人在执行任务的同时,人类专家为模型提供额外的指导和数据。这种方法可能会带来更好的学习性能和适应性。因此,模仿学习涵盖了多种不同的方法,行为克隆只是其中的一种典型示例。
上层规划和diffusion policy如何搭配?
第一个方法是训练一个language-conditioned diffusion policy。这意味着什么?举个例子,比如说我现在用UMI夹爪在收集数据时,我使用GoPro记录声音。那么我可以一边说话,描述我现在正在做什么,同时收集图像和动作数据。这时,数据不仅包括图像和动作,还有一个语言描述。然后我们可以训练一个模型,它的输入是当前图像加上我所描述的语言,即我想做什么,然后模型输出相应的动作。这样一来,我们可以在更高层次上结合大语言模型。比如说,我想做鸡蛋炒西红柿,大语言模型可以将人说的话分解成一个个子任务,比如我要先从冰箱里拿出鸡蛋,然后打碎鸡蛋,最后搅拌鸡蛋。大语言模型可以再把这样一个个子任务的描述,输入到language-conditioned diffusion policy来执行。
其二,我认为还有一个思路,做behavior library,即建立一个行为库。也就是说,为每个任务建立一个单独的模型,比如第一步是打开冰箱门,第二步是取出鸡蛋,第三步是打碎鸡蛋,第四步是搅匀鸡蛋。我们可以为每个步骤训练一个单独的模型,然后使用一个语言模型或其他模型进行调度,选择执行这些动作的模型。总之,我认为这两种思路都是可行的。
和UMI类似的工作有哪些?
之前有一些手持的数据收集设备,但并不是特别多。主要问题在于它们的动作控制不够精确。以前使用的结构光成像技术只能告诉你当前运动的方向,但无法得知绝对的三维坐标,即位置和旋转。这涉及到六个自由度,即三个位置和三个旋转。以前的方法无法准确获取这些六个参数。相比之下,我们现在主要使用GoPro相机结合SLAM技术,可以更精确地进行六自由度的跟踪。这是相对于以前工作的优势之一。
然而,劣势在于,例如交大卢策吾老师团队使用外骨骼进行数据收集。相比之下,我们的方法不能考虑机器人本身结构的影响,这一点可以视为优势也可以视为劣势。如果将其视为优势,那么我们的数据可以应用于许多不同类型的机械臂上,不局限于特定的机械臂类型。然而,也可以将其视为劣势,因为对于某些特定的应用场景,这种数据可能并不总是适用。例如,在涉及到肘关节和桌子碰撞等情况下,单凭姿态信息可能无法准确预测肘关节是否会碰撞。如果我们使用类似于真实机械臂结构的数据收集设备,就可以避免这种问题。
3. 一些想法
我个人从23年6月开始关注具身智能赛道,至今正好一年。一年前,因为摸不到头绪,特别想知道到底谁在搞具身智能,于是整理了那篇广为流传的AI+Robotics华人图谱,进而沿着这个图谱一直看各个组的工作,逐步增进对各个组方向和路径的认知。这一年持续写偏学术的内容,一方面是我自己也确实好奇这个领域最新的进展到了什么程度;另一方面可以通过这种通俗科普的形式让更多人了解这个领域最前沿最新的工作,为拉齐产业界、投资界和学术界的期望和认知做一点点小贡献。
但说实话,学术前沿的东西看的越多越深入,越不知道怎么投了,不知道有没有同样症状的同行!
[表情]
References:
https://umi-gripper.github.io/
https://www.youtube.com/watch?v=EJmAg1Bnp-k&t=179s
https://www.youtube.com/watch?v=x3ko0v_xwpg