在机器人训练数据方面,有一个数据金字塔,金字塔的低端是互联网数据和合成数据,这类数据量最大、成本最低、但数据质量较差;金字塔的顶端是训练某个机器人,人类遥操这个机器人本体产生的数据,虽然数据质量最高,但获取难度大、数据量小;位于金字塔中间部分的,则是鉴于合成数据和机器人本身数据中间的人类动作捕捉数据。我们今天介绍的这两篇工作MimicPlay: Long-Horizon Imitation Learning by Watching Human Play和DexCap:Scalable and Portable Mocap Data Collection System for Dexterous Manipulation,就分别利用金字塔的最底层人类数据和金字塔的中间层人类动作捕捉数据采集装备,来为机器人训练提供数据。
这里我稍微对这两个工作多做一些荣誉介绍,2023年11月,MimicPlay 被选为CoRL 2023年度最佳论文奖、最佳学生论文奖以及最佳系统论文奖的入围奖,约等于包圆了CoRL 2023的所有Best Paper奖,大满贯,不得不说,太牛了。2024年5月,DexCap 被机器人顶会RSS 2024接收。MimicPlay的作者包括Chen Wang, Linxi Fan, Jiankai Sun, Ruohan Zhang, Li Fei-Fei, Danfei Xu, Yuke Zhu, Anima Anandkumar; DexCap的作者包括Chen Wang, Haochen Shi, Weizhuo Wang, Ruohan Zhang, Li Fei-Fei, C. Karen Liu。
我们很荣幸的邀请到MimicPlay和DexCap的一作王辰博士针对这两个工作做一些交流。王辰博士目前是斯坦福大学计算机科学系的博士生,由李飞飞教授和Karen Liu教授指导。在加入斯坦福之前,王辰于2020年从上海交通大学获得计算机科学学士学位。他的研究目标是构建具有类人灵巧和处理日常任务能力的机器人。为此,王辰专注于机器人灵巧操作的学习、从人类运动中进行模仿学习,以及长时程规划与控制。
查看原文目录
以下为本文目录
👇
1. 具身智能数据采集方式有哪些
2. MimicPlay:通过人类游戏进行长时模仿学习
MimicPlay的核心思想
MimicPlay方法介绍
MimicPlay和LLM在任务规划上的区别?
人类视频学习轨迹vs轨迹优化
如何从2D视频中学习到3D轨迹
Embodiment Gap怎么解决?
毫米级精度怎么解决?
3. DexCap:灵巧操作动作捕捉数据收集系统
DexCap结构介绍
为什么DexCap动作慢一些?
什么是inverse kinematic?
人手数据如何映射到机械手上?
策略部署效果如何?
DexCap还有哪些问题?
4. 一些补充问题
关于MimicPlay和DexCap的结合
DexCap和UMI比较
5. 一些想法
1. 具身智能数据采集方式有哪些
数据可以看作是金字塔,最底层是最便宜、最大量的数据,例如互联网数据和生成数据。这些数据量大,但缺点在于无法很好地复现物理世界,这些虚拟的数据无法很好的解决比如碰撞和摩擦力等这些物理世界运动学或动力学问题,也存在sim2real gap的问题,这些也是学界正在努力解决的难题。
金字塔的倒数第二层是人类动作捕捉数据,可能需要人穿一些东西,但可以获得比较高精度的数据,这些精度可以实现不少机器人任务,比如pick 和place,但也不能解决所有问题,因为存在embodiment Gap,机器人无法像人类那样自如地移动,只能处理特定任务。这一层的数据成本略高,需要购买设备,数据量肯定不如互联网或合成数据那么多,但相对来说数据质量更高,因为它们是从现实生活中获取的,不存在虚拟到现实的差距。
金字塔最顶层的数据摇操作数据,即通过手动操作机器人来采集数据。你需要亲自操作机器人,告诉它如何行动,比如夹取物品等。因此,这种数据的量肯定比前两种要少,因为操作速度较慢,并且需要有人专门负责操作机器人。这意味着你需要拥有这样一台机器人,并且有人员去训练和操作它,这不仅增加了成本,还需要专门的数据采集员。这种方式的数据量少,成本高,但好处在于它直接采集自机器人,因此确保数据的可用性和准确性。总结来说,这三种数据采集方式各有其特点和优势。
2. MimicPlay:通过观察人类游戏进行长时模仿学习
MimicPlay的核心思想
MimicPlay的想法是从人类行为数据中学习机器人的控制和策略。直接从人类行为中学习机器人的动作是不可能的,因为通过相机很难精确捕捉手在三维空间中的具体位置,这导致了最终的数据无法直接用于训练机器人,因为机器人的运动方式会有所不同。
因此,我们的想法是退一步,不直接学习机器人的电机动作,而是学习策略。比如说,一个较长的任务是将某个食物放进碗里,再放入微波炉加热,最后取出。人在执行这个long task时,可以给出很多策略方面的提示,比如手应该先去哪儿,怎么抓住微波炉的把手,如何打开微波炉,如何抽出托盘,把碗放上托盘,再关上微波炉。虽然人类手部轨迹和机器人的轨迹会有所不同,但做这件事的先后策略,比如去哪里找把手,去哪里拉托盘,这些策略是可以共享给机器人的,这套策略我们称之为高层次的规划。低层次的控制器(low level controller)则是在拿到规划后,控制机械臂的末端复现这些动作。
高层次和低层次分开之后的一个很大优势是,高层次的规划器(planner)可以直接从人类视频中学习。这种数据是比较便宜的,可以称之为“play data”。你不需要对这些数据进行标注,比如标注你在做A还是B。只需要给定一个目标,比如某道菜,希望高层次的轨迹规划能规划出相应的策略。你可以想象在家里的厨房放一个相机,它可以捕获你每天在厨房里的策略。比如,你做一道菜时,先打开冰箱,从冰箱里拿出某个菜,然后在切菜板上切开。这些都是可以用第三视角相机轻松获取的数据。
低层次的控制器因为高层次有更多人类数据的支持,学习所需的数据量也会减少。它只需要按照规划的轨迹去执行20个步骤即可,不需要再考虑高层次的规划问题。这样,低层次控制器的数据需求很少,可能只是学了一个抓取问题或移动问题。这些移动可能只需控制机器人向某个方向移动几厘米,有时甚至不需要学习。
通过高层次轨迹规划的数据,可以很好地帮助整个系统减少机器人数据的需求。将规划问题和控制问题分开是我们当时的一个想法。高层次轨迹规划的数据通过人类行为数据来实现泛化,可以很好地帮助系统减少对机器人数据的需求。这样可以使整个系统更高效,数据需求更少。这是我们一直以来的核心思路。
MimicPlay方法介绍
MimicPlay是一种分层模仿学习算法,它可以从廉价的人类演示数据中学习高层规划,并从少量多任务遥操作操作机器人演示中学习低层控制策略,
算法大致可以分为三个阶段,第一阶段:使用人类操作视频数据训练一个轨迹生成模型,可以针对不同任务目标形成高层规划指导;第二阶段:使用少量的遥操作数据训练一个低层机器人控制器;第三阶段:测试阶段,给定一个长程任务的视频提示(可以是人类动作视频或机器人遥操作视频),MimicPlay生成运动轨迹并指导低层控制器完成任务。
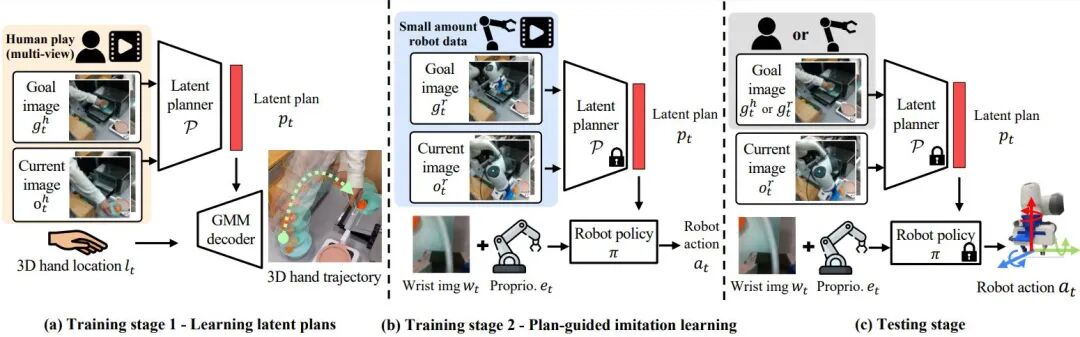
MimicPlay和LLM在任务规划上的区别?
这里有一个非常大的区别,大语言模型(LLM)给你的规划通常只是一些步骤,比如1、2、3,但它不会告诉你每一步具体怎么做,也没有提供任何具体的实现信息。例如,我提到的高层次的规划不仅仅是列出步骤1、2、3,而是详细描述了如何实现这些步骤。它会给你一个三维轨迹,告诉你要以某个弧线到达把手的位置,然后在特定角度抓住把手并打开它。
我刚才描述的这些具体轨迹和动作细节是大语言模型无法通过语言直接表达的。用语言描述这个过程非常困难,甚至无法准确传达,而我们的高层次规划的优势在于它提供了这些具体的三维空间轨迹,并将其传递给低层次的控制器。
所以,高层次规划提供的不是像说明书一样的1、2、3步骤,也不是简单的语言描述,而是具体的三维空间轨迹,明确指出具体位置、抓取角度等,这就是我们所说的"grounding"。当你有一个大语言模型规划出1、2、3步骤后,需要进行"grounding",也就是落实到具体操作上。比如说,大语言模型告诉你先去打开冰箱,但它没有具体说明如何打开冰箱。那么你需要找到冰箱把手,移动到把手位置,握住把手,并以某个轨迹打开冰箱。这些具体的操作就是我们所说的"grounding"。
每个人的冰箱可能不一样,有些冰箱门是另一个方向,这就需要具体的"grounding"。高阶规划需要具体到每个细节,而大语言模型在这个落实过程中存在困难。MimicPlay的高层次规划实际上已经包含了具体的实施细节,明确指出了如何实现这些步骤。因此,它提供的是一个已经落地的高阶规划,详细说明了如何操作。
从人类视频学习运动轨迹,是一个轨迹优化的过程吗?
不能说是优化,因为人类的行为不一定是最优的。这其实是一个求解问题,而不是优化问题。比如说,大语言模型告诉你打开冰箱,这是一个语义上的任务,那怎么去解这个任务。这里面解出来的结果是一些三维的轨迹和三维的抓取位置。这些是求解的过程,求出来的解不一定是最优解,但它可以是一个可行方案。
它不一定是最短路径,因为人在操作时通常不会考虑这个问题。但这个路径大概率是一个还不错的路径,因为人不会故意绕路,不会说我要打开冰箱时在这里摸摸、那里摸摸再打开。这样做浪费时间,所以它是一个求解问题,但不一定是最优的。
互联网上人类视频大多数是2D,那如何从2D视频中学习到3D轨迹呢?
MimicPlay我们当时使用了多目的RGB相机,用两个RGB相机来捕获人手的三维轨迹。互联网视频不能直接用,因为它们没有办法提供三维信息。不过你可以这样想,即使不是三维轨迹,可能二维轨迹也很有帮助。你可以想象你看到的画面虽然是二维的,但是你看到手在二维图像平面里移动,其实也能告诉你先去哪再去哪。因为从二维图像中你也能看出来,你要移动到哪个把手,哪个把手在哪个二维像素位置。这也是一个非常有信息含量的规划。
实际上,MimicPlay可以做一个改版,把高维度的三维轨迹降级到二维,也是可以的。这可能会打开更多互联网上视频数据集的可能性。但是我们在发布这个工作时,并没有验证这方面的内容。你可以想象,互联网上的视频还有一个难点是相机不一定固定。相机不固定的话,代表着机器人需要理解视频中的空间概念,因为画面动了,对它来说,世界坐标系就变了。我觉得从YouTube视频上学习还是有一定的学术难度。
人类和机器人的Embodiment Gap怎么解决?
因为人用手的方式和机器人用夹子是挺不一样的,而且我们也知道现在有很多不同的机器人夹子。有些夹子大,有些夹子小。同样比如说从微波炉里面抽出一块铁板,大夹子和小夹子的方案会有点区别。这一部分对数据的需求量其实可能没有那么高。为什么呢?因为当你已经确定了你要去哪里夹什么,并且移动到什么点位的时候,之后做的其实就是一个跟随轨迹的机器人的action。而这个action是可以让它overfit在这个机器人自身的Embodiment上。这里的低维控制就是用遥操作的方法,去教这个机器人几个简单的pick和place,机器人就学会了如何把高维轨迹方案翻译成机器人可以执行的电机方案。这个翻译方案是可以复用的,你给我新的轨迹方案,我就继续用这个低维的翻译方案转换到机器人的action,这就是低维controller在干的事情。
从人类视频上无法获得毫米级的精度,这个问题怎么解决?
这就是为什么他虽然提供的是高维度的规划,但其精度并不高。他只是告诉你,把手大概在那样一个3D位置,可能在五厘米的范围内的一个3D空间位置。高精度的控制是交给低维度的controller来实现的。低维度的controller会获取机器人自身的数据,即所谓的手腕相机(eye in hand),安装在机器人的夹子上或夹子边上,用于实现高精度的对齐和夹取。这种高精度控制也具有泛化能力,比如你高精度的抓三四个不同的把手,就有可能泛化到其他颜色或形状不同的把手上。高精度的控制是通过低纬度的controller来实现的,高维度的规划只是告诉你大概要去哪里,在五厘米的范围内,去那个地方,夹住把手的大致区域。而具体的抓握动作低维度的controller会利用手上的相机看到把手,对齐它,然后慢慢靠近并夹住它。
到了DexCap阶段,可以通过动捕设备(动作捕捉设备)实现厘米级别以内的追踪。这个追踪精度很高具体到手指指尖的精度,不仅限于手腕的位置。这种高精度追踪使机器人可以直接从数据中学习操作方案。比如MimicPlay,人类视频的精度只能到达五厘米或三厘米的范围,而三厘米以内的精度需要通过机器人自身学习的低级控制器(low level controller)来补足,从而实现任务。到DexCap,通过这种可穿戴式的数据采集设备,我直接把精度做到最好,这样机器人就可以直接从数据中学习其方案。
3. DexCap:灵巧操作动作捕捉数据收集系统
DexCap结构介绍
DexCap中手上的相机是用来做SLAM的场景追踪,所以它提供的手特别是手指的精度,都是在厘米级别的,都是在一厘米以内的左右级别。所以DexCap,我称为它是一个“核武器”,它给你一个更高精度的数据。相比于第三方视角的MimicPlay的人类数据,它给的精度本来就更高。DexCap手上的相机是用来做追踪(tracking),它的目的不是为了获得图像。因为人的手和机器人的手还是长得不一样,所以出现在画面里之后还是有domain gap。所以你并不能单纯用人类手上相机的数据去直接学习机器人方案,我们试过了不太work。
DexCap手套是动作捕捉手套,每根手指上都有一个电磁场传感器,手上的相机用于定位手掌在六自由度空间里的位置。相机下方有一个电磁发射器,每个手指的指尖都有一个电磁接收器。通过电磁场实现毫米级别精度的定位,确定每个手指指尖相对于手掌的三维空间位置。再加上手掌上的相机,可以给手掌相对于胸口的相对位置,那进一步就可以获得手指指尖在相机画面中的相对位置。这个精度由胸口和手腕上的相机,以及动捕手套这套设备共同保证。
胸口相机用来定位人体相对于世界坐标系在空间的位置,手腕上的相机用来定位手掌相对于胸口的空间位置,动捕手套来定位手指指尖相对于手掌的空间位置。所以你背着这套东西走,胸口的摄像机可以告诉你人在哪里,手腕上的摄像机可以告诉你手掌相对于胸口在哪里,动捕手套可以告诉你手指相对于手掌在哪里,最终可以获得一个手指在空间中的绝对位置。这个绝对位置是高精度的,这直接保证了当你将机器人推入场景时,只需让机器人进行inverse kinematic(逆向运动学)来完成操作动作。
什么是inverse kinematic?
在机器人控制中,有两种主要方法,称为正向运动学(forward kinematics)和逆向运动学(inverse kinematics)。正向运动学是指,当我告诉你每个关节的角度时,你可以计算出机器人手指指尖最终在三维空间中的位置。逆向运动学则是相反的过程,当你告诉我手指指尖应该到达的位置时,我可以帮你计算出每个关节应该转动的角度。
当你使用人类行为数据采集到厘米级别的手指指尖位置后,可以应用到任何一种机器人上,无论是人形机器人、机械臂或者其他形式的机器人。只需将机器人推到空间指定位置,控制策略会告诉它手指应该到达哪个点位,机器人可以直接使用inverse kinematic方法计算出每个关节应该转动的角度,手指指尖就会移动到目标位置。这样,机器人就能够复现人类手指的行为。比如开门操作,人类会按照一定的轨迹,将每个手指放置在门把手的特定位置,然后握紧并向下按压。这些动作轨迹会被动作捕捉设备完整记录下来。机器人随后可以利用逆向运动学的方法复现这些轨迹,从而也能够成功打开门,这就是想要实现的目标。
为什么戴了手套做动作也会比正常的稍微慢一些?
这背后涉及到一个有趣的点,不是所有的人类数据都能直接应用在机器人身上。一个简单的例子是机器人无法像人类手那样快速反应。人类可以迅速地变换方向,手指也能迅速停下来,比如说用0.1秒的时间划过一个弧度而不产生惯性。但机器人不同,它的电机在高速运转时,突然刹车会导致超调或者反应延迟,这是电机控制上的问题,也是机器人和人类肌肉之间差异的表现。
因此,有时候需要重新采集数据。一旦数据采集完成,我们会发现,尽管数据看似完整,但有些动作机器人无法学习或者表现不佳,因为机器人不能像人类那样快速而灵活。因此,我会有意放慢人类的动作速度,以提高数据的质量和成功率,这样转化为机器人数据的过程会更加有效。
可以想象一下,人的手是非常灵活的,可以迅速变换方向,手指也可以急停,比如我可以用0.1秒的时间划过一个弧度,而不产生任何惯性。但机器人不同,它的电机在高速运行时,突然刹车他会停不住,他会过去一点再回来。这其实也是另外一种形式的embodiment gap问题,也是机器人的电机和人类肌肉之间的差异。所以人类自如流畅的动作是没有办法让目前的机器人复现的。这也是个难点,有些时候,DexCap的数据需要重新采集,数据采集看似不错,但有些动作机器人就是学习不来,因为机器人不能像人类那样快速而灵活。因此,我会故意放慢人类的动作速度,以提高数据的质量和成功率,这样转化为机器人数据的过程就会更加有效。
我们现在的机器人,包括电机的发展还没有达到一个它的上限,我们还是没有办法去复现人类的肌肉组织,或者类似的这种控制的能力,所以这就是这种数据采集方案的一个缺点。
人手数据如何映射到机械手上?
在通过DexCap采集到人手操作数据后,需要通过观测从定向和动作重定向将观测数据和动作主体进行切换。观测重定向(Oberservation Retargeting):机器人使用与人类数据收集期间相同的观测摄像机(RGB-D相机),通过从相机中观测构建3D点云并将其转换到机器人操作空间,将DexCap数据重新定向到机器人实体。动作重定向(Action Retargeting):为了将人类手指运动传递到机械手(LEAP HAND)上,我们使用指尖逆运动学(inverse kinematic,简称IK,上文有解释),来计算机械手16维的关节位置,在通过IK进一步计算机器人手臂各关节的位置。
因为现阶段机械手没有办法做到和人手一模一样,所以Embodiment Gap问题不可避免的存在。为了进一步缩小人手和机器人手之间的视觉差距,我们使用正向运动学生成机器手的点云网格,并将其添加到点云观测中。在这些数据基础上训练了一个Pointcloud-based Diffusion Policy(Diffusion Policy—基于扩散模型的机器人动作生成策略),这个Diffusion Policy以点云作为输入,以未来目标位置作为机器人动作作为输出。
策略部署效果如何?
仅使用重新定向(Retargeted)的人类运动捕捉数据训练Pointcloud-based Diffusion Policy,机器人就可以控制双手(46维动作空间)执行任务,包括收集网球和包装物品。所有策略均在没有任何远程操作数据的情况下学习完成,仅通过30分钟人类运动捕捉数据学习完成。
0:00-0:11 收集双手人类运动捕捉数据
0:11-0:28 完全自主的策略执行
然而,DexCap 还不能胜任需要施加力量的任务,因为仅有位置数据是不够的。因此,我们在DexCap 模型中引入了策略执行过程中的人为纠正(Human-in-the-loop correction)。经过不超过30 次纠正,机器人能够准备茶和使用剪刀。
双手自主泡茶(还会拧瓶盖!)
剪纸
DexCap支持两种策略执行过程中的人类参与纠正方式:1. 残余纠正:测量人类手腕的3D位置变化,并将其作为残余动作加入到机器人手腕运动中,这种模式人类手部动作不需要太多,但需要更精确的控制;2. 远程操作:根据逆运动学直接将完整的人类手部运动转换为机器人末端执行器的动作。这种模式允许对机器人进行全面控制,但人类手部动作较多。
DexCap还有哪些问题?
还是有很多地方可以提高。首先,我觉得穿戴设备的成本可以大幅降低,目前的成本还是太高了。其次,我一直在想,是否可以用更隐蔽的相机替代胸口的相机,比如集成在眼镜上的小型摄像头等,这样的设计让人们不需要额外携带设备。手套也是如此,虽然它在很多工作中不会有太大影响,但你不能洗手或者洗碗,因为它不能接触水。那么,是否可以使用类似苹果手表的技术?比如,你只需做一个手势就可以呼出菜单,手表通过肌肉识别知道你要做什么。也许不需要手套,只需一些环状装置来侦测手指运动,这样整个过程就会非常隐蔽。眼镜上的相机加上没有手套的手指定位,这种设计让更多人愿意佩戴这些设备,因为它们可以完全融入生活中,别人甚至察觉不到你在采集数据。这是未来发展的一个方向,即开发更低成本、更隐蔽的可穿戴设备。
另外一个重要的方面是在算法层面上,我们如何让新用户明白机器人能处理哪些数据,不能处理哪些数据。是否有方法可以提示用户,告诉他们:“我已记录下你刚刚的动作,但要注意,机器人无法执行这个动作。可以给我一个你使用的某品牌机器人的模型,我可以计算并告诉你,这个动作对该机器人来说是不可行的,因为其电机结构速度不够快。” 通过这种提示方法,可以提高算法在这方面的表现。
4. 一些补充问题
关于MimicPlay和DexCap的结合
MimicPlay和DexCap可以结合,用动捕设备采集的数据完全可以用来作为MimicPlay高层次轨迹规划的训练,而且这个训练可以训练到高精度的规划,因为DexCap数据的质量更高。同时,对于底层的控制,也可以用DexCap的数据进行一定的预训练。所以这两个工作是可以结合的,用MimicPlay的方案在DexCap数据上来实现比较优的数据采集和最终的机器人实现效果。
DexCap和UMI比较
DexCap和UMI(对话迟宬、许臻佳:UMI——机器人训练的物理API)都是通过便捷的设备采集人手操作数据,他们的区别在于UMI借助夹爪,而DexCap是手套。DexCap和UMI的核心想法都是在不需要借助机器人的情况下采集数据。然而,人类的行为数据有一个问题是,如果不用高精度捕捉技术的情况下,是很难精确的获得3D轨迹的。所以DexCap和UMI都引入了SLAM。DexCap的侧重点是,通过可穿戴设备在不影响人们自然使用的情况下,获取行为数据,比如说,你是超市的收银员,可以戴着手套继续工作,而不需要手里握着两个夹子。握着夹子会影响部分工作,例如不能灵活地操作硬币。
DexCap使用数据手套的好处是,它不会影响到日常生活。比如说,我可以戴着手套一整天写程序或者弹钢琴,但如果使用两个夹子,可能就无法进行这些活动。我一直想让机器人的数据采集能够泛化,扩展到更多人的生活中,就像人们开车一样每天都在创造大量数据,这样可以更好地融入到日常生活中去。特斯拉的自动驾驶系统之所以能够收集大量数据,是因为开车是人们生活中的一部分,而机器人的数据则很少有人会进行大量的操作采集,因为这并不是常规生活的一部分。我认为,让数据采集变得更轻松、对生活影响更小是关键。这样的话,像超市员工、质检人员或者工厂的流水线工作者可以穿着这些设备继续日常工作,从而使数据逐步积累增多。
UMI这类方式额外增加辅助工具,需要重新定义工作方式,可能会面临一些成本问题,因为需要对人们进行新的培训。我更倾向于利用现有数据来训练机器人,使其更像人类。我觉得这两种方法的核心理念虽然在某些呈现方式上可能有相似之处,但在内核出发的角度上却完全不同。UMI和DexCap最大的区别在于,UMI是从机器人的角度出发,而DexCap是从人的角度出发。DexCap的思路是希望未来机器人的手可以像人手,这样数据就可以scale up,UMI的思路是如果人可以帮机器人采集数据,这些数据就可以直接给机器人,而不需要遥操作。
5. 一些想法
以上是Robot Data系列第四期。这个系列目前规划第一季收录10期关于机器人数据的访谈,周更,大概两个月左右更新完。前面几期都会聚焦在人类视频数据、动捕数据、和遥操数据,后面也会看看合成数据,数据处理,和数据集。欢迎大家推荐相关工作,或者希望我采访哪个工作的作者,都可以给我留言。