Robot Data专栏,我们围绕机器人训练数据采访一些具有代表性的学术论文作者。说到机器人训练数据相关的论文,斯坦福大学Chelsea Finn组里的Mobile ALOHA可以说是2023年至今,在模仿学习和遥操作方面最知名的工作之一。斯坦福大学Chelasea Finn组陆续在2023年上半年发布ALOHA和ACT,2023年末发布Mobile ALOHA,24年上半年发布HumanPlus,这一系列利用遥操作进行机器人训练的工作获得了学术界、产业界甚至各个科技媒体的高度关注。Robot Data第五期,我们很荣幸的邀请到了Mobile ALOHA和HumanPlus的一作符梓鹏博士,聊一聊这两个工作背后的数据故事。
符梓鹏博士目前是斯坦福大学人工智能实验室的计算机科学博士生,由Chelsea Finn指导。此前,他在CMU RI获得硕士学位,由Deepak Pathak和Jitendra Malik指导。他在UCLA完成了计算机科学和应用数学的学士学位,导师是朱松纯教授。符梓鹏博士的研究兴趣在机器人学、机器学习和计算机视觉的交叉领域,致力于在非结构化开放环境中实现稳健的机器人性能和可部署的机器人系统。
值得一提的是,符梓鹏博士在学术生涯的早期在机器狗locomotion方面有非常多优秀工作,近期的工作聚焦在通过遥操作和人类视频数据解决移动操作问题。可以说是学术界非常难得的横跨仿真数据、遥操数据、人类视频数据;纵跨locomotion和manipulation的优秀学者。我们这期文章借由HumanPlus这篇论文,来了解符梓鹏博士对机器人训练和数据的一些洞见。
查看原文目录
以下为本文目录
👇
1. 从合成数据到真实数据再到两者结合
机器狗训练—合成数据
Mobile ALOHA-遥操真机数据
HumanPlus—合成数据与遥操数据结合
2. HumanPlus:让人形机器人像人的影子一样
HumanPlus的数据来源
HumanPlus模型结构
3. 一些问题
怎么理解人形机器人和人体的影子结合
人形机器人控制路径对比
仿真环境中的真实度问题
更换硬件要怎么做?
为什么用单个RGB摄像头
关于分层与端到端问题
4. 一些补充
1. 从合成数据到真实数据再到两者结合
机器狗训练—合成数据
我个人在机器人方向的研究最初是从机器狗的训练开始,利用仿真软件生成大量合成数据,通过强化学习训练机器人。这种路径在某些场景下确实非常有效,例如训练机器狗行走,把机械臂装在机器狗上协调控制、或者让机器狗跑酷等。虽然仿真数据可以大量的生成,可以做一些强化学习,比如告诉机器狗可以往前走、往前走的时候又不撞到任何东西、还要省力和节省电的损耗,这些告诉机器狗后它可以自己学出来。也不需要,或者说也没有真实世界的数据可以用,因为我不可能练一大堆宠物狗来收集数据。
但仿真数据加上强化学习也遇到了一个瓶颈,主要表现在它只擅长做一些偏向locomotion(局部移动)这类的动作,比如动动手动动脚,或者像In-hand orientation(手内物体重定向)这类动作,像OpenAI也使用生成数据来训练灵巧手。然而,当任务涉及到需要更高层次决策和复杂规划时,机器人就需要更多的视觉信息。仿真软件现在没法很好的提供这些真实世界里的视觉信息,它更多的是提供物理碰撞和结构化信息,例如深度数据等。然而,要渲染出真实的颜色信息则相对困难。
Mobile ALOHA-遥操真机数据
到了Mobile ALOHA的阶段,相当于我们完全没有用到任何仿真软件的信息,完全利用真实世界的数据来让机器人进行学习。收集机器人在真实世界中的数据,这些数据由人类通过遥操作方式采集,并通过高效的模仿学习用少量的数据进行训练;这时候可以获得更好的、比较真实的视觉信号,比如RGB数据,还有一些语义上的数据。
这种方法面临的一个挑战是,真实世界数据的收集速度较慢。所以,Mobile ALOHA相当于是结合了一个高效的模仿学习算法,只需提供大约50次人类采数据的尝试,就可以让机器人学习并完成各种任务。这种方法高效地帮助人类采集数据,相比以往使用VR设备或3D鼠标键盘等工具采集数据,不仅速度快且易于上手。Mobile ALOHA的主要作用在于快速让人们掌握如何操作机器人,以解决几乎所有真实世界中可能遇到的问题。
Mobile Aloha
HumanPlus—合成数据与遥操数据结合
在HumanPlus的阶段,我们尝试将合成数据和机器人遥操数据的特点融合:一种是海量的合成数据,虽然在仿真软件中的数据量大,但质量不高;另一种是高质量的真实世界数据,但采集速度慢,无法达到海量。因此,Human Plus的主要目标是能否结合这两者的优点,即在真实世界中收集高质量数据,同时利用海量的合成数据。
HumanPlus
2. HumanPlus:让人形机器人像人的影子一样
HumanPlus的数据来源
HumanPlus结合了两种数据来源:一边是机器人仿真数据,另一边是人类的运动数据。
关于机器人仿真数据,我们不能直接将人类的运动信息复制到机器人上,因为机器人的重量和关节结构与人类不同,直接复制可能会导致机器人失去平衡并倒下。因此,在最低层次的控制逻辑上,我们仍然使用强化学习在仿真环境中生成大量的仿真数据训练机器人。这意味着,当机器人接收到人类关节位置信号时,它会根据这些信号主动控制自己的动作,以模仿人类的动作,但同时也会考虑到自身的物理限制,以保持平衡。这种方法可以确保机器人既能够模仿人类动作,又不会因为不稳定而倒下。
关于人类的运动数据,虽然真实世界中没有大量的机器人,但有很多人的数据。例如,很多视频中会有人在跳舞或做饭。这些数据已经存在,而且非常大量。我们在想如何很好地利用这些人类数据,将它们有效地迁移到人形机器人上。人形机器人的最大优势就是能够很好地利用大量的人类数据。我们的工作就是让人形机器人通过这些数据进行精细控制。
大多数情况下,我们需要模仿视频中的人类动作。这些视频通常由摄像头记录人的生活,摄像头可能放在旁边或者安装在人的头上,例如运动相机。我们的工作重点是如何利用好一个RGB摄像头的限制来获取数据,通过摄像头捕捉到人的骨骼信号,包括身体骨骼、手部、手臂和腿部的关节数据。这些数据用于实时控制机器人,使其能够执行各种任务。
此外,我们还结合了类似Mobile ALOHA这样的高效模仿学习,使机器人能够自主完成任务。机器人通过头上的RGB摄像头获取视觉信息,并根据这些信息完成任务。现在,机器人已经能够自主地完成一系列任务,比如自己坐在椅子上,把鞋穿到脚上,然后系鞋带,站起来走路。这些能力都是通过利用人类数据训练得以实现的。
通过模仿学习人类视频数据,我们可以将人类的运动模式转化为机器人控制策略。感觉就像是神经网络在控制一个人的动作,最终的神经网络输出可以直接映射到人形机器人上。由于人形机器人在形态上与人类相似,这种映射过程相对简单和直观。这使得我们可以更有效地利用人类数据来训练和控制机器人,使其能够执行类似人类的动作和任务。
HumanPlus模型结构
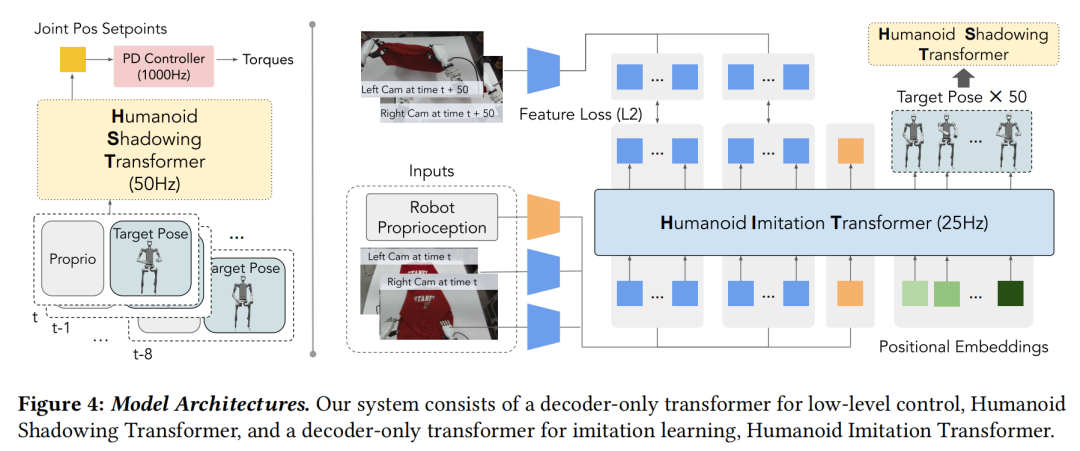
HumanPlus的模型结构包括两部分,第一部分是在仿真环境中训练人形影子变换器(Humamoid Shadowing Transformer),即通过仿真软件基于强化学习训练出一个可以让机器人既能像人的影子一样跟随动作又可以满足自身的物理特征做到平衡的低层控制器(上图左侧);第二部分是通过人类数据进行模仿学习训练(Humamoid Imitation Transformer,HIT),将第一部分训练的低层控制器零样本部署到真实世界中的人形机器人上进行实时影子跟踪。
在Shadowing部分,人类操作员站在人形机器人附近,将其全身实时动作像影子一样投射到人形机器人上,人类操作员通过视线观察环境和人形机器人的行为,确保系统的响应速度和灵活性,从而实现高效的遥操作。这部分的低层控制器的输入是仿人的本体感知和仿人的目标姿态,本体感知包括基准状态(滚动、俯仰和基部角速度)、关节位置、关节速度和上一次动作。本体感知观测值仅使用机载传感器测量,包括一个IMU和关节编码器。仿人的目标姿态包括目标前进和侧向速度、目标滚动和俯仰、目标偏航速度和目标关节角度等。我们使用单个RGB摄像头实时估计人体和手部姿态,并将人体姿态重新定向为人形机器人的目标姿态。输出是19维的仿人身体关节位置设定点,这些设定点随后转换为力矩信号。
在Autonomous Skills部分,机器人通过模仿学习,自主学习到了一些人类技能并完成相应任务。人形机器人模仿学习框架(HIT)要求机器人不仅仅是模仿而是能像影子一样跟随,并自主学习从自身观察中获取的信息,以发展出新的技能。机器人不仅需要本体感知信息,还需要处理左右眼的RGB图像。它的输入是两个第一人称视角的RGB摄像头采集的图像、本体感知和固定位置嵌入。输出是预测的目标位置,并将其发送给低层人形影子变换器,同时丢弃预测的未来图像特征标记。它相当于是学了一个左边底层控制器的输入,也就是我们希望这个机器人去什么样的目标姿势。
3. 一些问题
怎么理解人形机器人和人体的影子结合
将人形机器人和人体做影子结合它不只是零重力结合。在零重力环境中,机器人不再受重力影响,因此不需要学习如何应对重力。例如,机器人漂浮在太空中时,它可以自由移动而不受重力约束,容易与人类动作相匹配。然而,重力在地面上的作用是一个挑战,比如人可以单脚站,但如果机器人也学人单脚站,很可能失衡或倒下。
人形机器人控制路径对比
首先,目前市面上的大多数机器人只能做基本的前后走动,甚至有些连站立都困难。它们缺乏多样性,例如无法像人类一样做手臂动作或者蹲下去拿取低处的物体,这些动作对于现有的大多数机器人来说是不可实现的。HumanPlus的一个特点是,上肢和下肢都是通过同一个神经网络来训练的,它的协调性很好。
仿真环境中的真实度问题
仿真环境里的物体,无论多么真实,人眼实际上是可以分辨出来它是真的还是假的。一般人眼能看出来的东西,神经网络也可以。神经网络在区分物体时非常擅长注意到细微的差异,即使是小小的细节也能察觉到。当前的仿真器可能能够处理不同颜色和重量等方面的变化,但在处理软度、形变和复杂的视觉场景时,模拟效果会变得困难。
更换硬件要怎么做?
虽然训练过程是相似的,但更换人形机器人硬件需要重新训练算法,因为不同的机器人具有不同的关节长度和重量,这些因素会影响其运动控制能力和平衡性。
为什么用单个RGB摄像头
现在的想法是希望使用单个摄像头更好地模拟已有视频的采集方式。例如,如果我们使用VR或者全身外骨骼或动作捕捉系统,一方面这种做法非常贵,另一方面它也没有办法很好的匹配现有互联网上数据。现在的第一步是先确保整个数据处理流程顺利运行,而不是立即依赖互联网上的数据进行学习。第二步才是考虑如何利用互联网上的数据进行进一步的学习。
关于分层与端到端问题
Mobile ALOHA是一个端到端的模型,它没有传统意义上的规划阶段,因为传统方法通常需要先制定一个详细的计划然后执行。我们现在采用的是端到端的方法,从感知直接到执行。规划其实相当于直接融合到了神经网络的权重里去了。我更倾向于选择端到端的路线,而不是分层具身路线。如果数据来源相同,就无需进行分层处理。唯一可能需要分层处理的是人类数据,因为其中一部分数据来自仿真环境,另一部分来自真实世界的机器人和人类数据。但这个和感知-规划-执行的分层也不一样,它更多的是一种数据利用的分层。
4. 一些补充
HumanPlus: Humanoid Shadowing and Imitation from Humans的作者包括Zipeng Fu, Qingqing Zhao, Qi Wu, Gordon Wetzstein, Chelsea Finn,其中Zipeng Fu, Qingqing Zhao, Qi Wu是这篇论文的共同一作。Mobile ALOHA: Learning Bimanual Mobile Manipulation with Low-Cost Whole-Body Teleoperation的作者包括Zipeng Fu, Tony Z. Zhao, Chelsea Finn,其中Zipeng Fu, Tony Z. Zhao是这篇工作的共同一作。
ROBOT DATA系列已经更新到第五期,前面四期分别是:EP 1:ATM机器人如何从人类视频数据中学习对话高阳、汶川:如何利用互联网人类视频训练机器人大模型(ATM—RSS 2024满分论文),EP 2:UMI夹爪形态的简易动捕设备对话迟宬、许臻佳:UMI——机器人训练的物理API,EP 3:Open-TeleVision 利用头显遥操机器人对话程旭欣:Open-TeleVision教你如何沉浸式遥操机器人,EP 4:MimicPlay和DexCap则是结合了人类视频和动捕数据训练机器人对话王辰:MimicPlay & DexCap——如何利用人类视频和人体动捕数据进行机器人训练感兴趣的朋友可以看之前的几期内容。
References:
https://humanoid-ai.github.io/
https://mobile-aloha.github.io/