Robot Data系列前六期聚焦在机器人操作数据相关的论文,这一期我们将第一次探讨机器人移动问题。Robot Data这个话题下,大规模仿真+强化学习解决移动(Locomotion)可能是在当今机器人学习领域共识度最高的路线。从2020年开始,用强化学习在英伟达IssacGym上解决四足移动的论文持续获得了很高的关注。来到2023年末,随着硬件的突破,用强化学习解决双足人形移动的问题逐渐获得了更多的关注。
在Robot Data第七期,我非常荣幸能够邀请到在四足和双足人形移动方面非常有代表性的两个工作Robot Parkour Learning和Humanoid Parkour Learning的指导老师赵行和一作庄子文来为大家介绍机器人移动相关问题。因为赵行老师在自动驾驶行业的深厚积累,我们也探讨了自动驾驶作为初代具身智能落地代表,在数据方面的历史经验。
Robot Parkour Learning:Ziwen Zhuang*, Zipeng Fu*, Jianren Wang, Christopher Atkeson, Sören Schwertfeger, Chelsea Finn, Hang Zhao;*共同一作
Humanoid Parkour Learning:Ziwen Zhuang, ShenZhe Yao, Hang Zhao。
赵行是清华大学交叉信息研究院的助理教授,MARS实验室的负责人,研究兴趣包括多模态机器学习、自动驾驶和机器人技术。赵行曾在Waymo(即谷歌的自动驾驶项目)担任研究科学家。在此之前,他在麻省理工学院(MIT)师从Antonio Torralba教授获得了博士学位,在浙江大学竺可桢学院获得了学士学位。赵行也是国内具身智能创业公司星海图的联合创始人。
庄子文是清华大学交叉信息研究院的一年级博士生,研究方向包括运动智能、具身人工智能和机器人技术。庄子文在上海期智研究院担任研究助理,由赵行教授指导。在此之前,他曾是上海科技大学MARS实验室的成员,师从Soeren Schwertfeger教授。
非常感谢两位学者的细致解读,相信以下文字可以让你对大规模仿真+强化学习对解决局部移动问题,以及自动驾驶行业的数据经验有新的认知,Enjoy!
查看原文目录
以下为本文目录
👇
第一部 对话庄子文:大规模仿真下的机器人跑酷
1. Robot Parkour Learning方法介绍
2. 仿真+RL之于Locomotion
3. 仿真的Sim2Real Gap
4. 关于具身数据集
5. 控制理论 vs 强化学习
第二部 对话赵行:机器人跑酷和自动驾驶—机器人数据从哪里来
1. Robot Parkour解决的核心问题
2. RGB视觉之于未来机器人的感知
3. 自动驾驶行业在数据问题上的历史经验
4. 特斯拉怎么做端到端模仿学习的呢?
5. 自动驾驶仿真—感知仿真vs行为仿真
6. 行为仿真数据—训练or测试
7. 感知仿真—Real2Sim
8. 关于机器人学习的路线
一些想法
第一部 对话庄子文:大规模仿真下的机器人跑酷
1. Robot Parkour Learning方法介绍
跑酷任务在机器人学习中的应用,特别是在四足机器人和人形机器人的不同实现中,通常分为三个阶段:预训练、微调、和蒸馏。
阶段 1:带有软动力学(Soft Dynamics)约束的强化学习预训练
在强化学习预训练阶段,我们引入Soft Dynamics约束。Soft Dynamics 的概念源于模拟器中物理碰撞的局限性。在传统的模拟器中,物体只能发生硬碰撞。例如,当机器人腿部遇到地形时,只能直接发生碰撞,无法实现逐步减少的穿透效果。而在 Soft Dynamics 中,当我们在系统中编写代码时,我们知道某处有一个障碍物,但在实际的模拟环境中并不告知机器人这个障碍的存在。这样一来,模拟器在进行物理模拟时,当机器狗接近该区域时,不会计算碰撞。然而,当它实际穿透这个障碍物时,我们通过奖励函数给它一点惩罚,告诉它这种穿透是不正确的,从而降低其奖励值。
Soft Dynamics
阶段 2:带有硬动力学(Hard Dynamics)约束的强化学习微调
在强化学习的微调阶段,我们严格执行所有动力学约束,并在真实的动力学条件下对预训练阶段学到的行为进行微调。把障碍物实际放上去的时候,在模拟中允许机器人进行微调,因为在模拟环境中,轻微的穿透可能不会导致问题,但在现实环境中,如果真的有障碍物挡在那里,轻微的穿透就行不通了。为了适应这种差异,机器人需要在模拟中进一步微调,以确保在实际环境中也能顺利应对障碍物。
Hard Dynamics
阶段 3:通过蒸馏学习基于视觉的跑酷策略
在学会每个单独的跑酷技能后,我们使用 DAgger 算法将这些技能蒸馏为一个基于视觉的跑酷策略。这个策略可以在只依赖机器人自身的感知和计算能力的情况下部署到四足机器人上。
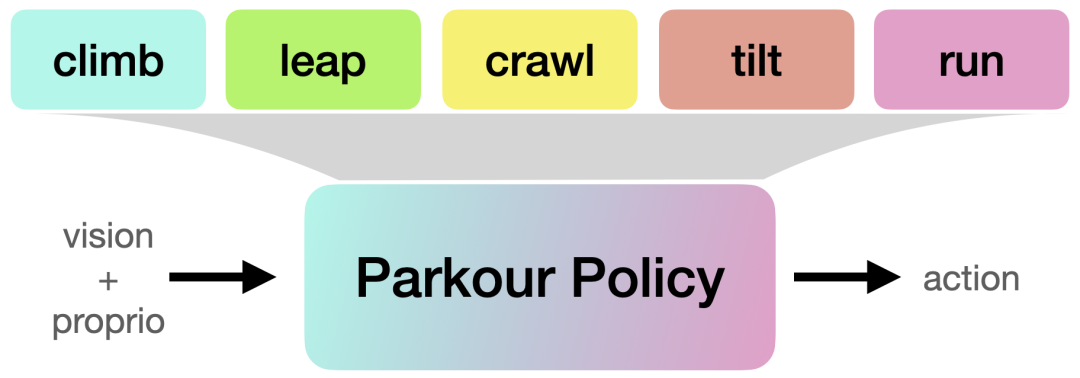
Distill
关于蒸馏,它的初衷其实是为了解决几年前 Isaacgym 渲染速度过慢的问题。在 Isaacgym上,用 3090 显卡进行渲染时,速度非常慢。比如,如果在不渲染的情况下,完成一次强化学习训练可能只需要 3 个小时,但如果启用渲染,可能需要长达三天的时间,差距非常明显。因此,蒸馏的解决方案是先伪造一个传感器,让它去感知地形信息,然后通过蒸馏的方法让模型学会如何在真实世界中使用传感器来应对地形,或是encode这个地形。其实,只要问题定义得足够清晰,即使使用 4090 显卡直接进行训练,也可以不用蒸馏。
蒸馏的另一个重要好处是可以更方便地更换传感器。例如,你可以先使用深度相机进行训练,然后如果发现深度相机效果不佳,可以通过蒸馏将知识迁移到激光雷达等其他传感器上。这样,换传感器的成本就会降低,因为你不需要从头开始重新训练模型,这是蒸馏方法的一个显著优势。
2. 仿真+RL之于Locomotion
在2020年之前,强化学习领域的学者以及在做机器人移动(Locomotion)研究的学者都在努力提升算法的效率。像 MuJoCo 和 PyBullet 这样的仿真平台主要依赖 CPU 进行模拟,每台服务器最多只能同时运行 256 个模拟器。2020年,瑞士联邦理工学院(ETH)的 Marco Hutter 团队(RSL 实验室)的一名成员在英伟达实习,决定尝试通过增加数据量来提升效果,并利用英伟达的资源在 Isaac Gym 平台上进行了大规模的仿真实验,这可以说是最早的一次大规模仿真尝试,结果一试就成功了。英伟达显卡的并行处理是其强项,一上来就能同时运行 4,096 个模拟器,这就是一个通过规模化实现突破的例子。自此之后,几乎没有人再提强化学习算法的效率问题了。
3. 仿真的Sim2Real Gap
在Locomotion方面,Sim2Real Gap的问题目前已经有很好的解决,但操作方面还有很多挑战。操作研究通常简化了整个物理过程,导致很多操作模型的定义实际上违反了物理定律。例如,在操控一个物体时,需要施加足够的力,但操作库或模型输出的指令可能忽略了物体的重量,可能导致无法实际搬起物体。因此,模型在实际应用中的表现总会存在与真实情况之间的差距,因为总会有一些被忽略的因素。
此外,在进行操作时,碰撞面和碰撞关系非常复杂。例如,当用手指操作物体时,涉及到大量的碰撞面,这使得模拟更加复杂。相较于机器人移动任务,操作的碰撞数量级更大,因此模拟器的实现也变得更加困难。当前许多通用模拟器采用的是迭代式的仿真方法,它们通过计算下一个时间点的系统状态来进行模拟。这种方法虽然可以逐步逼近真实情况,但也存在模拟精度的问题,尤其是在处理复杂碰撞和物理交互时,这使得模拟过程更加复杂和计算更加密集,这种复杂性往往会导致仿真速度变慢。
4. 关于具身数据集
在整个具身智能的研究中,以前做计算机视觉的很多研究人员习惯于使用大家公认的标准数据集和指标,这种惯性导致在新领域也希望有一个统一的数据集供大家训练和测试,以便在公认的指标上进行竞争。例如,最早Imagenet出来后,成功率指标是非常直观的指标,后来出现了一些基于Transformer的可视化图,大家也可以从中去分析问题。但在机器人领域,目前还没有足够直观或者说被广泛认可的数据集出来,这样的标准还没有完全形成。尤其是当数据集无法涵盖所有可能的情况,或者是即使没有真机的一些课题组也可以用的数据集,这种情况还没到来。
此外,机器人领域的任务成功率通常较低,很多操作任务的成功率可能都在10%以下,甚至更低。因此,成功率的细微差异(比如从3%到4%)并没有显著的区别。这种低成功率和指标的不确定性,使得评估机器人性能更加复杂。为了提高成功率,机器人操作往往在简化的场景下进行机器人系统的测试,但简化场景下的问题也变得相对简单,这样的系统在真实世界中可能无法有效处理复杂的情况。我们可以看到,许多成功率较高的工作在展示时的视频都是经过加速的,有些甚至需要加速四倍、八倍,即使是稍微好一些的系统,可能也需要加速两倍来显示机械臂的动作。这是因为,在许多早期的机器人操作任务中,问题被简化为所谓的准静态动力学(Quasi-static Dynamics)。
这种简化忽略了许多动态因素,比如一个物体突然掉落的情况。这也意味着,机器人无法完成需要动态处理的任务,比如铺床单或抖动衣物。而在准静态动力学设定中,这些复杂的动态操作从定义上就被排除了。因此,ALOHA在技术上产生了较大的影响力,因为它们几乎全部都是实时的,它把控制问题引入到学术界的视野。最早引起这一关注的是宋舒然组的几篇工作,包括Swingbot,他们明确指出,机器人在操作时必须考虑动力学因素,包括环境的高速移动和惯性等。
在人形机器人领域,直接将收集到的人类数据集映射到机器人上,并不符合物理定律。如果你看过一些早期计算机图形学领域的工作,他们往往通过人类的视频数据训练神经网络,然后让神经网络生成一系列人的行为动作。然而,这种研究的一个问题在于,生成的动作经常不符合物理定律。例如,有些动画中人会像走太空步一样,在地面上滑动,这种现象就是典型的不符合物理定律的表现,这中间还是需要一层网络来将人类的动作映射为机器人能够执行并满足物理定律的动作。
5. 控制理论 vs 强化学习
从数学角度来看,强化学习和控制理论确实有很多相似之处。但强化学习涉及到大量的概率分析,比如对先验和后验分布的分析。而在控制理论中的规划和系统动力学通常是确定性的,系统的行为是可以精确预测的。相比之下,强化学习则是通过不确定性的方式来建模。这两者的联系主要体现在这些方面。
对于强化学习来说,它的最大优点在于能够应对突破边界的意外场景。比如,Deep Tracking Control这篇文章中提到的,MPC(模型预测控制)和类似的算法在应对这些意外情况时存在局限。具体来说,MPC 在规划过程中,面对小范围的偏差,比如Atlas机器人在跳跃时目标平台距离原计划有0.1米时,只需稍微调整力道即可解决。然而,当情况变得更复杂,例如目标平台距离为0.5米,超出了机器人的跳跃能力时,MPC可能无法及时调整并规划出有效的保护动作。这种情况下,机器人可能会碰撞到平台,导致损伤。而强化学习能够处理这些突破边界的意外情况,通过学习和适应,能够在面对超出预期的挑战时,规划出新的应对策略。
第二部 对话赵行:机器人跑酷和自动驾驶—机器人数据从哪里来
1. Robot Parkour解决的核心问题
Robot Parkour Learning获得了2023 CoRL最佳系统论文提名,这说明我们的整体系统设计比较完善,而不仅仅是某个单点技术的突破。关于跑酷工作,我认为核心问题主要有两个方面:一是如何设计和调整一个有效的训练策略,二是如何克服Sim2Real Gap。训练策略的设计是一个复杂的任务,涉及不同动力学约束的强化学习训练,以及技能模型的蒸馏。
过去,四足的工作不带视觉,主要依赖本体感知,而现在,我们引入了视觉感知,特别是双目深度相机,Sim2Real Gap问题在引入视觉系统后变得尤为重要。为了有效地克服Sim2Real Gap,我们需要在仿真中尽可能真实地模拟视觉感知中的深度,同时调整真实世界中的数据,使其尽量接近仿真器中的理想图像,将仿真数据和真实数据的分布尽可能接近,从而缩小这两者之间的差距。
在缩小Sim2Real Gap过程中,我们采用了多种方法进行尝试,比如填洞、去噪等,深度图在这方面表现尚可。在跑酷任务中,挑战相对简单,主要是克服地形,而克服地形的关键在于了解其深度。但是未来真正的实用机器人不应仅仅依赖深度图,而需要能够处理RGB图像。
此外,Multitask Learning(多任务学习)在机器学习中一直是一个长期存在的问题。当一个模型同时学习多个任务时,不同任务的回传梯度往往会发生冲突,会遇到每个技能的性能下降的问题。调试单个技能其实比较容易,但同时调试多个技能则很困难。因此,子文在尝试了各种方法后发现了一个比较好的策略:先单独训练每个技能,将这些技能作为教师模型,然后共同训练一个学生模型。这样的方法可以最大限度地减少性能下降,最终的成果是一个系统化的解决方案,不只是单点创新,而是全面提升了能力。
2. RGB视觉之于未来机器人的感知
目前,利用强化学习训练机器人处理RGB图像遇到的Domain Gap还是很难克服的。这也可能是今年或者明年大家研究里非常想去解的一个问题:机器人不再依赖深度图或者点云图,而是仅仅通过RGB图来感知。RGB图像包含丰富的信息,包括物体的材质、地面的特性以及周围的环境。例如,它可以显示一个标志,指示某个区域不可进入。这些语义信息在RGB图像中非常丰富,提供了深度图无法提供的详细上下文。
解释:这里提到的RGB是相对于点云信息,RGB图像由红、绿、蓝三种颜色通道组成,可以捕捉场景的彩色视觉信息。每个像素点记录了颜色信息,组合成我们肉眼可以看到的图像,目前互联网上存在的大量图片和视频数据也是RGB数据。点云是一组三维空间中的点,每个点包含位置坐标(X, Y, Z)和有时附带的强度值等信息。它通常由激光雷达或深度相机生成。
首先RGB不一定只有二维感知能力,双目RGB也可以提供深度信息。我这里强调RGB的意思是,从未来发展的角度来看,大概率不会使用激光雷达或者深度相机的点云,而是会选择单目或者双目的RGB,这不仅仅是出于成本的考量,更重要的是泛化性。单目或双目的RGB在视觉感知模块中具有最好的泛化性,因为数据量最大。互联网上有海量的通过相机和视频拍摄的RGB数据,它符合构建感知大模型(Foundation Model)对庞大数据量的需求。
我们需要参考现在互联网上有多少文本数据量才能训练出语言大模型,视觉或者视频是有机会训出感知大模型的。但其他传感器的数据,比如激光雷达、深度相机,甚至力学,触觉,几乎不可能成为感知大模型的基础,主要原因是这些领域连标准都没有。到目前为止,激光雷达还没有一个大家广泛接受的标准,无论是数据格式、传输、压缩方面都缺乏统一标准。在这种情况下,很难真正开发出感知大模型。
视觉数据之所以有如此大的优势,是因为它依赖于已经非常成熟的相机行业,再加上互联网在视觉数据的压缩和传输方面也非常方便。因此,未来机器人感知大模型很可能是基于RGB数据的。现阶段多传感器融合的三维重建是有用的。但从长期来看,IMU 加上激光雷达的数据很难进入到感知大模型里,可能还是会和机器人数据管道解耦。这些数据可以帮助生成更好的真值数据集,或者作为测试集的基准。
3. 自动驾驶行业在数据问题上的历史经验
在自动驾驶发展的初期,并没有如今机器人行业面临的数据短缺以及Scaling Up的问题。早期,自动驾驶都是依赖传统的机器人学方法,这些方法就是通过建图来识别静态环境,用激光来识别动态障碍物,利用规则结合搜索优化算法来规划自动驾驶汽车的轨迹,从而解决导航和移动问题。因此,自动驾驶的移动问题在那之前几乎都是通过传统方案来解决的。当时大家并没有深入考虑数据的重要性。
以Waymo为例,2009年开始涉足自动驾驶,为什么选择那个时间点呢?这是因为他们观察到了2004年和2007年的DARPA Urban Challenge,在那些比赛中,各个高校参赛团队已经能够通过传统的机器人学方法实现自动驾驶。这种传统方法通常是模块化的,比如感知分为检测与跟踪,地图包括高精度建图和定位,规控包括轨迹预测、位置速度规划等等。参赛团队看到了这些传统技术的可行性,因此Waymo在2009年开始投入自动驾驶,并且一直沿用了2007年DARPA Urban Challenge的技术路线。
实际上,到了2016年,自动驾驶真正火爆起来时,大多数人仍然沿着Waymo的路线在推进,包括百度阿波罗也在较早期进行探索,基本上也是遵循这套技术路线。我认为真正的转折点是在2017年和2018年,特斯拉开始全面采用AI路线,从那个时间点开始,大家才逐渐意识到并开始探索用AI方法来解决自动驾驶问题。特斯拉开创了一个全新的方向,他们提出了完全通过AI、端到端地解决自动驾驶问题的理念。我认为这确实是特斯拉开了先河,改变了大家的思考方式。正是特斯拉的这种创新,使得大家对在机器人领域采用类似的模仿学习方法充满了信心,认为这种方法也可以在机器人领域取得成功。
在自动驾驶行业,最初大家认为有些公司的强大算法能力会带来明显的优势,但现在来看,纯靠算法的公司优势已经不明显了。实际上,跑的快的公司不是这些有算法优势的公司,反而是主机厂,比如国内的新造车势力和特斯拉,这些公司和专注于做自动驾驶算法的创业公司比也许算法不是最好的,但通过成功建立数据闭环,他们的实际自动驾驶体验是很不错的。这些主机厂之所以能跑得更快,核心原因是他们拥有大量的数据,他们需要做的事情就是对这些数据筛选和自动标注,然后再训练模型,问题就解决了。
4. 特斯拉怎么做端到端模仿学习的呢?
公开信息虽然不多,但大家普遍认为特斯拉的方法是通过图像作为输入,轨迹或控制信号直接作为输出,训练了一个模型。不过,这个模型中还有一些中间输出,比如占用图、车道线检测和物体检测的输出。基本上,这是一个多头(Multi-Head)模型,而其中最重要的Head是规划出来的轨迹或控制信号的。包括所有的中间输出,整个模型是直接进行训练的。
而他训练的数据来源就是所有卖给车主在路上跑的Tesla车,这种方法非常巧妙。用现在机器人的数据视角来看,特斯拉的方法其实就是一个同构遥操作,类似于Mobile ALOHA。驾驶员操作与机器人本体相同的系统,不断收集数据,收集后直接用来训练模型。特斯拉给出了一个最佳示范,证明这条路径可以达到非常高的上限,虽然还未完全达到L4水平,但已经非常接近。
5. 自动驾驶仿真—感知仿真vs行为仿真
仿真可以分为几个部分:感知的仿真,比如激光雷达和视觉图像的仿真;行为的仿真,比如模拟其他车辆的行驶轨迹。对于机器人来说,可能还有动力学仿真和物理参数的仿真,因机器人在操作时,需要与物体接触。在自动驾驶领域,主要关注的就是感知的仿真和行为的仿真。Waymo在行为的仿真这方面做了很多工作。几年前,Waymo的主要宣传点就是他们拥有几千万英里的真实驾驶数据,再加上几千万英里乘以一千到一万倍的仿真数据。
Waymo这里提到的仿真指的是行为仿真。比如,在真实驾驶中遇到一个醉汉以一米每秒的速度穿过马路,Waymo可以通过仿真将他的速度调整为两米每秒或0.5米每秒,从而生成新的行为数据。类似地,在执行无保护掉头时,可以模拟对方车辆是否让行,从而仿真出各种不同的行为数据。
而像特斯拉这样的公司,更倾向于做端到端的解决方案,因为他们的数据主要是图像数据,因此更倾向于做感知的仿真。感知的仿真在过去,包括特斯拉和英伟达在内的一些公司,会在游戏引擎中渲染新的场景进行感知仿真。特斯拉之前在这方面做得很多,但最近由于他们拥有大量的真实数据,已经不再需要依赖仿真,所以他们现在可能不再进行仿真。总体来说,对于数据量足够大的公司,大概率不会那么需要仿真。
6. 行为仿真—训练or测试
预测是用来预测其他车辆的行为,而规划是用来规划自己车辆的行为,当这两者结合起来时,就形成了一个行为仿真器。这种行为仿真器生成的数据被广泛的应用在了测试中,但没有被广泛应用在训练中。原因在于,仿真数据的分布与真实数据之间存在偏差。如果将仿真数据用于模型训练,可能会把我的模型带偏,特别是当仿真数据与真实环境差异较大时。
尽管如此,仿真数据在测试中仍然有价值。它可以用来验证模型在处理各种边界情况(Corner Cases)时的能力。我们可以将仿真数据视为这种边界情况,就是他很假,但假也有用,假就是这个边界情况。通过测试模型在这些情况下的表现,来评估模型是否能够在超出其能力边界时仍保持安全驾驶。
7. 感知仿真—Real2Sim
最近几年计算机视觉领域最大的进展有两个方面:一个是视频生成模型,另一个就是可微分渲染(NERF和3D GS)。我认为可微分渲染尤其值得关注。过去的感知仿真主要依靠数字资产的绘制和游戏引擎的渲染,但无论我们如何绘制资产,都很难复刻真实环境中物体的多样性分布,所以我认为纯仿真这条路很难走下去。现在可微渲染给我们提供了一个新的思路,那就是基于一条真实数据,利用3D GS渲染新的视角,合成出新的数据。具体来说,我们可以基于一条真实的路测视频,渲染出”我如果开在旁边这条车道可能看到什么样的图像?” 这种方法我们把它称为Real2Sim。
Real2Sim2Real的流程基本如下,通过采集机器人的真实数据,在仿真器中对这些真实数据进行增广。接着,可以用这些合成数据来训练模型,最终在实际环境中使用。3D GS 是纯视觉的,主要关注物体的新视角渲染,但并不模拟物体的物理特性或动力学。
8. 关于机器人学习的路线
当下比较主流的机器人学习技术路线:在操作方面,主要依靠模仿学习;而运动控制方面,依靠强化学习;这种算法组合是较为明确的。至于数据问题,强化学习的数据靠高度并行化的仿真器;模仿学习的真机数据通过遥操作采集,包括VR遥操作或同构遥操作等,采集到的真实数据可以做数据增强来提升模型训练的泛化性。当下主流的技术路线差不多是这些,对于学术界来说,我们要持续探索数据效率更高的算法,对于业界来说,要找到合适的商业场景并将数据闭环。
未来的数据利用确实可能会形成一个金字塔结构,包括真实机器人数据、仿真数据和视频数据。拥有更多真实数据会使模型的性能更强,这是确定的。仿真数据的效果则取决于仿真的质量,仿真数据的价值可以通过仿真质量的高低来衡量。高质量的仿真数据系数大,低质量的则系数小。让机器人从视频数据中学习,尤其是开放世界中的视频数据,是未来的最终目标,但还需要进一步的科研探索。
一些想法
最近一段时间,国内外在机器人领域的创业公司每隔一阵子都会公布最新的进展,持续刺激这个行业的热度。与此同时,也有越来越多的人持续涌入机器人创业浪潮,作为关注这个领域的早期投资机构打工人,身在其中,每天都可以有惊喜,当然也充满了遗憾。具身智能的这波热度已经持续了一年半,在肉眼可见的未来半年,随着硬件demo的持续进化,热度应该依然可以持续。
在持续的热度和眼花缭乱的demo里,我非常庆幸能够以文字的形式记录下和这些优秀学者的对谈。把如今的困惑和突破通过一系列对最有代表性论文的探讨记录下来,也许在三年、五年或十年后,再回头看这些文字的时候,会不禁感慨,原来当初的主流路径并非最后work的路径,感谢某些人在某些方向上的坚持不懈,通用机器人才得以实现。
References:
Robot Parkour Learning
Robot Parkour Learning, Ziwen Zhuang* Zipeng Fu* Jianren Wang Christopher Atkeson Sören Schwertfeger Chelsea Finn Hang Zhao
https://robot-parkour.github.io/
Humanoid Parkour Learning
Humanoid Parkour Learning, Ziwen Zhuang; ShenZhe Yao; Hang Zhao
https://humanoid4parkour.github.io/