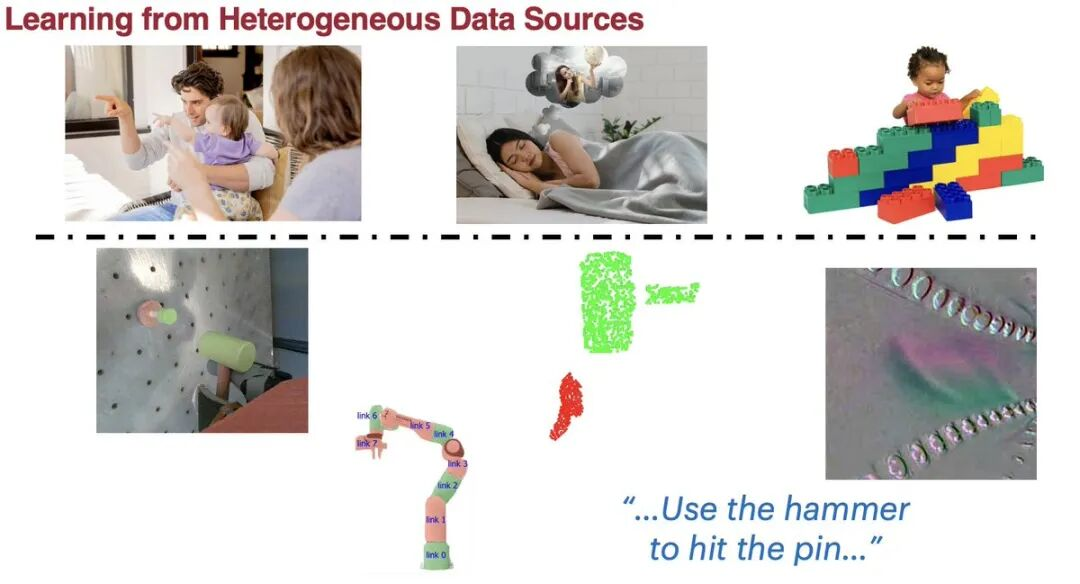
Robot Data前八期,我们围绕着机器人数据金字塔,分别介绍了利用人类视频、动捕、遥操、仿真等方式获得数据进行机器人学习的优秀工作。这些工作通常只聚焦利用单一数据突破机器人学习问题。那机器人学习是否可以将这些多模态数据综合利用呢?答案是肯定的,也是必须的。参考人类与物理世界交互学习的过程就是多种模态的数据融合过程,比如小孩子会在脑子里模仿动画片里的人物动作(仿真数据),也会模仿大人的动作(人类视频数据),在一些任务完成不好的时候需要大人手把手示教(遥操)。正式在多种维度的数据帮助下,人类可以在一些任务上完成的越来越好。
那如何处理机器人领域中极为异构的数据集和任务呢?机器人数据来自不同领域,如仿真环境、真实机器人操作以及人类视频演示。我们今天介绍的论文Policy Composition (PoCo)可以使用扩散模型在不同领域、模态和任务之间进行数据的组合。所组合的策略在具有普遍适应性的工具使用任务中展示了强大的场景级和任务级的泛化能力。
我非常荣幸的邀请到PoCo论文的一作王理睿博士来讲解PoCo这篇论文。王理睿目前是MIT的博士生,导师是MIT CSAIL的Russ Tedrake教授。他还与Kaiming He教授密切合作。在来到MIT之前,他在华盛顿大学获得了本科和硕士学位,与Dieter Fox教授合作。他的研究兴趣在于机器人技术和机器学习,特别致力于开发能够在复杂且无结构的现实环境中进行泛化的机器人算法和系统,从事于可以处理异构机器人数据的群体学习研究。
PoCo: Policy Composition From and For Heterogeneous Robot Learning的作者包括Lirui Wang, Jialiang Zhao, Yilun Du, Edward Adelson, Russ Tedrake,它被RSS 2024收录。
查看原文目录
以下为本文目录
👇
1. PoCo介绍
2. PoCo的核心思想
3. 如何理解跨Domain的数据融合?
4. 怎么理解Policy Composition?
5. 为何特别关注异构数据?
6. PoCo只针对工具使用类的任务吗?
7. 为什么加入触觉信息?
8. 其他关于PoCo的问题
9. 关于HPT
10. 关于Fleet Learning
一些想法
1. PoCo介绍
如何应对机器人领域中极为异构的数据集和任务?机器人数据来自不同领域,例如仿真环境、真实机器人操作以及人类视频。我们研究了使用扩散模型的策略组合(PoCo)方法,以应对这些挑战。
PoCo介绍
我们专注于能够泛化的机器人工具使用任务,这些任务强调了在现实世界操控中的组合性和丰富的接触特性。工具使用任务在机器人应用中非常重要,并且有大量真实人类视频资源可供使用。为支持这一研究,我们在Drake仿真环境中开发了一个基准测试。
Data
PoCo 的核心理念是优化动作轨迹的组合能量景观。这个推理过程无需重新训练,可以应用于不同的任务(例如锤子和扳手任务)、行为(例如平滑度成本目标)和领域(例如仿真和现实环境)。
PoCo方法简介
PoCo 展示了在不同场景中的泛化能力,能够适应变化的物体和工具姿态、干扰物、新物体以及动态场景。受人类学习方式的启发,PoCo 能够在不同模态(如RGB、点云、触觉)和领域(如仿真、真实机器人、视频)中组合策略。
我们组合的多任务策略在具有外部接触、可变形物体、强力操控和外部干扰的任务中展示了任务级的泛化能力。此外,它在这四个工具使用任务中的表现也优于直接在多任务上训练的无条件策略。
工具1-饭勺子
工具2-扳手
工具三-小锤子
工具四-刀子
2. PoCo的核心思想
机器人数据获取难度大很大一部分原因是机器人的形态很多,在不同的机器人上,会有不同的方法来表示它们的某些模态,分散的机器人载体和多模态的数据模式是导致目前机器人没有完整模型的一个主要原因。我们提到的多模态,即包括RGB视觉信息、文字信息也包括点云和触觉等这些对灵巧操作任务至关重要的信息模态。为了与目前大家常说的多模态大模型里的模态加以区分,我们将这些数据类别统称为多样性(Heterogeneity)而不再称之为多模态。
除了数据多样性问题,机器人训练所用到的数据领域(Domain)也存在巨大差异,比如人类视频、真实机器人数据以及仿真数据,这也是机器人学或具身智能领域特有的挑战。每个Domain都有自己的优势和劣势,仿真中我们可以生成大量数据,但有些东西可能无法模拟,存在仿真与现实之间的差距;人类视频数据在网上有大量可用,但可能缺少动作标签,训练起来较难;而真实机器人数据非常昂贵,因此,跨Domain的研究非常困难。
如何将机器人训练数据多样性和跨多个领域的数据组合起来,提高机器人训练的通用性是PoCo这个工作最核心的思想。在PoCo中,我们把不同的策略拆分成了几个层次:第一,Task Level:在不同的任务,比如不同的工具使用,我们可以进行一些训练,使用 classifier-free的diffusion training。这样就可以在任务层次上进行组合,利用不同的工具。第二,Domain Level:在不同的领域来源,比如仿真和真实机器人上进行组合。我们可以研究如何将这两个领域的策略组合在一起。第三,Behavior Level:在测试时可以指定一些成本,比如让它的行为更加顺滑或者更加安全。我们可以直接手动编写一些任务或目标,然后进行组合。
3. 如何理解跨Domain的数据融合?
在真实机器人上,我们有一些传感器,例如摄像头、手部摄像头和第三视角摄像头,还有触觉传感器。在我们进行远程操作时,这些传感器会收集数据,这些数据可以用来训练模型,并且模型也可以工作,但常常会有一些问题,例如泛化能力不足。我们发现,很多时候这些演示数据会导致模型过拟合。举个最基本的例子,在一个桌面环境中,机器人需要用锤子去敲击钉子。如果我将钉子的位置移动到一个模型训练时未见过的位置,它可能就无法正确执行任务了。更不用说在场景中添加障碍物或快速移动目标物体了,这些都会暴露出模型在泛化能力上的问题。
然而,在仿真环境中,针对这些场景相关的挑战,可以很容易地被设计出来。在仿真环境中,我们可以添加各种杂乱的物体,并使用规划器生成演示数据。这样一来,基于仿真训练的策略甚至可以通过另一种模态(比如点云数据)表现出更好的泛化能力。
因此,在测试阶段,如果我们有两个策略——假设一个来自仿真,一个来自真实机器人操作,且它们已经分别完成了训练,我们能否将它们结合起来,从而实现两者的优势互补?也就是说,既能保有现实世界中的流畅动作,又能利用仿真环境中的泛化能力。这正是这篇论文的动机所在。
我们假设这两个策略已经各自训练完毕,且在训练过程中并没有共享数据。例如,一个公司训练了一个模型,另一个公司也训练了一个模型。现在我们想将它们结合起来,以在两个模型都未曾见过的全新场景中进行测试,看看能否实现更好的泛化能力。在机器人领域,我们可以将这种情况称之为组合泛化(compositional generalization)。举个例子,我们可以用锤子来钉钉子,也可以用扳手来拧螺丝。然而,如果我们想用扳手来钉钉子(tool use generalize to tool use),直接训练一个基于RGB的策略往往是无法实现的,我们可以通过策略组合(policy composition)的方式,实现这种组合泛化的能力。
4. 怎么理解Policy Composition?
Policy Composition就是每个领域的策略都是在各自的领域中独立训练的,然后将这些训练出来的策略进行组合。策略的组合(policy composition)其实并不常见,基本上很少有人做这种工作。我们之所以能够进行这种组合,是因为我们利用了扩散策略(diffusion policy)这个隐式模型的结构。
具体来说,扩散策略学习的是一个能量景观(energy landscape),它隐式地表示了这个能量景观。所以我们可以将两个或多个能量景观组合起来,而这在之前的研究中是比较少见的。另一种理解这种方法的方式是想象做梯度下降(gradient descent),由两个不同的策略模型提供不同的梯度,然后在测试时将它们组合起来,这实际上是一个在测试阶段进行的组合过程。
在传统的机器人学中,比如轨迹优化领域,我们经常定义一些目标,比如我们可能会定义轨迹要尽可能平稳,也要避免碰撞等,这其实是两个目标,在优化过程中,要为其提供梯度使其同时满足这两个目标或约束。策略组合相当于将这两个目标替换为两个策略,它可以非常灵活地选择不同的策略,就像选择多个组件一样,然后将它们组合成一个模块,用来执行特定的任务。
如果是一个简单的前馈策略,比如两个MLP或两个Transformer,一个预测左移,一个预测右移,简单地平均,它们就往中间,可能会产生奇怪的效果。比如,如果我们需要避开中间的障碍物,有些目标是往左移动,有些是往右移动,简单地平均它们反而可能会撞到中间的障碍物。但因为Diffusion Policy并不是简单的平均,他是iterative和implicit的,因此在数学上这样compose它是合理的,因此它可以真的支持一些组合的问题。
针对Diffusion Policy的这个特性,应该就是之前采访迟宬博士提到Diffusion Policy可以很好的解决多模态分布(multimodal distribution)。感兴趣的朋友可以去之前的文章查看(Diffusion Policy—基于扩散模型的机器人动作生成策略)
Diffusion policy 是我们采用的一种策略类别,其基本假设是它需要是一种基于能量的模型,而Diffusion Policy算是一种基于能量的模型。在训练时,Diffusion Policy就在预测一个降噪(denoise)的步骤,在测试时,它会持续预测,从一个随机噪声轨迹开始,一直不断的降噪它,根据当前观察到的情况,把它降噪成训练阶段设定的期望轨迹或可行动作。在这个持续降噪的过程中,如果我们有两个不同的 diffusion policy,根据当下的观测和噪声轨迹,它们各自会生成一个预测,我们就可以把这两个预测组合起来。
最理想的情况是,它为我们提供了一个用户界面,其中包含许多不同的模块。例如,你可以选择使策略的轨迹更安全,或者使其行为更像仿真中的策略,或者让它执行更多类似于锤击的任务,你就选择即可。在选择完毕后,在测试时将这些模块组合在一起即可,但这些策略都可以是分开训练的。
上面是针对不同领域训练的策略组合,那针对不同模态的数据训练的策略组合是类似的逻辑。不同模态下产生的不同策略,只要它们的动作空间是相同的,就可以被组合起来。因此,它们可以是同一个领域内,两个不同模态的数据训练出的两个策略,也可以是两个不同的领域,同样的模态数据训练出来的两个策略。
还有一个没有提到的是人类视频,在这里,我们建立了一个数据管道,能够追踪人类视频中“手-工具-物体”的点云,利用这些点云可以训练出一些策略。这也是一个非常可扩展的方法,用于收集人类数据。这样训练出来的策略可以与其他两个领域的策略一起组合,从而提升效果。
在实验中,比如说结合了仿真和真实环境比单独使用仿真或者单独使用真实环境效果更好。这里面使用了仿真的时候是用到了3D点云,而在真实环境中则是用到了摄像头和触觉,所以这种情况下加入了不同的模态。
5. 为何特别关注异构数据?
在策略组合方面,其实之前已经有很多工作涉及类似的想法,比如 classifier-free diffusion model,这些都与我们的工作有一定联系。我们相当于是从一个新的视角出发,特别是从数据的异质性角度来考虑这个问题,尽量使其更加通用,这正是我们这个工作的创新之处。
具体来说,有一个既定目标,怎么用这个既定目标来偏置(bias)采样过程。举例来说,假设我们训练一个扩散策略(diffusion policy),在一个迷宫场景中,如果目标设定在迷宫的右上角,那么策略就会被引导向右上角移动,这可以看作是一种引导性采样过程。
我们的方法可以类比为,有一个现实机器人的策略,和一个仿真环境的策略,通过设定奖励策略,把奖励策略真实机器人策略往仿真环境的策略拉一下,使其更像仿真训出来的策略。反过来, 真实机器人策略也可以把仿真策略往真实机器人策略方向拉一点,使其更像真机策略。
我的 PhD 论文主要是关于异构性数据(Heterogeneous Data),其中包括了我之前的两个工作 Fleet Learning(Robot Fleet Learning via Policy Merging)和DEC SSL(Does Decentralized Learning with non-IID Unlabeled Data Benefit from Self Supervision?)其实包括PoCo,它核心思路也是如何更加高效地处理和利用这种异构性数据。这是一个更广泛、更基础的问题,除了视觉和语言领域外,几乎所有其他领域都面临数据不足的问题,但却希望能够应用机器学习。因此,他们都会遇到异构性数据的问题。
如何高效地从这些数据中提取信息?这个大问题在当前的研究中仍然未被充分探索。在整个学术界,很多研究者可能会专注于单个问题,比如一种机器人、一种任务、一个模拟环境或一个真实世界的任务,或者某种特定的算法,比如模仿学习或强化学习。但其实,把这些各类要素整合在一起,进行综合研究,我认为是非常有价值的。
现在大家都在关注大模型,如何训练一个大模型来支持多样化的任务,这其实是一个非常有意义的问题。比如到底是 30% 的模拟数据加 50% 的真实世界数据,还是 10% 的模拟数据加 70% 的真实世界数据,这些比例如何选择,目前其实并没有太多的理解,很多时候都是凭感觉进行调整。我认为,对异构性数据的研究会在未来全面支持大模型的训练和应用,这对于整个领域的发展是非常重要的。
GPT4o是一个很好的例子。过去,大家通常是以语言为中心,中间的模型必定是语言模型,输出也只能是语言。但现在显然他们提前把数据都tokenize好了,然后进行了一些异构预训练,这就是HPT里的一个想法。这样做的好处是,它能够融会贯通。最近也有一些工作表明,这种表示不同的模态最终会收敛,因为它们都是从不同的视角看待世界。
6. PoCo只针对工具使用类的任务吗?
它不仅仅针对工具使用类任务,可以针对各类机器人任务,只是我认为工具使用类任务在机器人操作中非常有趣,也应该是比较具有挑战性的,因为它对泛化能力的要求非常高。所以我选择将工具使用这类任务作为主要关注点之一,但这并不意味着PoCo仅能做这种任务。
工具更换与灵巧手使用工具有所不同,我觉得现在工业界里比较流行的还是工具更换。如果你要换一个工具,可能就需要重新训练那个策略,这就很麻烦了。最好的情况是有一个基础的策略,然后每次更换工具时只需要进行适配。甚至在理想情况下,连适配都不需要。
我当时选择操作任务时,觉得grasping和pushing这些任务已经有很多人做了,所以决定选择一个新的任务,挑一些不同的技能。我认为工具使用其实几乎涵盖了所有的东西。我们在这里写的是用锤子和扳手,实际上,烹饪也是在使用工具。虽然工具使用听起来包罗万象,但我的想法是,这样的技能是可以被学习的。就像人类一样,如果我要用石头砸东西,我其实知道怎么做,这些基本的物体之间的互动是可以被学出来的。所以我选择了这个任务,尽管我知道它可能定义模糊,还涉及到很多力学方面的东西,但我觉得这个任务非常有意思。这就是我的基本思路。我认为,不论是数据的异构性还是工具使用,我们增加了更多的任务,相当于增加了更多的工具和更多的embodiment,虽然更有挑战,但可能具身大模型就是这样才能训练出来。
增加了这些数据异构性、工具和任务,把这些放在一起为什么会有帮助?怎么可能会work?怎么可以加在一起训练?但如果你看大语言模型,比如说加入代码数据,这些数据对模型的性能提升是非常显著的。直觉上,一个正常人不会觉得代码数据能帮助学习英语或者中文。但实际上,我们给模型增加了更难的任务,这些任务配合一些好的目标,比如next token prediction,让模型面临挑战,它必须去学会一些抽象的、有推理能力的技能和知识,来完成各种不同的任务。所以我认为这种思维方式是非常基础的。
7. 为什么加入触觉信息?
因为我们在使用工具时,特别重要的是能够感知到当一个物体碰撞另一个物体时的具体力量,这时就需要触觉传感器来获取这些信息。如果只有视觉,可能无法获得这些信息。另外一个重要的方面是确定工具在手中的位置和姿态。这在工具使用中非常关键,因此很多工具使用的研究都会使用触觉信息。PoCo这个工作里我们用的触觉传感器是GelSight Svelvt,Jialiang的一个触觉传感器,(关于Gelsight相关触觉传感器,我们在GelSight十五年——简述视触觉传感器发展史有详细介绍)。
8. 其他关于PoCo的问题
Without Retraining怎么理解?
不需要像ChatGPT那样把数据放在一起训练,我们可以分开训练,却能在多个领域中达到类似的效果。这其实是一个更具挑战性的设置,因为这些数据都是分开来使用的,你需要确保如何有效地整合它们在一起。
PoCo哪里可以改进
PoCo有一个问题就是在实践中可能速度不够快,因为需要在测试时运行多个策略。不过这个问题应该可以比较容易解决,只需要更多的计算资源就行了。分布式计算可以很好地解决这个主要问题。另外,在算法上我们其实还有很多可以改进的地方。
9. 关于HPT
对PoCo我们有一个follow-up的工作,叫做Heterogeneous Pre-trained Transformer(HPT,异构预训练变换器)。HPT的想法比PoCo简单很多,也更通用,就是把所有数据放到一起,把OpenX、仿真数据、以及人类视频数据等多达50多种不同的数据集汇总在一起训练,这可能是最异构的数据集了。训练的方法就是,我们对每个Embodiment进行了单独的tokenize。你可以想象,针对不同模态的数据,我们把不同模态的数据进行tokenize,但在robotics里有embodiment这个概念,如果有不同的观测和不同的动作,都需要单独对待。所以我们tokenize embodiment,然后将其映射到一个中间的Transformer,然后再将其映射回到每个独立的任务。因此,在这种情况下,我们开发了一种新的架构,并观察了他的可扩展性,我们研究了通过增加数据或模型大小是否可以提升性能。
HPT效果
效果就是我们可以将其迁移到一个新的领域,而不必重新训练中间的那个 transformer。假设每个模态都有了自己的tokenizer,我们只需要训练一个非常小的网络,将其调整到新的机器人领域即可,效果还挺好的,这个工作最近会发布。
HPT我们既是加了更多的数据,也是在增加更多的挑战,通过这些挑战让模型不得不去学习一些可以通用的东西。这可能类似于不同层次的数据金字塔(pyramids of data),有些数据比较容易获取,有些则比较昂贵,但每个数据的质量都不一样,因此需要一个好的方法将它们结合在一起。
10. 关于Fleet Learning
集群学习(Fleet Learning)是我们提出了一个新的想法,包括Russ Tedrake也非常感兴趣,TRI也一直在说这个概念。这个想法一直在讨论,尤其是随着越来越多的机器人技术的发展和投资,会有成百上千的机器人出现。每个机器人遇到一些数据或场景时,如果其他机器人不知道如何处理,它们是不是也得先看到相同的信息才能学习?因此,我们想要实现的目标是,比如有1000个机器人,一个机器人学到了某些信息或遇到了某些场景,其他所有机器人都应该能够立即学习到这些信息。因此,我们在这里研究的这个想法叫做“Fleet Learning”。
它的一个例子是自动驾驶。实际上,每辆车都可以生成大量的数据,每天都会产生大量数据,而目前最基本的做法是将这些数据经过复杂的数据处理流程。Fleet Leanring实际上是在研究集群学习的问题,每个机器人在执行不同任务时,就像我们之前提到的不同的模态一样,因为它们是被设计成这样,它们执行不同的任务,所以它们是非常异构的。那么我们如何高效地处理这种异构性?或者如何在这种异构性中高效地学习数据和表示?这就是集群学习的理念。
所以,我可以总结一下这四个工作:HPT、Fleet Learning、DEC SSL和PoCo。HPT相当于是将这些异构的数据放在一起,然后对这些数据进行tokenize,训练一个大模型。Fleet Learning在训练时将它们的权重进行平均,将神经网络的权重组合起来,这样更加高效,可能权重只有几MB,而不是每天上传几TB的数据。这些大量的数据比如说在一个月内完成训练,然后在完成后对几MB的数据进行平均。然后,对于DEC SSL,假设这些数据甚至都没有标签,是未标记的,那我能不能先做自监督学习,先学习到一种表示,然后再平均,再组合。最后是PoCo,如果这些策略都训练完毕,我们能不能在它们的动作空间进行一些组合。所以实际上,这些工作是从不同的角度去解决这个问题。
一些想法
因为最近几天睡前陪读《恐龙王国》,我第一次了解曾经和人类共同生存在同一个星球上的物种的点滴。从最早出现在2亿多年前的三叠纪晚期到6600万年前因未知灾难的灭绝,恐龙在地球上生活了1.6亿年。从身长长达30米的梁龙,小到几十厘米的美颌龙,进化了1亿多年的恐龙生存能力比人类强太多,但如今它们也只能以地下的化石来证明他们曾经存在过。反观人类文明,更进步一步到中华五千年文明,与以千万年为单位计量的恐龙时代相比,真的是微不足道,人类文明下2024年的我们更是沧海一粟。每个当下的无灾无难、平安健康都是值得被珍惜和庆幸的瞬间。恐龙帝国的消亡也许意味着人类文明的终点逃不过一些宿命,我也突然有些理解Elon Musk常说的火星殖民和人类文明的延续之间的关系。如果某一个轮回我站在了人类文明的终点,我会非常感谢今天的人们在脑机接口、星际飞船、通用机器人、新能源、人工智能这些领域做出的不懈努力。人类文明过于绚烂和精彩,穿越世代后,它不可以仅仅以化石的形式被埋藏在地下,它必须以某种形式延续下去!
Robot Data第一季最后一篇论文访谈结束了,真心感谢接受邀请的学者和对这个系列持续关注的朋友们。我们也用下图总结概括全部9期访谈所描绘的机器人数据金字塔。通用机器人是人类关于生产力变革的终极目标,也是各种前沿技术在应用上的终极挑战,这个“终极”的到来不一定如人们预期的那么快,但它一定会到来!在这个也许漫长的未来,希望我的这些笔记可以在某一瞬间让仰望着同一片星空、但在不同领域脚踏实地做事的创业者、学者、从业者有一点点启发。
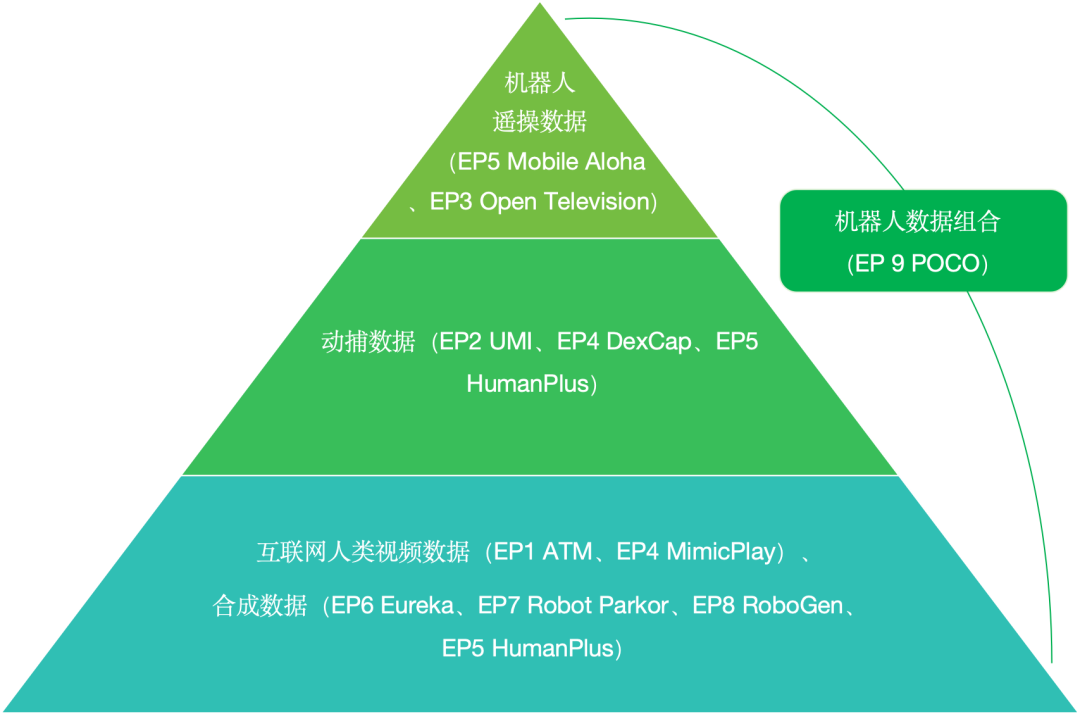
Robot Data Season 1 EP01-EP09
EP1对话高阳、汶川:如何利用互联网人类视频训练机器人大模型(ATM—RSS 2024满分论文)
EP3对话程旭欣:Open-TeleVision教你如何沉浸式遥操机器人
EP4对话王辰:MimicPlay & DexCap——如何利用人类视频和人体动捕数据进行机器人训练
EP5对话符梓鹏:HumanPlus和Mobile ALOHA的数据故事——从合成数据到真实数据再到两者的结合
EP6对话马也骋:Eureka和DrEureka如何利用LLM解决仿真+RL最重要的难题
EP7对话赵行、庄子文:机器人跑酷和自动驾驶——机器人数据从哪里来
EP8对话淦创、周衔:RoboGen如何通过生成模型和可微分模拟大规模合成机器人示教数据(附可微分物理引擎论文综述)
References:
PoCo
https://liruiw.github.io/policycomp/
Gensim
Fleet Learning
https://arxiv.org/abs/2310.01362
DEC SSL
https://arxiv.org/abs/2210.10947