看到标题,很多人应该就激动不已的点进来(如果你点进来的瞬间并没有激动不已,说明你对3D Vision近两年的进展不够了解)。我们这期采访CVPR 2025 Best Paper VGGT和CVPR 2026 Best Paper Finalist VGGT-Ω的一作王建元博士。
建元目前在Oxford Visual Geometry Group和Meta AI做联合培养博士。他的研究方向聚焦在,如何在不使用额外传感器的情况下,仅通过图像或者视频流本身,让模型获得对三维世界的感知能力。换句话说,就是希望模型只依靠视觉信息,就能够理解和感知三维世界。
建元的这期访谈,让我回忆起两年前和一个创始人聊到的观点:当下具身模型的发展都依托于一个开源的base model(曾经是个VLM,现在是个VGM),那么具身模型的进展到底是由base model决定的,还是由具身模型公司决定的?GPT-9.8这个时刻,到底对当下的具身智能创业公司意味着什么?
Again,我非常推荐这期访谈,每一段文字,都值得细细看,认知都藏在细节里。
查看原文目录
以下为本文目录
👇
第一部分关于三维重建
1.什么是三维重建
2. 三维重建为什么重要?
3. 三维重建能力会融合进多模态大模型吗?
4. 为什么当下无论是机器人领域还是大模型都没有那么拥抱3D信息?
5. 这样一个基础模型看上去还是得大模型公司搞出来?
第二部分关于VGGT系列工作
6. VGGT 系列工作介绍
7. 关于VGGT系列工作的训练数据
8. 什么算高质量的数据
9. 关于合成数据
10. 可穿戴设备上的三维数据可用吗?
11. 关于VGGT数据的其他问题
12. 关于VGGT-Omega的数据问题
13. 数据问题是3D领域发展最大的瓶颈吗?
第三部分关于机器人
14. 做robotics的人可以怎么借鉴VGGT工作成果?
15. 为什么当下的机器人行业如此依赖2D而非3D?
16. 未来想做的方向
第一部分 关于三维重建
1.什么是三维重建
这个方向其实已经被研究了很久。大概从上世纪80年代、90年代开始,随着计算机计算能力逐渐发展起来,研究者们开始思考一个很自然的问题:如何从二维信息恢复三维信息。
因为对于人类来说,我们会觉得自己生活在一个三维世界里,但如果不考虑触觉,仅从获取信息的角度来看,我们主要依赖的是视觉,而视觉本质上接收到的是二维图像或者二维视频流。
所以早期研究者关注的问题就是,如何从这些二维观测中恢复出三维世界的结构。
早期一个比较经典的思路是Stereo。很多人可能接触过Stereo Camera(双目相机)。简单来说,当两个相机同时观测同一个场景,并且两个相机之间存在一个小的基线距离,也就是轻微的位置偏移时,我们就可以通过三角化的方法,根据两个相机中对应的像素位置恢复它们在三维空间中的深度信息。
从某种意义上说,这是三维重建的一个特殊情况,因为Stereo相机之间的相对位置是已知且固定的。但研究者更希望处理更一般的场景,比如相机之间的位置关系本身也是未知的。这时问题就进一步扩展成:既要恢复场景中各个点在三维世界中的深度,也要恢复相机在三维世界中的位置和姿态。
大概在1995年到2005年之间,人们逐渐发现,这类问题可以通过一种叫Structure from Motion(SfM)的流程来解决。机器人领域的同学可能更熟悉SLAM。某种程度上,SLAM可以看作Structure from Motion的一个特殊场景或者子集。
Structure from Motion的输入是一组大致对应同一场景的图像,通过这些图像恢复相机参数和场景深度。而SLAM则进一步假设这些图像具有时间顺序,是一个连续的视频流。这样虽然对问题做了一些简化,但通常会更加稳定和可靠。
因此在1995年到2005年这个阶段,三维重建领域主要关注的是如何定义和解决这个问题。
随后从2005年到2014年前后,整个领域更多是在做工程层面的提升。研究者关注的是如何让重建速度更快、规模更大、鲁棒性更强。例如能够处理十万张图像,能够处理八小时、十小时甚至更长时间的视频数据。
再往后,从2014年到2022年,深度神经网络开始进入这个领域。那个时期大家普遍认为,重建问题本身已经有非常成熟的数学建模,例如三角化、基础矩阵分解等都有清晰的数学表达。因此研究重点不是让网络直接完成重建,而是利用深度学习提升传统流程中的某些环节。
比如以ORB-SLAM为例,它的第一步需要找到多张图像之间的对应关系。那个时期大家研究的是,如何通过神经网络获得更好的特征表示,在特征图上找到更准确的对应关系,从而获得更好的重建结果。这基本上是2014年至2022年期间的主流研究方向。
而从2022年至今,整个领域开始主动或者被动地更加全面地拥抱深度学习。
比较有代表性的工作包括DUSt3R,以及后来的VGGT、VGGT-Ω等。这些工作的核心思想是,不再只是利用神经网络帮助寻找更好的对应关系,而是直接把整个重建问题转化成一个端到端的深度学习问题。
(最左侧VGGT重建出的效果,肉眼可见的好于后面两个)
换句话说,它变成了一个完全黑盒的过程。有人喜欢这种方式,有人不喜欢,但我个人其实比较喜欢黑盒这个概念。现在我们只需要输入图片,把它送进一个训练好的Transformer模型,模型就可以直接输出我们在三维空间中希望获得的各种信息。
我觉得这也是为什么最近两三年三维重建突然再次受到广泛关注。
第一个原因在于,如果这种方法能够采用和二维视觉、语言模型类似的训练范式,那么它就有机会受益于Scaling Law。
当计算资源增加、数据规模增加、训练投入增加的时候,模型能够持续稳定地获得性能提升。
对于公司来说,这是一个非常有吸引力的特性。因为企业更愿意投入那些能够稳定获得回报的技术路线。
第二个原因是,相比传统重建方法,这种完全深度化的方法开始能够处理动态场景。
这里有一个重要的观点:任何动态物体都可以被看作无数个小刚体运动的组合。在传统重建框架下,这类问题非常难处理,因为同时存在多个刚体运动,很难恢复其真实结构。但现在这些问题开始可以被解决。
例如在一些最新工作的Demo中,我们已经能够恢复运动中的人和周围环境之间的空间关系。这意味着许多过去无法解决的问题开始变得可解。
(VGGT-Ω的一个demo演示,完美呈现动态重建)
第三点也是我个人觉得最有吸引力的一点。在二维视觉领域,我们已经习惯于把一张图片编码成一个全局表示,然后利用这个表示完成分类或者各种下游任务。但在几何领域,至少在2022年之前,其实并不存在类似的东西。
而现在,我们已经可以把一个输入的视频序列转换成一组几何感知的表示或者Token。这些Token能够编码整个序列中的主要几何结构和运动信息。
有了这样的表示之后,就能够支持大量新的下游应用,也能够衍生出很多有意思的研究方向。
我认为,这就是从2022年到2026年这一轮全面深度化的三维重建浪潮所带来的主要变化。
2. 三维重建为什么重要?
我觉得可以说,三维重建是整个三维、四维理解,或者说空间理解(Spatial Understanding)的基础。用比较老一辈研究者的话来说,它相当于是整个几何领域“皇冠上的明珠”。如果能够把三维重建这个问题解决好,很多后续想要的信息其实都能够直接获得。
这也是为什么这么多年来,大家一直非常重视三维重建。如果去看CVPR或者相关领域这些年的发展脉络,会发现无论技术路线怎么变化,学术界始终都非常关注三维重建,因为它在整个领域里有一种比较特殊的基础性地位。
而且在我看来,到了今天,三维重建的重要性不仅没有下降,反而进一步提升了。
还是拿二维深度学习的发展来做类比。回顾二维视觉的发展历程,最早大家往往会先在ImageNet这样的图像分类任务上预训练一个模型,比如ResNet。之后再把这个预训练模型迁移到目标检测、图像分割等其他任务上。也就是说,图像分类实际上承担了一个预训练任务的角色,为很多下游任务提供通用特征。
对于三维领域来说,我认为重建正在逐渐扮演类似的角色。一个训练好的重建模型,它学到的特征可以被迁移到很多其他三维任务上。例如我们自己做过一些工作,会利用重建模型的特征去做Novel View Synthesis;类似的特征也可以用于Surface Estimation等任务,而且通常都会带来明显的帮助。
从这个角度来看,重建可以成为空间理解领域里的一个Proxy Task。更重要的是,它还是一个具备良好扩展性的Proxy Task,因为相关数据相对容易获取,不需要特别昂贵的标注成本。
这也是大家如此重视它的重要原因之一。
如果用二维视觉中的概念来类比的话,可以把三维重建理解成某种程度上结合了图像分类和图像分割特点的基础任务。它既能够学习场景的整体语义信息,也能够学习空间结构信息,因此能够为大量下游任务提供通用能力。
3. 三维重建能力会融合进多模态大模型吗?
从模型结构上看,现在很多VLM通常会有一个语言分支,也会有一个视觉分支。视觉这一侧,很多模型基本上会用CLIP或者DINO这类方法,把图像转换成一组Token。
但这些Token通常更偏向语义信息。我的感觉是,如果我们的方法足够幸运,未来也有可能扮演类似的角色:比如在现有模型里再开一个分支,或者作为一组额外的Token加入进去。
这样的话,我们的模型就可以为VLM、VLA,或者其他类型的模型,提供带有几何感知和空间感知能力的Token。
这可能也是我比较希望看到的方向,也就是刚刚您提到的那种“基座”的感觉。
4. 为什么当下无论是机器人领域还是大模型都没有那么拥抱3D信息?
我觉得这个问题可以分成两部分。
刚刚您提到,为什么现在三维能力还没有真正进入机器人领域。我可能有一个稍微不同的看法,我觉得核心原因是目前的需求还没有那么强。
如果看现在机器人领域最热门的方向,很多人关注的还是Manipulation Task,比如机械臂在桌面上做抓取、分拣这类任务。我的直观感受是,这类任务在概念层面相对简单。当然不是说它容易做,而是说它对三维理解的依赖没有那么强。很多时候,即便只用二维数据,针对特定任务进行优化,也能取得很好的效果。
所以我觉得,现阶段机器人领域的发展还没有到必须依赖三维信息的时候。空间信息当然有帮助,但还不是解决这类任务的必要条件。
我反而觉得,真正需要三维能力,可能还要等两三年。当大家的关注点从简单的Manipulation Task逐渐转向Open-world、General-purpose Robotics的时候,三维和空间理解的重要性才会真正体现出来,并成为不可或缺的能力。
现在更多还是一些有意义的早期尝试。大家都在探索如何把不同类型的信息融合进来,但它真正能够大放异彩,可能还需要再等两年左右。因为还是要先把当前这些Manipulation Task解决得差不多,行业的关注点才会自然转向下一阶段的问题。
我之前和不少同学讨论过这个问题,最近在一些CVPR的分享里也会提到类似的观点。
假设未来有一个“GPT-9.8”这样的模型,我们给它很强的控制能力,再给它任意一种机器人平台,无论是人形机器人、机械臂,还是其他设备。我的预期是,在未来某个时间点,也许并不遥远,这样的模型在拿到一个新的机器人之后,只需要十几秒钟就能根据说明书理解这个设备的结构和控制方式,然后在接下来的一两分钟里,通过和环境的实际交互,快速学会如何操纵它。
比如让机器人往前走两步、摔倒一次、跑起来、滑动或者跳跃。通过这种测试阶段的交互,它可能只需要几分钟时间,就能够零样本学会如何控制一个从未见过的机器人。
而我之所以认为Robot Model需要空间感知能力,也是基于这样的设想。
我希望未来的机器人模型不再需要大量专门采集的机器人数据,不再依赖各种遥操作设备或者具身数据收集流程。相反,在预训练阶段,它就是一个同时理解图像、文本和三维空间的多模态模型。
这样的话,当我们给它任意一个机器人接口时,它不需要额外训练,甚至不需要专门适配,就能够像一个经验丰富的操作员一样,快速理解并操纵这个机器人。
我觉得这样的时代离我们不会太远。
5. 这样一个基础模型看上去还是得大模型公司搞出来?
关于大模型公司和机器人创业公司之间的竞争,我个人认为,最终把通用机器人模型做出来的,大概率还是大模型公司。
当然,中间可能会出现很多机器人创业公司,它们可能在数据、硬件或者具体场景上积累出自己的优势,甚至有可能被大模型公司收购,用来补充数据和硬件能力。但如果说最终谁能够做出我们理想中的那种机器人模型,我还是更看好大模型公司。
因为按照我的设想,未来真正意义上的机器人模型,本质上会是一个超大规模参数的基础模型。它不仅需要理解语言、视觉和空间信息,还需要具备比今天所有模型更强的推理能力。
而我觉得,做这样一件事情是需要特定基因的。目前能够持续训练和迭代这种级别模型的公司,其实还是少数几家头部大模型公司。
反过来看现在很多机器人创业公司,我觉得它们在硬件、系统集成或者具体应用场景上可能很有优势,但暂时还比较难看到能够独立做出这种级别基础模型的能力。
所以我的判断是,未来机器人领域最核心的突破,大概率还是会来自大模型公司,而不是机器人创业公司本身。
第二部分关于VGGT系列工作
6. VGGT 系列工作介绍
VGGT基本上就是刚刚提到的那种完全数据驱动、拥抱黑盒的范式。它的输入是几张图片,我们首先把这些图片转换成Token,然后通过Global Attention和Frame-wise Attention进行信息聚合,从而建模不同视角之间的空间关系。
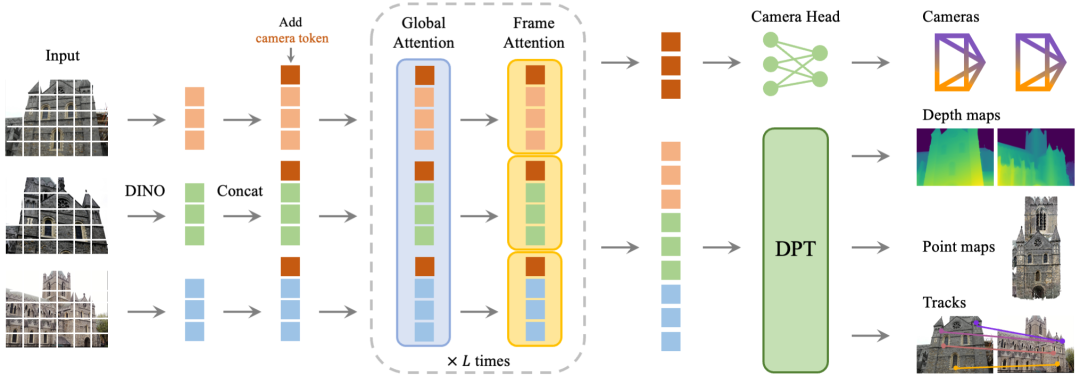
在VGGT里,我们最终做的事情是在聚合后的Token上开出多个输出分支。比如输出Camera参数,包括Rotation、Translation等位姿信息;输出Depth;输出Tracks;以及其他各种几何相关的表征。
当时我们的核心想法是,希望学到一种具有几何感知能力的表征。我们认为最简单的方法,就是尽量保持整体架构简单,同时在输出端提供足够丰富的监督信号。
原因在于,如果只训练模型预测Camera,它可能会“偷懒”,学到一些能够完成任务但不具备真正几何意义的特征;如果只预测Depth,也会有类似的问题。但如果让模型同时预测Camera、Depth、Track以及其他几何信息,那么这些任务共同约束出来的表征就更有可能是真正几何感知的表征,而不是某种投机取巧的解。
所以VGGT本质上是在探索如何学习这样的Geometric-aware Representation。
另一个很重要的优势是,相比传统重建方法,VGGT的速度非常快,可以快100倍甚至200倍。因为它不再依赖那些非常耗时的测试阶段优化过程(Test-time Optimization)。这也是VGGT希望解决的问题:不仅做重建,更重要的是学习可泛化的几何表征。
到了VGGT-Ω,我们当时在想,接下来还有很多方向可以探索,但哪些问题是值得我们优先去做的。
最后我们选择了两个重点。
第一个是研究Scaling。
也就是当我们持续增加训练数据、模型规模和计算资源时,重建模型的能力是否会稳定提升。最终我们发现答案是肯定的,这对我们来说是一个非常积极的信号。
第二个重点是研究如何真正实现Scaling。
因为Scaling并不是简单地增加数据和算力就可以完成。比如模型规模变大之后,需要解决训练效率、显存占用等问题,否则训练过程根本无法进行。围绕这些问题,我们提出了一系列专门的模型设计和训练策略。
所以VGGT Omega主要回答了两个问题:第一,重建模型具备Scaling能力;第二,真正实现Scaling并不容易,需要针对性的模型设计。
除此之外,还有一个我个人特别喜欢的发现。我们发现,这类模型学到的Token和Feature,确实能够帮助机器人等下游任务。
在论文里,我们做了一个VLA实验。虽然实验本身比较简单,因为我并不是机器人方向的专家,所以直接采用了开源的OpenVLA实现。
具体来说,我们在OpenVLA的基础上,额外加入了VGGT Omega从图像中提取的空间感知Token。在这个过程中,VGGT Omega本身是冻结的,参数完全不更新。换句话说,它充当了一个几何编码器(Geometric Encoder)的角色。
最终我们发现,仅仅加入这部分空间感知特征,就能够带来明显的性能提升,在Libero基准上的表现也有所改善。
我们原本还希望进一步在真实机器人平台上验证这些结果,但后来发现这已经超出了我自己的能力范围,后续可能还是需要机器人方向的同学继续探索。
7. 关于VGGT系列工作的训练数据
如果总结一下的话,我觉得最核心的一点是:在保证数据质量的前提下,数据量越大,模型获得的提升就越明显。
但这里面有一个非常重要的前提,就是数据本身不能出错。我们其实在这件事情上吃过很多亏。
比如在VGGT Omega里,我们专门展示过一些Bad Case。有些数据集在采集之后会做后处理,比如Depth fusion这类方法。而这些后处理有时会引入错误,例如把某个物体的深度错误地融合到其他区域。论文里有一个椅子的例子,本来椅面应该高于地面,但经过Fusion之后,椅面的深度被错误地赋值成了地面的深度。
这种脏数据会给模型带来非常差的先验。我们在内部分析模型错误时发现,很多能够稳定复现的问题,最终都能追溯到训练数据里的错误标注。模型会学到这些错误模式,并把它们迁移到测试数据甚至分布外数据上。
所以Data Quality真的非常重要。以前大家都会说数据质量重要,但直到自己完整经历了一遍训练、分析和迭代的过程之后,我才意识到它的重要程度其实远超我的预期。
第二个观察是,我觉得目前三维数据还是太少了。
我们会发现,模型其实有能力记住某些特定的数据分布。有时候模型在某些特殊场景下表现不够理想,虽然不会完全失败,但效果明显不如其他场景。后来深入分析这些案例时,我们发现,往往是因为训练集中存在一小部分外观非常相似的数据,而这部分数据本身的质量又不够高。
原来我一直有一个比较理想化的假设:当高质量数据足够多的时候,模型学到的规律会自然泛化,并覆盖那些低质量数据带来的影响。但至少在目前的重建模型上,这种现象还没有明显出现。
我的感觉是,根本原因还是数据量不够大。现在的模型仍然有能力把不同来源的数据分成一个个独立的分布区域,然后分别去记忆这些区域里的模式,而不是把它们真正平滑地统一起来。
所以如果要总结的话,我觉得最重要的两点就是:第一,数据质量极其重要;第二,目前三维数据的规模依然不够大。
8. 什么算高质量的数据
关于第一个问题,什么样的数据才算高质量,我觉得三维重建领域有一个挺有意思的特点,就是它的数据质量很多时候可以直接通过人工检查判断出来。
先说什么是坏的数据。通常我们会把各个视角的Depth和Camera参数投影回三维空间。如果结果里出现墙面不平、同一个物体出现多层重影,或者不同视角下本该重合的位置对不上,这些都是非常典型的问题。
那什么是好的数据呢?我觉得一个很直观的标准是,看起来是否符合我们对真实三维世界的认知。
比如对于静态场景,如果从100张图片恢复出来的桌角,在三维空间里能够完全对齐,没有明显偏差,那就说明从二维到三维、再从三维投影回二维的过程中几乎没有误差。这种结果通常会非常漂亮。
对于动态场景也是类似的。比如一个人在匀速向前走,如果恢复出来的三维轨迹同样是平滑且连续的,并且和周围环境保持一致的空间关系,那就是好的结果。相反,如果这个人的轨迹突然发生不合理的跳变,比如毫无原因地往前跳了一大截,那显然就不符合真实世界。
所以如果用一句话概括的话,我觉得高质量的重建数据,就是把重建结果放回三维空间之后,尽可能符合人类对于真实世界的直觉。
9. 关于合成数据
(VGGT的训练数据里使用合成数据的比例比较高,合成数据对重建模型是好数据还是坏数据?)
这些合成数据基本上都来自公开数据集,主要可以分成几类。
第一类是通过Blender、Unreal Engine(UE)这类图形引擎渲染出来的数据。比如我们先搭建一个场景,里面包含各种三维资产,然后在场景中采样不同的相机轨迹,再渲染得到对应的RGB图像、Depth以及Camera参数。
第二类是从游戏中采集的数据。比较典型的例子就是很多工作会从GTA这类游戏中获取训练数据。因为游戏本身已经构建了一个完整的三维世界,所以能够直接得到大量带有精确几何信息的数据。
关于合成数据会不会影响模型质量,我觉得这里和大语言模型领域有一个比较微妙的区别。
在大语言模型里,大家说的合成数据,很多时候指的是模型自己生成的数据,或者从模型中蒸馏出来的数据。本质上,它仍然来自模型本身的分布,所以会存在分布偏移或者错误累积的问题。
但在三维重建领域,我们所说的合成数据并不是这个概念。
如果我们认为场景里的三维资产本身是准确的,那么这个场景其实就是一个完整且真实定义的小型三维世界。而合成数据,本质上只是对这个三维世界进行观测和采样。
所以在目前的发展阶段,对于三维重建来说,合成数据往往是高质量数据,而不是低质量数据。它不仅不会导致模型退化,反而经常能够帮助模型学习更准确的几何规律,并带动其他数据一起提升效果。
我一直很想验证的一件事情是:如果能够构建一个足够多样化、规模足够大的合成数据集,那么完全有可能训练出一个非常准确、非常漂亮的重建模型,而且我觉得它甚至有机会超过目前很多现有模型。
所以至少在当前阶段,对于三维重建领域来说,一个比较反直觉的结论是:合成数据不是问题,反而是非常重要、非常有价值的数据来源。
10. 可穿戴设备上的三维数据可用吗?
(你刚提到现实中的3D数据太少了,可穿戴设备或机器人传感器的普及,会增加这些数据吗?)
这其实就是我之前提到的那类典型脏数据,它们的数据质量通常比较差。
比如iPhone采集的Depth数据。虽然iPhone有激光雷达,可以直接获取深度信息,但在我们看来,它的精度还不足以满足高质量重建的需求,反而属于我们希望过滤掉的数据。
除了iPhone之外,很多廉价的RGB-D相机也是类似的情况。在工业场景里常见的一些RGB-D设备,在我们看来噪声都比较大,精度也不够高。
即使是一些室内激光雷达,数据质量往往也达不到理想水平。真正比较准确的是高端室外激光雷达,但这类设备价格昂贵,而且数据比较稀疏。
所以对于高精度三维重建来说,很多大家以为很准确的深度数据,其实并没有想象中那么可靠。
11. 关于VGGT数据的其他问题
空洞其实不是问题。如果传感器能够明确告诉我哪些区域是不确定的,然后把这些地方直接留空,我觉得是可以接受的。
真正麻烦的是那些错误的深度值。也就是说,它看起来测到了某个点,但测出来的Depth其实是错的。这类数据会直接误导模型,问题比空洞大得多。
至于训练数据,输入其实很简单,就是一段图片序列(Image Stream)。输出主要包括两部分:一是每张图片对应的Camera参数,二是每张图片对应的Depth。
Camera参数可以理解为相机在三维空间中的位置和朝向。比如你拿着相机在室内走一圈,在这个过程中,你的位置一直在变化,朝向也一直在变化。你往左转、往右转,或者向前移动,这些都会反映在Camera参数里。
它的作用就是描述当前相机是从什么位置、什么角度在观察这个三维世界。有了这些参数,我们才能知道每张图片对应的是哪个观察视角,并进一步恢复整个场景的三维结构。
12. 关于VGGT-Omega的数据问题
在Omega里我们确实大幅增加了数据规模。最终用于训练的数据大约是400万个Sequences。这里面的数据既可以来自视频,也可以是没有时间顺序的图片集合,这一点和VGGT本身是一致的。
其实Omega里最重要的经验之一,就是我刚刚提到的数据清洗。
在论文发布之前,我们做了很多内部测试。整体效果其实很好,但总会在一些特别的场景下突然崩掉,出现一些非常奇怪的结果。当时我一边很沮丧,一边也特别困惑,不知道问题到底出在哪里。
后来我和合作者花了很长时间排查。我们先检查训练代码,检查Checkpoint,检查Inference代码,几乎把所有可能出问题的环节都查了一遍,但始终找不到原因。
最后我们开始重新检查训练数据,才发现问题真的出在数据上。有时候占比可能只有0.01%,甚至更少的一小部分脏数据,就足以让模型学到错误的模式,并在某些特殊场景下暴露出来。
到现在其实还有一些问题没有完全解决。比如在某些场景下,如果一个人穿着全黑的衣服,模型对这个人的预测置信度会明显下降,结果也更容易出现偏差。
后来我们发现,这和训练数据有关。出于隐私保护的原因,一些数据集会把人、水印、商标等区域直接Mask成纯黑色。模型在训练过程中学到了这种模式,因此会受到影响。
这个问题目前还没有完全解决,我们在论文里也专门提到了这一点。
13. 数据问题是3D领域发展最大的瓶颈吗?
我的感受是,各个方向的发展其实是相辅相成的。而对于三维重建来说,目前很大程度上还是被数据问题限制住了。
如果看大语言模型的发展历程,虽然现在很多Frontier Labs都会构建自己的数据体系,但在某个阶段,大家是能够比较有信心地基于一些公开数据集进行训练和验证的。因为这些数据已经经过了社区长期检验,被很多工作反复使用和验证过。
但在三维领域,我们还缺少这样的数据基础设施。到目前为止,还没有形成被整个社区广泛认可和反复验证的大规模高质量数据集。
其实我觉得机器人领域也面临类似的问题。前段时间我在湾区和不少机器人创业公司聊过,大家也经常提到这一点。
很多时候,不同方法使用的训练数据都不一样,测试数据也不一样。同时,大家也缺少一个能够在真实机器人平台上进行公平比较的统一评测标准。
所以从这个角度来看,我觉得机器人领域也有类似的数据问题,而且某种程度上可能比三维重建还要更严重一些。
第三部分关于机器人
14. 做robotics的人可以怎么借鉴VGGT工作成果?
如果你的任务本身很依赖空间结构、空间关系或者运动信息,那么可以直接把我们输出的Token作为Condition,或者作为额外输入加入到你的模型里。
我觉得这可能是我最想分享的一点。
说得再直接一点,其实现在机器人领域和视觉领域一直有一个争论:三维理解到底是不是必要的。
一派观点认为,机器人最终不需要显式的三维表示,这些东西未来可能会被更端到端的方法取代。另一派则认为,机器人能力的发展一定离不开显示的三维表征。
这里说的三维,本质上其实是空间感知能力。而空间感知能力又有不同的实现路径。一种是依赖多传感器,比如RGB-D相机、激光雷达等;另一种是纯视觉路线,也就是仅从图像中学习对三维世界的理解。
如果参考特斯拉的发展路径,很多人会天然倾向于第二种方案。因为它更容易扩展,成本更低,也更符合大规模部署的需求。
所以回到最初的问题,三维能力对其他任务到底有没有帮助,其实目前还没有定论,整个领域仍然处在一个持续讨论的阶段。
但我个人是相信它有价值的。至少对于那些需要理解空间结构、空间关系和物体运动的任务来说,我的观点很明确:三维能力是必须的。
因为无论是人类还是机器人,最终都生活在一个三维世界里,我们也希望机器人能够在这个三维世界中帮我们完成任务。但我不认为显式的三维表示是必须的,比如点云、深度图这些形式未必重要。我更相信隐式的三维理解,也就是让模型通过Token和Feature具备空间感知能力,而不一定直接输出传统意义上的三维表示。
笔者的理解:获取三维信息不一定非要依赖激光雷达或者RGB-D这类三维传感器。它可以来自多视角单目,也可以来自移动单目,只要能够获取到恢复三维结构所需要的多视角信息,再通过类似VGGT这样的重建模型进行恢复就可以了。而且这里的三维信息也不一定要以显式形式存在,不一定要渲染成点云、网格或者其他三维表示。它更像是一个Encoder,把空间信息编码成Token或Feature,让模型具备对空间关系和几何结构的理解能力。
15. 为什么当下的机器人行业如此依赖2D而非3D?
(目前机器人领域的训练数据大量依赖不带深度信息的RGB,或2D视频流,RGB in Action out看上去是主流的尝试方向)
首先我想先下一个定义。您觉得依赖2D输入和我们前面讨论的,比如把VGGT或者其他重建模型作为额外的Geometric Encoder引入系统,这两件事之间存在冲突吗?
我能理解他们为什么选择这条路线。
第一,还是回到刚刚说的那个观点。现在机器人领域关注的大部分任务,本质上还是相对简单的Manipulation Task,未必真的需要很强的三维理解。比如像叠衣服这类任务,我觉得即使缺少完整的三维信息,只要经过足够训练,也完全有可能做得很好。所以他们不是刻意不用三维,而是在当前阶段,这些任务对三维能力的需求还没有那么强。
第二个原因是成本。RGB数据是最便宜、最容易获取的数据形式,每增加一种模态,数据采集和处理成本都会明显上升。所以从工程角度来看,RGB-only路线天然更有吸引力。
第三个原因是我个人的观察。现在整个机器人领域很大程度上是在借鉴视觉领域的发展成果。无论是Vision-Language-Action模型还是World Model,很多核心能力最早都是在视觉领域先验证成功,然后再迁移到机器人领域。因此机器人社区天然会更倾向于直接使用已经成熟的二维视觉模型,而不是额外引入新的三维模块。
所以我觉得他们选择RGB In、Action Out这条路线是有充分理由的。但这并不意味着三维能力不重要,更可能是因为现阶段的任务需求、数据成本和技术路径,共同推动了这样的选择。
16. 未来想做的方向
我会考虑拓展到Robotics方向上,但不是当下意义上的Robotics。因为我认为,机器人或者更准确地说Physical Intelligence,一定会是下一波巨大的机会。今天大家做的GPT、Gemini、Codex这类系统,本质上是在做Digital Intelligence,而我非常相信,智能的发展一定会从Digital Intelligence走向Physical Intelligence。
但我不太确定的是,我们现在是不是应该把太多精力放在一些特定的机器人任务上,比如Manipulation Task里的各种细分问题。
我真正感兴趣的,其实还是前面提到的那个故事:未来会不会出现一个类似GPT-9.8的模型,它拿到任何一个机器人之后,都能快速理解这个机器人、学会操纵它,并与真实世界交互。我相信这一天一定会到来。
所以相比于解决某一个具体机器人任务,我更关心的是,怎样为那一天做准备,怎样推动整个领域朝那个方向发展,怎样让这样的故事最终成为现实。
重建本身当然很好玩,也很优雅,但我已经在这个方向做了很长时间。相比继续深挖重建本身,我更想思考的是,它如何成为通往下一阶段智能系统的一部分。
References:
编者按:
写了这么久的博客,也没做这个正式自我介绍,借着建元这期访谈,我也介绍下自己:我叫王建明,目前是英诺基金的执行董事,主要看机器人方向,过往主导和深度参与的机器人相关项目包括:云深处、镁伽机器人、苏度科技、破壳机器人、鹿明机器人、诺亦腾机器人、傲鲨智能等。我从2017年开始看机器人方向,那是一个机器人赛道还很冷门的年代,看到今年也快10年了。
我近期非常关注对3D Vision有深入理解的人,地球上的几乎所有动物都有两只眼睛一定是有道理的。
我们投非常早期,现在的投资竞争太激烈了,一不小心就好几轮了,我写文章的目的,就是为了sourcing,所以关注具身智能、机器人和AI领域的创业想法。