前段时间,石麻笔记的公众号后台收到一个读者的留言“期待是否可以出一期专门关于CoPa,ReKep,VoxPoser,这类零样本、主要通过推理来完成相关机器人任务的文章呢?我个人感觉这可能是实现通用和泛化能力最主要的一条路径,尽管这条路径在具体复杂技能学习上还需要进一步优化。”
这个留言里提到的CoPa,我们之前做过一期采访对话高阳:具身大模型框架ViLa+CoPa,留言里提到的另外两个工作ReKep和VoxPoser之前也获得过国内科技媒体的广泛关注。我们很荣幸的邀请到这两篇论文的一作黄文龙作为这期文章的嘉宾来对这类零样本、主要通过推理来完成机器人任务的路线答疑解惑。
ReKep: Spatio-Temporal Reasoning of Relational Keypoint Constraints for Robotic Manipulation的作者包括Wenlong Huang, Chen Wang, Yunzhu Li, Ruohan Zhang, Li Fei-Fei。VoxPoser: Composable 3D Value Mapsfor Robotic Manipulation with Language Models的作者包括Wenlong Huang, Chen Wang, Ruohan Zhang, Yunzhu Li, Jiajun Wu, Li Fei-Fei,其中黄文龙为一作。
黄文龙目前是斯坦福大学计算机科学专业的三年级博士生,由李飞飞教授指导,隶属于斯坦福视觉与学习实验室(SVL)。他于 2018 年至 2021 年在加州大学伯克利分校获得了计算机科学学士学位,导师包括 Deepak Pathak、Igor Mordatch 和 Pieter Abbeel。他曾于 2024 年在 NVIDIA 的西雅图机器人实验室工作,并于 2022 年在 Google Brain 的机器人团队实习。
查看原文目录
以下为本文目录
👇
第一部分:VoxPoser和ReKep的路线概览
1. ReKep和VoxPoser属于哪种路线?
2. 怎么理解在不同层面的Reward?
3. 和强化学习里的Reward同个概念吗?
4. 比端到端的方法更有实际应用的潜力吗?
第二部分:VoxPoser和ReKep的方法介绍
5. VoxPoser的核心思想
6. ReKep的核心思想
7. ReKep里关键点的关系如何建立?
8. 怎么理解时间上的关系?
9. 为什么ReKep的demo里衣服叠不整齐?
10. 怎么将空间信息与LLM联系起来?
11. ReKep到具体应用有多远?
第三部分:分层模型vs端到端模型vs世界模型
12. 端到端与分层模型
13. Leaning Dynamics+MPC
14. World Model是什么?
15. 大模型可否成为机器人需要的世界模型?
16. 3D数据从2D数据来还是从3D扫描设备来?
17. 和RL和IL的结合
第一部分:ReKep和VoxPoser的路线概览
1. ReKep和VoxPoser在如今机器人学习(Robot Learning)的操作路线中属于哪类?
从数据的角度出发,理解机器人技术中的操作应用可能更为清晰。在操作应用中,当前的一大难点是把自主的机器人部署在开放世界、家庭环境、有人存在的场景,或者其他非结构化环境。这些场景中的操作任务涉及到的挑战和数据来源可以从以下几个方面进行划分。
第一类是机器人本体的真实世界数据(Real-world Data),这种数据来源于真实机器人在实际环境中采集的数据。它是最直接的、与实际应用最贴近的,但通常难以获得大规模、丰富的多样性。
第二类是仿真数据(Simulation Data),这类数据来自物理仿真环境,通过虚拟环境模拟不同的操作情境。与真实世界数据相比,仿真数据可以灵活地进行调整和扩展,用于训练机器人执行任务,尤其是在没有足够真实世界数据的情况下,但同时面临双向的现实到仿真(Real-to-Sim)以及仿真到现实(Sim-to-Real)的偏差。
第三类是互联网数据(Internet-Scale Data),主要包含的是人类作为本体的数据,包括视觉、语言、视频等多种模态。例如,YouTube 上的视频、VR 环境中的数据、以及用于已有的大模型训练的数据等。这类数据的特点是来源广泛,在语言和视觉方面都富有可以提取的语义信息,能够提供常识性知识,但是在物理交互层面面临着缺乏精确度以及具身性差距(Embodiment Gap)的挑战。
在机器人领域,这三类数据构成了主要的数据来源。如果采用端到端模仿学习的方法,给定一张图像并直接输出机器人动作,这通常依赖于真实世界数据。如果采用端到端的强化学习(RL),因为需要一个可以反复交互的环境,则往往依赖于仿真数据。
另外也有许多工作使用模块化的机器人栈来引入互联网的数据或是在互联网数据上训练的大模型,我的研究(从以往的将大模型用于任务规划的工作到最近的 VoxPoser 和 Rekep)以及领域其他相关的工作(如CoPa、MOKA 和 PIVOT)则属于这个类别。
这里的互联网数据的丰富性和多样性提供了机器人在开放世界泛化的可能,但由于是一个模块化的系统,于是一个关键问题是:这些数据,或是基于这些数据训练的大模型,应该以何种形式存在于一个机器人栈中呢?我的一系列研究给出的答案是:它们应该用于提供机器人操作的任务表征(Task Representation),这既可以是高层次语义层面的任务表征(例如将一个复杂任务分解成几个不同的子任务),也可以是在低层次在三维空间和时间维度的任务表征(例如在一个倒水任务里,茶壶和茶杯在空间中的位置要求和顺序)。
如果想要从数学上去理解和定义这个用途,我们可以借用决策框架中的一个经典模型——马尔科夫决策过程(MDP,Markov Decision Process)。MDP 的框架里一般定义几个东西:
第一是 state(状态),或者叫 observation(观测)。两者有区别,但为了简化,我们统一称为 state。通常,机器人上可能有一系列传感器(如摄像头),它可以观察到周围环境,也可以测量机器人自身的状态。这些都是 state 的组成部分。
第二是 action(动作),在机器人操作的任务中,这个一般被定义为机器人的关节的指令。
第三是 reward(奖励),人类往往想让机器人完成某项任务,而这个任务是什么,该做哪几个子任务才能完成,以及每一个子任务是如何具体定义的,这些都可以被涵盖在奖励函数中。
每一步都会有一个 state、一个 action 和一个 reward。此外,MDP里还有另外一个非常重要的模块是transition function(转移函数),用于描述当前的 state 和 action 如何决定下一个 state,根据具体的语境,这个函数可以是物理世界本身,或是一个 “世界模型(world model)” 、“动力学模型(dynamics model)” 、 “模拟器(simulator)”。
在 MDP 的框架下,这些元素被串联起来,每一步都有 state 和 action以及reward,通过采取动作(action),根据转移函数(transition function),机器人从一个状态(state)过渡到下一个状态(state),根据具体执行的任务获得当下的奖励(reward)。在这个框架中,无论是端到端学习,还是模块化的方法,都可以很好地表示。即使是没有显性奖励函数定义的模仿学习里,也可以把对expert action(专家动作)的模仿看作为奖励函数。
一般在机器人部署的时候,我们往往需要从当前状态推断当前的动作,因此在端到端的框架里,我们直接学习一个Feedback Policy(反馈策略)将状态直接映射到动作。在这种情况下,奖励和转移函数也被隐式地学进了这个策略中,所有内容都被整合到一个神经网络中。这样虽然做了极大简化,让这种方法在contact-rich(接触丰富)的任务中有很大优势,但是缺点则是把具体某个任务的语义信息(奖励函数)学进了一个黑盒模型中,在部署的时候如果有一个训练时没见过的任务,则往往很难泛化。
带着这个动机,结合着已知互联网数据可以提供丰富的语义信息,我的研究探索的是将task-specific(任务相关)的语义信息和task-agnostic(任务无关)的物理信息尽可能地解耦,解耦的尽头便是探究一个很有意思的科学问题:机器人如何零样本泛化到一个新的任务,即使零样本意味着在成功率上必然不如有样本的学习方法。巧合的是,这种解耦则恰恰对应了MDP框架下的task-specific的奖励函数,以及task-agnostic的转移函数。
因为做了解耦,我们不再从状态直接到动作,而是借用机器人领域已有的模块化框架,通过奖励函数以及转移函数通过优化的方法来得到动作。这是一种更结构化的方式,而我目前的工作探究的主要是如何从大模型中提取这里需要的奖励函数(也可直观的理解为“任务表征”),以及如何把它们应用在机器人的操作任务中。
2. 怎么理解在不同层面的任务表征,比如上层任务规划到子任务执行?
在这个框架下,任务表征可以定义在不同的抽象层次上,但是本质上都是将一个抽象的、语言表达的目标任务“翻译”成在一个机器人的状态以及动作空间里的函数(即奖励函数)。例如在Task Planning(任务规划)的领域里,机器人的动作空间则是各种子任务的排列组合,这些子任务往往是在语言层面的。例如,任务是“做早餐”,对应的操作可以是:第一步,“打开冰箱”;第二步,“取出鸡蛋”等,这些操作通过语言来描述。
而如果我们需要更加精细的关节动作或终端执行器的操作,我们则需要这个任务表征可以处理这种存在于三维空间和时间维度的动作。于是,VoxPoser 和 ReKep 的研究方向正是探讨如何将一个语言指令转化为三维空间和时间维度的reward。而这里的关键则是运用大模型通过互联网数据训练获得的丰富的语义和常识信息,将一个往往描述不够充分的语言指令,转化到一个机器人可以理解的在三维空间和时间维度的函数,从而可以零样本完成一项没见过的任务。
3. 这里的Reward和强化学习里的Reward是同一个概念吗?
其实,强化学习中的 reward 和我们讨论的概念基本是完全一致的。在强化学习中,reward 通常定义在一个特定的环境中,而这个环境一般是仿真环境。在仿真环境中,reward 通常由人类设计。例如,针对“导航”任务,reward 的定义可能非常简单,比如根据从点 A 到点 B 的距离来评估以及避开障碍物。
为了提升学习效率,我们常常采用通过仿真环境中的特权信息来定义reward。例如,在叠衣服的任务中,通过仿真环境的特权信息,我们可以直接获得衣服的袖口和领口的位置,这样可以更加有效地指导强化学习的训练过程。
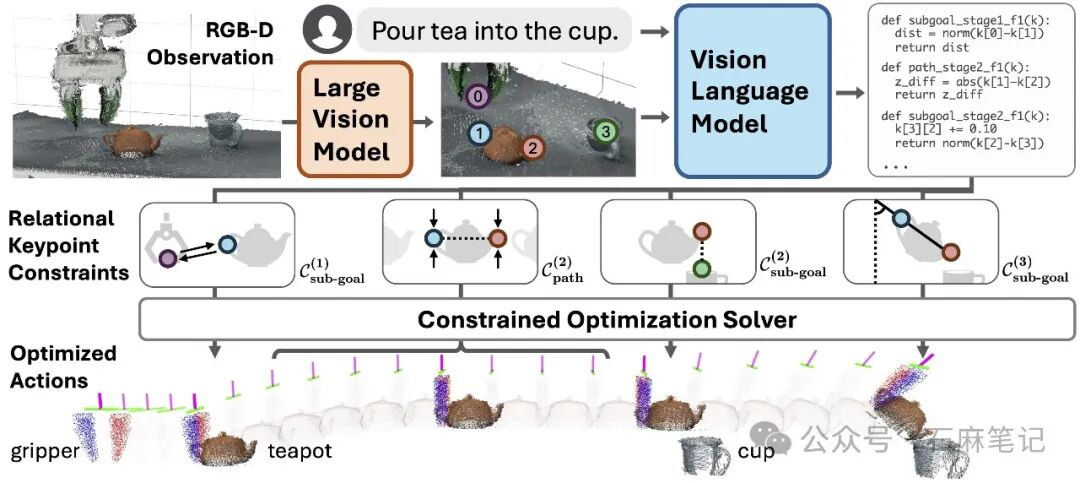
然而,在 VoxPoser 和 Rekep 的研究中,我们设计的 reward 更接近于真实世界的情况。在现实环境中,我们无法获得物体的精确 3D 模型,也无法直接获取接触力等物理信息。因此,我们只能依靠视觉感知来定义 reward,这也可以称为visual reward(视觉奖励)。通过这种基于视觉的 reward function,我们可以推导出机器人应采取的动作。
4. 这条路线看起来比端到端的方法更有实际应用的潜力吗?
这取决于目标。如果目标是一个非常明确的场景,比如在工厂里拧螺丝、安装电池,或者叠衣服,这种重复性的工作可以通过收集大量数据(如 1000 条甚至 1 万条)来解决,端到端方法在这些场景中肯定会更加鲁棒和有效。
但如果目标是开放环境的任务,比如进入一个陌生的家中做咖啡、做早餐,就无法提前为所有可能的环境收集数据。在这种情况下,更结构化的的方法,由于引入了更多的inductive bias(归纳偏差),在缺乏数据的早期或许会更具优势。
第二部分:VoxPoser和ReKep的方法介绍
5. VoxPoser的核心思想
VoxPoser 的核心概念是利用强大的LLM和VLM来解决任务表征和 reward 问题。我们关注的关键问题是如何有效表示任务,并将抽象的任务分解并与机器人的具体操作关联起来。
在任务中,往往存在许多细微的差别。例如,"打开一个电饭锅" 或 "开启一个电水壶" 这样的任务看似简单,但实际上涉及到大量的常识理解。有时,机器人需要按下按钮,而不是直接掀起盖子,这些细节通常是VLM和LLM捕捉的。然而,这些模型主要在语言层面表达常识,无法直接在三维空间中为机器人提供具体的操作指导。
VoxPoser 的核心思想是通过利用VLM和LLM的常识知识,借助模型生成代码,将常识知识映射到三维空间。例如,我们将机器人的环境视为一个三维网格,模型通过生成代码来在这个离散空间中索引特定区域,从而将语言知识与三维空间中的具体操作关联起来。
举个例子,打开电水壶时,模型可能会指出:不是直接掀起盖子,而是先找到按钮并按下。这种方法允许在空间层面上进行知识的组合。模型不仅能够指引机器人在哪些地方进行交互,还能指出哪些地方应避免接触,或提供环境中的限制信息。例如,如果机器人接近灶台,模型可能会告诉它,灶台是危险的,应该保持一定的距离。
最终,模型生成一个三维空间的价值图(value map),它告诉机器人在哪些地方进行交互,哪些地方应该避免,从而形成一个三维空间的 reward。然而,仅有 reward 并不足以直接生成机器人的动作(action)。为了从 reward 推导出具体动作,通常有两种方法。
第一种是基于模型的规划(Model-based Planning),通过一个世界模型(或叫做动力学模型)进行“想象”,去探索预测不同动作对环境的影响,从而规划出通向目标的路径。
第二种是强化学习(RL),这也需要一个世界模型,只是他不是通过模型来做规划,而是学一个反馈策略(Feedback Policy),相当于把世界模型当作一个的环境中运行强化学习算法,学习归纳出一个从状态到动作的映射的神经网络。
在这些方法中,基于模型的规划在应用上更为简单,也是 VoxPoser采用的方法。我们结合三维空间的 reward进行规划,指导机器人生成具体的动作。VoxPoser 的这一系列工作,主要聚焦于如何通过三维空间的映射,将语言模型中的常识性知识与机器人的操作进行具体结合,从而解决现实环境中的任务执行问题。
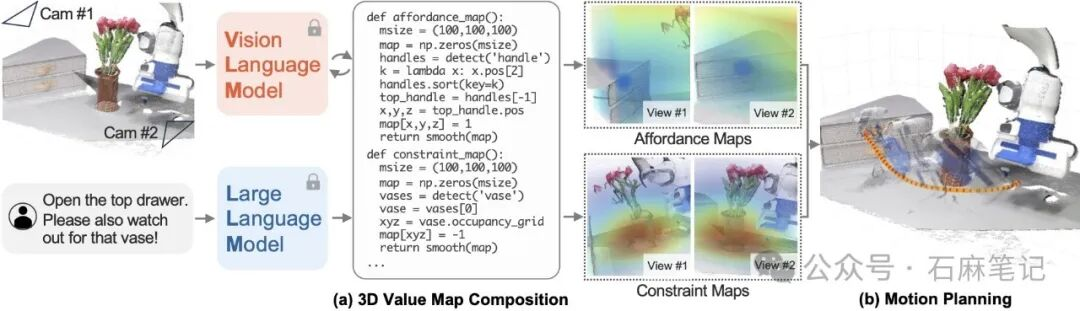
我们的网站上有一个可视化展示,你可以看到类似热成像图的效果。这个图中哪些地方被高亮就表示是需要交互的区域(Affordance Maps),而没有被高亮的地方则是机器人不应该交互的区域(Constraint Maps)。有了这样的 3D reward 图,机器人就可以根据这些信息进行操作。比如打开上面的抽屉,同时还需要注意不要碰到旁边的花瓶。在这种情况下,你可以看到抽屉的位置被高亮,而花瓶周围的区域则没有被高亮,表示机器人需要避开。
不过需要说明的是,在我们讨论时一直说的是 reward,但在 model-based planning 的社区中,通常大家使用的术语是 cost,而不是 reward。这两者其实是完全一样的东西,只是一个是正向值,一个是负向值。在 cost 表达中,值越低越好。所以抽屉的位置就是 cost 最低的地方,而花瓶旁边的地方 cost 则较高。
6. ReKep的核心思想
ReKep是在VoxPoser的基础上扩展了时间维度,同时解决了 Voxposer 方法中的一些问题。时间维度的扩展主要是为了应对任务中的时间依赖性。VoxPoser 方法专注于三维空间(3D space),但许多任务中还存在时间上的依赖关系,例如,“倒水”任务包含多个步骤:第一步,机器人需要抓住水壶的把手;第二步,将水壶移至杯子的正上方;第三步,开始倒水。在这些步骤中,value map 会逐步变化。例如,第一步会高亮显示水壶把手的位置,第二步会高亮显示杯子正上方的区域。
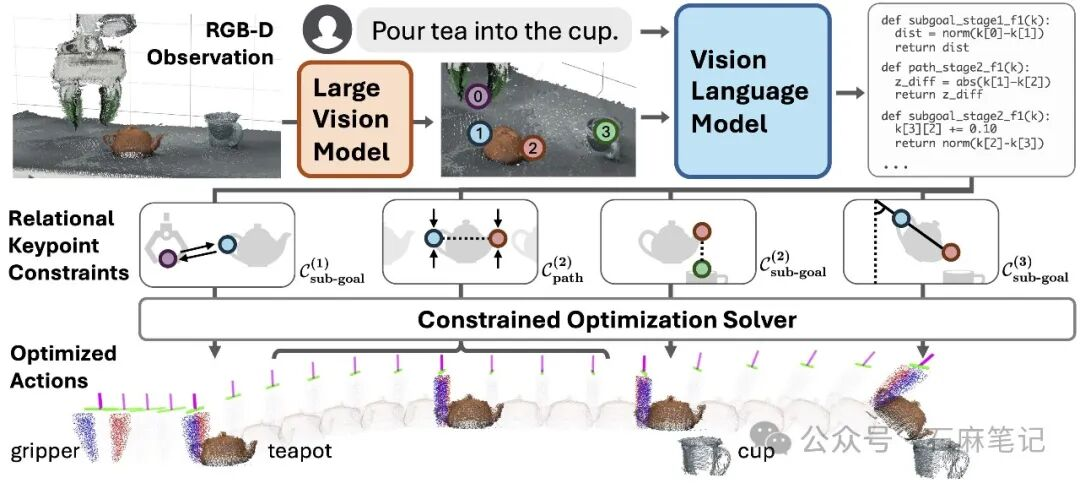
然而,VoxPoser无法捕捉任务中的细致约束。例如,拿起水壶时需要保持平稳,不能倾斜;倒水时要确保杯子位置正确,如果杯子被移开或机器人失去对水壶的控制,必须重新调整。VoxPoser 的三维 voxel grid 只能表示位置(position)信息,但无法有效表示旋转(rotation)和时间依赖性。因此,我们提出了ReKep 方法,它将任务表示为关键点(keypoints)之间的关系。
例如,“倒水”任务可以定义以下关键点和关系:第一个关系,机器人手上的关键点和水壶把手上的关键点需要靠近;第二个关系,水壶把手的关键点和水壶虎口的关键点要处于同一高度,以确保抓取时保持平稳;第三个,水壶虎口的关键点和杯口的关键点要在同一垂直线上;第四个,杯口和水壶虎口的夹角需满足特定条件,以便顺利完成倒水。
这些关键点的关系以及他们的具体顺序定义了任务的约束,只有满足这些约束,任务才能成功完成。通过经典的约束优化(constrained optimization)工具,我们可以将这些约束转化为具体的机器人动作(robot actions),确保任务的顺利执行。
7. ReKep里关键点的关系如何建立?是自动生成的吗?
针对不同任务甚至是不同环境,关键点以及关键点之间的关系都会不一样。我们的研究核心思路是利用大模型(如 VLM 或 LLM)来推断和指定这些关系。也就是说,这些关系并非由人工定义,而是依赖于大模型的推理能力及其内在的知识。这种方法的优势在于,模型能够从大量数据中学习并自动推导出适应不同任务和场景的关键点关系。
一个直观的例子是叠衣服。对于不同类型的衣服,折叠方法可能各不相同,这些折叠方式可以通过关键点关系(keypoint relations)来表示。举个例子:第一步,哪些关键点需要对齐(align);第二步,哪些关键点需要叠在一起。无论衣服的种类如何,这种基于关键点关系的方法都能够捕捉到其中的规律和关系。
8. 怎么理解时间上的关系?
这种关系可以通过一些具体的案例来直观地展示。例如,往杯子里倒茶水这个视频,系统需要判断当前任务的步骤是否满足时间依赖性。如果在倒水的过程中,杯子的位置被改变,机器人需要进行动态的调整:首先需要停止倒水,回到上一步先对齐杯子的位置,再重新倒水。在任务开始时,ReKep只需 query一次大模型,后续则通过优化来处理干扰和调整响应。
VoxPoser无法自行推理这些依赖性,在发生上述这种干扰情况时,系统可以选择重新query大模型,但这意味着需要重新生成并优化整个任务。每次遇到这种干扰时,系统就需要重新向大模型查询,等待新的生成结果,然后再进行优化处理。这一过程会带来额外的计算和等待时间,因此如何高效处理这些依赖性是未来系统优化的重要方向。
如果有一天我们能够实现实时调用大模型,比如在 1 秒内完成几十次 query,那么这种依赖性问题就能够得到有效解决。不过,VoxPoser在处理旋转(rotation)相关的问题时仍然存在较大的局限性。这也是为什么我认为keypoint relations 是一种更好的任务表示方法。
9. 为什么ReKep的demo里衣服叠不整齐?
这里有两个重要的原因,第一点是系统缺乏一个针对衣服的很好的动力学模型(dynamics model)或世界模型(world model)。在这个工作中,我们专注的主要是reward或者cost的问题,但要很好的完成一个叠衣服的任务只有cost是不够的,我们需要一个动力学模型才能规划机器人的动作,这个动力学模型哪里来呢?
在我们的研究中,我们有一个比较重要的假设,当我们假设机器人抓住一个关键点(keypoint)时,这个关键点的运动轨迹会完全跟随机器人夹爪的运动。也就是说,如果夹爪向前移动5厘米并旋转30度,我们假设这个关键点也会以相同的方式移动。但对于柔性物体,比如衣服或围巾,这种假设并不成立。例如,当机器人抓住围巾的一端并移动时,围巾中间的关键点位置也会发生变化,但这一变化并不会完美跟随夹抓的运动轨迹。这种误差是导致衣服无法叠整齐的主要原因,因此如果我们能够开发出一个更精确的动力学模型或世界模型,能够真实地反映柔性物体的运动规律,就能够有效解决这些问题。
另外一个原因与我们探究的零样本的场景密切相关,也就是说,在完全没有关于这个任务的数据的情况下,如何最大化地推动系统的泛化能力。通常意义上的泛化指的往往是物体在新的位姿下的操作,或者是类似物体在新环境中的操作,这里甚至是一个新的任务,因此多了更多挑战。
这也是我个人研究的主线之一。我关注的问题很多都与泛化能力有关,尤其是任务级别的泛化。举个例子,当我遇到一个新任务,这个任务可以通过语言简单描述,如“做早餐”或“叠衣服”,如何在没有专门数据的情况下,利用现有工具或数据来最大化地实现泛化,这正是我的研究兴趣所在。
但这并不意味着我反对使用数据,我认为数据是非常重要的。然而,零样本的场景能更好地促使我们思考:珍贵的机器人数据究竟在什么地方是必须的?如果机器人的数据用来实现现有大模型已经具备的能力,例如识别物体位置以及指定不同种类衣物该如何折叠,那或许不是这些数据的最佳用途。相反,我们可以依靠大模型及其先验知识提供泛化能力的基础,去思考机器人数据应该用于解决哪些已有模型无法覆盖的核心问题。
在机器人领域,数据不足一直是一个亟待解决的问题。我个人认为,这个问题可能一直会存在到我们能够实现大规模的机器人部署。因此,我对零样本场景特别感兴趣,因为它能够推动我们找到更高效、更精确的方式来使用数据。
10. 怎么将空间信息与LLM联系起来?
在ReKep和VoxPoser这两个项目中,我们采用了不同的环境表示和交互方式。VoxPoser是将环境表示为一个 3D array或网格(grid),例如一个 100×100×100 的三维网格。在固定坐标系后,我们可以确定特定位置的索引,比如把手的位置是(15, 20, 30)。这样,语言模型可以通过生成代码(code)将知识映射到 3D 环境中。
相比之下,ReKep采用了更直接的方法,利用视觉语言模型(VLM)直接处理图像输入。我们在图像中标记关键点(如0、1、2、3、4),并告诉模型这些点的含义。例如,某个点表示机器人应该抓取的位置,另一个点则是需要避开的地方。这种方法不依赖于固定的3D网格,而是通过描述点与点之间的关系来实现任务。
关键在于,这些点的选择并非随意,而是必须在有意义的位置上标记。为了优化关键点的选择,我们可以使用自监督视觉模型(如DINOv2),这些模型能够有效地捕捉图像中的语义信息,并帮助提议合适的关键点。
11. ReKep到具体应用有多远?
我认为这一系列工作更多属于一种探索,目前在鲁棒性方面还有很大的提升空间,因此暂时无法直接应用于产业化场景,但介于模块化的优势,可以优化的方向也十分清晰。
首先,这一系列工作高度依赖于大模型的能力。目前,我们迫切需要更强大的大模型来提供更丰富的在三维时间和空间维度的先验知识。例如,我们在 GPT-4 发布前的两个月就开始了这项研究,而在GPT-4以及后续GPT-4o发布后,我们发现其推理能力显著提升。这表明,随着未来更强大的VLM(视觉-语言模型)的出现,它们能够为系统提供更好的 reward 和指引。
另外,我们需要学习一个通用的世界模型(World Model)。我们所需的世界模型必须能够适应开放环境,而不仅限于实验室中的封闭环境。目前的一些流行的视频生成模型,比如 OpenAI的Sora,大多数属于 2D 层面的世界模型。然而,对于 ReKep 来说,我们需要一个 3D 的世界模型,它必须能够在真实的开放场景中工作,且与视觉层面的 reward 一样,不能依赖于特定的任务数据。
例如对于像叠衣服这样的任务,给一件新的没见过的衣服,一个预训练好的世界模型需要有可以预测各种动作下衣服的形变的能力。这是个非常困难的任务,但是它的学习目标非常明确,同时也对“任务”这个概念进行了解耦,因此很可能是未来很重要的方向之一。
第三部分:分层模型vs端到端模型vs世界模型
12. 端到端与分层模型
这两种方法可能都会用到大模型,但区别在于一种方法是明确划分现有大模型的用途(分层路线),另一种方法则是通过fine-tune将大模型adapt到机器人的场景中(端到端路线)。例如 Physical Intelligence 的 pi-0,或是Google的RT系列工作,这些都属于端到端路线。这里因为往往用expert action进行训练,因此没有分层的概念,更多的是一种非结构化(unstructured)的系统,所有都在Latent space中完成,因此难以分割哪些权重用于处理视觉信息,哪些用于处理奖励信息,等等。
而另一种方法是采用分层结构的方法,例如基于 MDP(马尔可夫决策过程)框架分割成奖励函数和转移函数。这种方法能够更清楚地识别需要改进的具体环节。
13. Learning Dynamics+MPC
Learning Dynamics+MPC里的 MPC(Model Predictive Control) 和基于模型的规划(model-based planning)本质上类似,尽管在一些细节上和关注点有所不同,它们都依赖于一个模型(model)和一个目标函数(objective function),例如 cost function 或 reward function,通过模拟机器人动作对环境状态的影响来推导出当下的最佳动作。
在这种方法框架下,一个显而易见的缺失是高质量、通用的世界模型(world model)。然而,学习一个通用的世界模型本身是一个极具挑战性的问题。
在社区中,关于如何解决这类问题的观点也存在分歧。一些人认为,直接学习一个通用的机器人策略(general-purpose robot policy),将观察(observation)直接映射为动作(action)是更简单有效的做法;而另一些人则认为,学习一个世界模型会更加通用,数据也更加丰富。无论选择哪种方法,都有可能实现这个通用目的机器人。
14. World Model是什么?
世界模型有一个非常明确的定义:它的输入是当前的状态(current state)和当前的动作(current action),输出是下一步的状态(next state)。本质上,这就是MDP框架中的转移模型(transition model)或动力学模型(dynamics model)。
区别在于如何定义状态(state)和动作(action),以及它们的具体表征(representation)是什么。例如,对于一个视频预测模型,状态可以定义为图像帧,可能是一帧或多帧;而动作可以是文本指令,比如“打开这个抽屉”。在这样的设置下,模型的预测输出是抽屉打开后的下一帧图像。
在机器人领域,世界模型的动作表征通常是机器人在三维空间或是在关节空间的动作,其目标是预测这些动作如何改变环境。而状态表征可以有多种形式,包括跟视频模型一样的2D图像,或是3D的表征,例如点云、网格(mesh)、体素(voxel grids)等等。
世界模型的核心任务是用这些状态和动作表征来预测环境的动态变化。不同任务的挑战在于如何设计合适的表征,并使模型能够对复杂环境的变化做出准确的预测。
15. 大模型足够强大是否可以带来机器人需要的世界模型
这确实是一个开放性问题(open question),不同的研究者有不同的观点和方法。我个人认为,现有的基于语言的大模型(例如语言模型和视觉语言模型)不能够成为机器人的世界模型。
无论是大语言模型(LLM)还是视觉语言模型(VLM),它们的强项主要体现在对离散符号(如自然语言或是代码)的理解与推理,以及对图像在这些离散符号空间中的映射关系的理解与推理。而机器人所需的世界模型的关键在于能够基于机器人动作预测下一个状态(next state),这个状态往往是连续的、高频的,并且是存在于三维空间的。
因此,是否能够将这种能力整合到现有的大模型中,仍然是一个未知问题。我个人认为,我们可能需要一种全新的方法,或者一种完全独立于大语言模型的新型模型,专门用于预测这种三维的空间状态。
这种模型可以与大语言模型形成互补关系。一个直观的类比是那些专属于人类的常识和猫和人都共有的常识之间的区别。大语言模型或视觉-语言模型更擅长捕捉人类的关于符号的常识以及这些知识在视觉空间的映射,比如“打开水壶可能需要按按钮”以及这个按钮在哪,但猫可能没法深刻理解这个语义的概念并且零样本泛化到新的场景中。
与此同时,不论是小动物或者是人类,甚至一个出生不久的孩子,都对3D环境有着非常强的高频率的预测能力。因此,我认为,这两种模型本质用途可能是不同的,但它们也有可能被可以被结合到一起。例如,最近许多的大模型工作在尝试将 2D 生成能力和 VLM 整合在一起,效果不错。所以,也不排除未来这些能力能够被统一到一个模型中的可能性。
16. 3D数据应该从2D数据来还是从3D扫描设备来?
在谈到纯粹的3D世界模型时,数据未必是目前最大的瓶颈。当然,对于机器人任务而言,机器人动作数据的获取难度确实是一个制约因素,但从视觉数据的角度来看,当前视觉数非常丰富。视觉数据的匮乏程度远低于语言数据,因为语言和代码的数据量受限于人类的生产能力,而视觉数据则是由自然生产的,可以由任意摄像头二十四小时进行采集。事实上,全球摄像头的数量和生成的数据密度远远高于文本数据。
因此,我认为视觉数据本身并不是瓶颈。尽管许多现有的数据是2D的,但很多研究已经证明,从2D数据生成3D表征是可行的。很多时候,我们并不需要直接依赖3D数据,因为2D数据实际上是3D空间的一种投影(projection)。如果有更好的算法,我们就可以从 2D 数据推导出 3D 表征,但目前算法层面还是有大的提升空间。
我认为从 2D 到 3D 的方法非常依赖于算法。如果有成熟的 3D 数据采集硬件,它短期内绝对是一个非常有效的捷径。这有点像 Waymo 和 Tesla 的区别:Tesla 坚信可以通过 2D 摄像头的视觉数据来解决 3D 问题,并且认为只要数据规模足够大,3D 表征就不成问题;而 Waymo 则选择通过激光雷达直接采集 3D 数据,然后逐步部署和优化。
两种方法都有其优势,我个人并没有强烈的偏好。每种方法都有可能走通,关键看具体场景和技术条件。我个人的感觉是,这取决于目标的定义。如果目标是针对少数几个特定的任务或环境,并且我们能够承担部署机器人采集数据的成本(比如示范数据或3D数据来构建世界模型),那么可以采用较高成本的解决方案,专注于优化这些有限任务。
但如果目标是构建一个通用机器人(general-purpose robot),我个人认为需要更加依赖现有的互联网规模数据。通过改进算法,我们能够从现有的2D或其他非3D数据中学习,减少对机器人采集数据的依赖。
理想情况下,我们不仅可以从这些数据中学到一个好的3D世界模型,还能够训练出更强大的视觉语言模型(VLM)和更好的reward model,例如在 ReKep 和 VoxPoser的基础上进一步优化。
有了这些模型后,我们可以通过规划和RL的方法,部署第一代相对通用的机器人。尽管这些机器人在诸如叠衣服等任务中可能表现不完美,但它们可以作为起点,通过逐步优化和数据积累,不断提升性能并解决初期的缺陷。当数据积累越来越多后,整个系统可以陆续变得更加端到端,从而实现更高的通用性和鲁棒性。
17. 和RL和IL的结合
强化学习(RL)与分层的方法从某种角度来讲非常契合。RL可以看成是一种基于模型的优化方法,它通过给定奖励函数和一个可以近乎无限次交互的环境(如 simulator或者world model),利用试错机制找到最优的动作序列或策略。
例如,大语言模型和视觉语言模型可以提供很好的奖励函数和任务表示,以及一个可以无限次query的世界模型,我们可以在世界模型中通过 RL 训练,找到满足任务需求的最佳策略,比如如何倒水和叠衣服。
相较之下,模仿学习较难直接与这种方法结合,因为模仿学习中常用的Behavior Cloning(行为克隆)强调的是端到端的映射——从观测(observation)到动作(action)。这种映射从视觉输入到行为输出,没有明确的中间层次。在这种情况下,模仿学习的端到端方式和需要明确模块化结构的任务建模(例如功能、模型等)之间并不直接匹配。
然而,这并不意味着两者无法结合,因为两者都有独特的优势和劣势,同一个机器人系统可以用不同技术路线解决不同任务,收集到的数据也可以反哺给系统里所有的data-driven的模块,进而提高其执行能力。
References:
ReKep
https://rekep-robot.github.io/
VoxPoser
MOKA
https://moka-manipulation.github.io
PIVOT
https://pivot-prompt.github.io
CoPa:
黄文龙主页