世界模型第四期,我们采访Motus,一个Unified World Model的工作,希望能够充分利用各种多模态、异构的数据,比如互联网视频、图文数据、机器人轨迹数据,以及一些任务无关的轨迹数据等等。也就是说,不同模态的数据都可以被利用,而不是局限在某一种数据形式上。
我们也邀请到了这个工作的参与者之一,谭恒楷博士来讲解这个工作,这篇访谈的内容仅代表谭博士个人观点。我个人非常推荐这期访谈,有一些看上去有些烧脑的技术细节,但非常直观的讲解。
查看原文目录
以下为本文目录
👇
1. 为什么Motus当初叫Latent Action World Model?
2. Motus和当下VLA以及WM的区别
3.Unified WM和传统World Model的区别?
4. 不同路径怎么走到机器人Policy?
5. Motus训练框架
6. Motus训练数据
7. 不同层级数据量的需求
8. 后训练阶段
9. next token prediction到next sate prediction
10. 为什么中国这么多世界模型相关的创业公司?
11. 和把Interactive World Simulator这类工作的思想对比
1. 为什么叫Latent Action World Model?
因为我们这个工作是去年发的,当时其实还没有“world action model”这个概念。这个概念是英伟达在今年一月底、二月初才提出来的,比我们这篇工作要晚大概两个月。
所以我们当时并不是从“world action model”这个角度出发的,而是基于另外两个初衷:一个是做一个unified的world model,另一个是latent action。我们是把这两点结合在一起,提出了一个统一的模型框架。
从更本质的角度来说,我们做这件事情的核心目标,是希望能够充分利用各种多模态、异构的数据。比如互联网视频、图文数据、机器人轨迹数据,以及一些任务无关的轨迹数据等等。也就是说,不同模态的数据都可以被利用,而不是局限在某一种数据形式上。
这其实是我们认为最关键的一点。相比之下,像一些只基于特定模态的方法,比如只做动作预测的模型,是很难把视频预测这一块纳入进来的,因此在数据利用上会有上限,也会影响它的泛化能力。
从更宏观一点来看,这也和AI发展的一个规律有关:AI的颠覆式突破,往往来自于找到一种新的范式,可以吞下超大规模的数据。从AlexNet到GPT,再到后来的视频模型,其实都是在“可以吞下的数据范围”方面有了跳跃式突破。
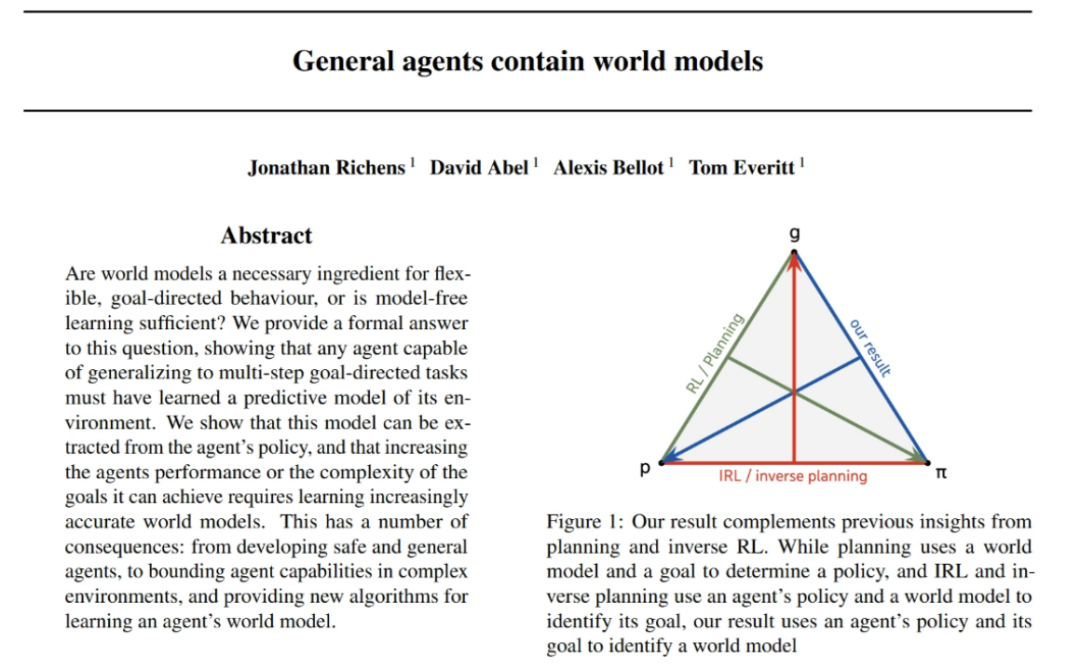
从理论上来说,Google Deepmind在25年6月份发了一篇General agents contain world models的论文,证明了通用agent内部必然包括一个世界模型。目标、dynamics model(世界模型)、policy三者有任意两者都可以推出另外一个,因此给定目标的情况下,建模世界模型和建模policy之间是互通的,可以用更统一的视角来看待这两者,也就是unified world models。
2. Motus和当下VLA以及WM的区别
你可以把这个东西画成一个九宫格来理解。
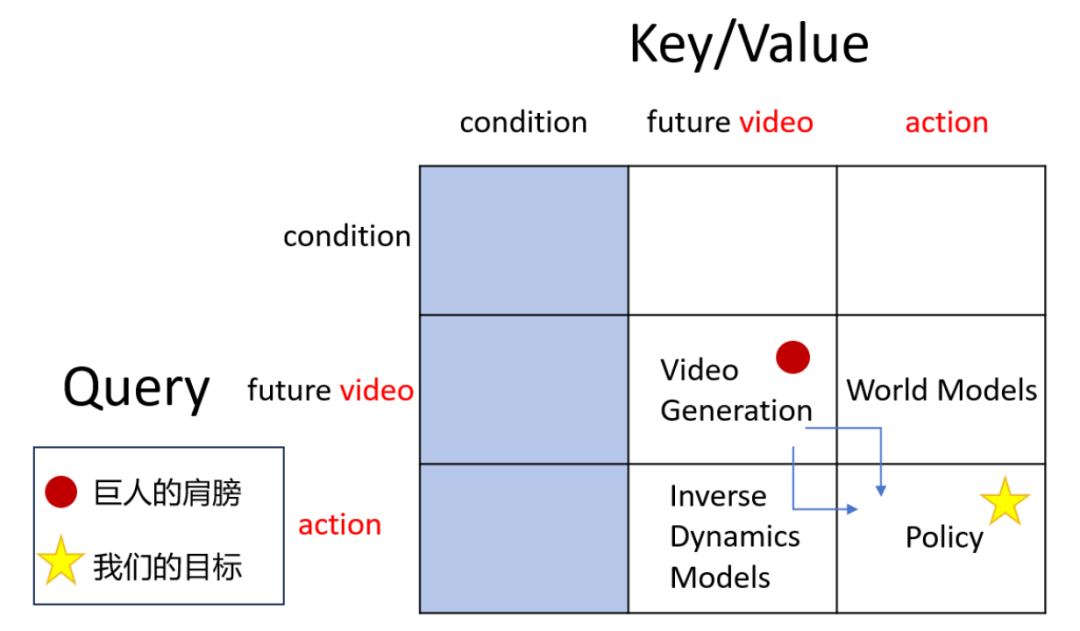
谭博士整理
具体来说比如,o₀是当前的observation,也就是当前这一帧,o₁到oₖ是未来要预测的这些帧;然后a₁到aₖ是未来的action。当然,observation可以扩展到更广义的“世界的观测”,而不只是视觉。
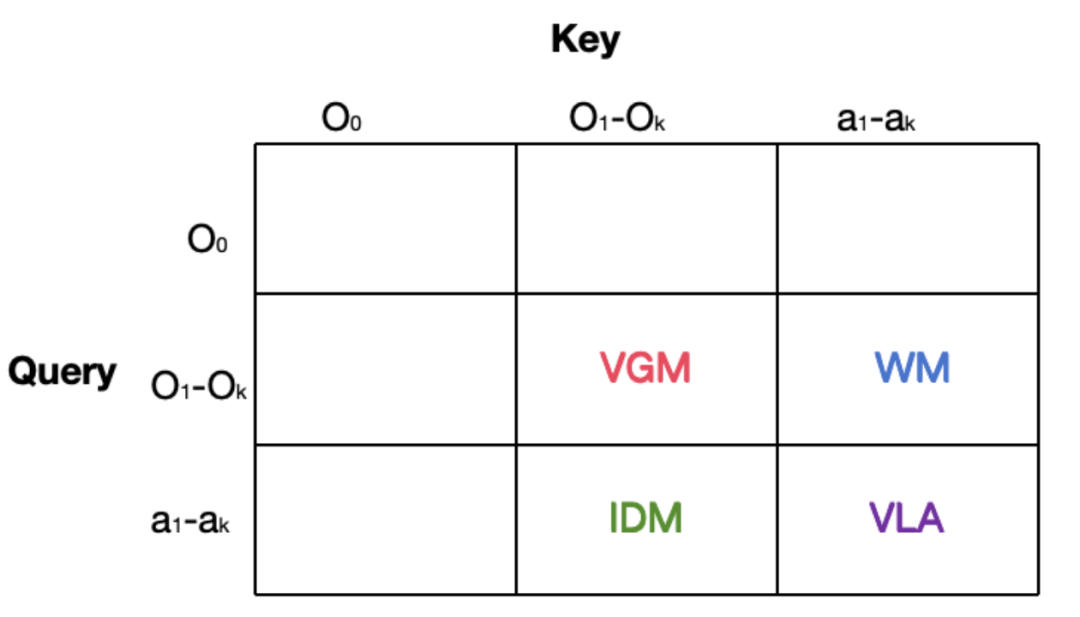
我根据谭博士草稿纸整理(方便上下文理解,两个图都放在这里)
VGM:Video Generation Model,视频生成模型;
WM:World Model,世界模型;
IDM: Inverse Dynamic Model,逆向动力学模型;
VLA: Vision Language Action Model,视觉-语言-动作模型
O:Observation(或者State)观察或状态,在以下的解释里Observations是2D Video;
a:Action,动作
Q(Query)=我想找什么信息(被预测的)
K(Key)/V(Value)=信息的索引/信息内容,也就是信息的来源
Attention=Query根据Key的匹配程度去从Value读取信息
如果从attention的角度来看,一边是Query,一边是Key/Value,本质上就是用当前的信息作为条件去预测未来,这种信息的流动在模型里是一定会有的,只不过建模的时候会分为不同的联合分布/条件分布/边缘分布。
所以可以这样理解,这四个象限其实分别对应不同的“区域”:有的是预测video,有的是预测action,有的是从video反推action,有的是做dynamics,通过action推video。
VGM:Video → Future Video
VGM(Video Generation Model)可以理解为“世界自己怎么变化”的模型,它只依赖当前或历史的视频帧,去预测未来的视频帧,本质是在学习视觉世界的动态规律(比如物体运动、接触、遮挡等)。本质上是在建模:
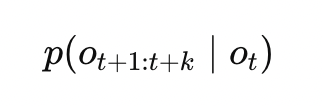
IDM:Future Video → Future Action
再比如IDM,它是反过来的,是根据未来的观测去预测中间的action。IDM(Inverse Dynamics Model,逆动力学模型)是从“结果反推动作”的模型,它根据前后两个状态(通常是视频帧或观测),来预测中间执行了什么动作。它的核心作用是把纯视觉数据中的“变化”转化为可用于控制的动作信息,没有action标注的数据对其非常关键。本质上是在建模:
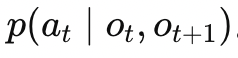
IDM 指的是 Inverse Dynamics Model(逆动力学模型):video →(IDM)→ action → policy;先做 video prediction,再用 IDM 解出 action
WM:Action → Future Video
World Model,是建模“动作如何改变世界”的模型,它根据当前状态和动作来预测下一时刻的状态或观测。给定当前状态和action,去预测下一步状态,也就是经典的dynamics model。传统的world model,其实主要是单向的,比如从action到video,也就是给定动作去预测未来的状态,这是一个单向流。本质上是在建模:
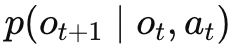
VLA(Policy):Video+Action → Future Action
像VLA的话,它其实主要是在做action这一块。action之间会做self-attention,比如有action expert这种结构,action内部会做attention。同时,它也会依赖当前帧,也就是condition在初始的observation上。但它不会去预测未来的observation,也就是不会去预测视频。所以它本质上是在拟合action分布,而没有把视频预测这块纳入进来,也就没法通过video prediction去“吞”视频数据。是从观测直接预测动作的模型,即根据当前的图像或状态输出对应的控制动作,本质上是在建模:
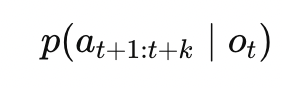
Unified WM(双向):Video ↔ Action 一起建模
而我们说的Unified World Model/ World Action Model,其实就是把这些块都放在一起,它不再只学习单一方向(如 dynamics 或 policy),而是在一个框架里把这些关系都建模出来。这样做的一个直接结果是,不同类型的数据都可以用进来。比如纯视频数据、没有任务条件的那种数据,还有机器人轨迹数据,这些都可以统一进这个框架里去训练。
从交互关系上看,video和action之间其实可以有四种组合(2×2的关系),分别是video→video、video→action、action→video、action→action。这些交互路径在训练时我们都是覆盖到的,对应的分布也都学到了。本质上是在建模联合分布,从而实现多模态信息的双向交互,一次训练推理不同模式(各种边缘分布和条件分布也可以推理)。
Unified World Model/ World Action Model和VLA的区别
相比之下,像VLA这种方法,本质上是单向的,一般是从observation去预测action,没有这种双向的联合建模。但我们做的unified world model,是希望把这几种关系都统一起来,也就是这四个方向的“流”都能建模,而不是只做其中一个。从这个角度来说,unified world model更像是一个更一般的框架,它可以同时覆盖这些不同的预测关系。
那为什么我们觉得这个方向是未来?本质上还是刚才说的那几点:它可以吸收更多类型的数据,可以利用已有的预训练模型,同时还能支持多种推理模式。归根结底,其实还是那句话——数据越多、覆盖越全,再靠算力scale起来之后,模型的能力就会更强。
3. Unified World Model和传统World Model的区别?
从底层来看,传统定义的world model,本质上可以理解为一个transition function,也就是给定当前状态和动作,去预测下一个状态。但unified world model不太一样,它不只是一个单一的transition function。
从概率建模的角度来说,它其实同时在建模多种分布,比如刚才说的那几种关系:video到video、action到video、video到action、action到action。这些不同方向的条件分布,它是一起去学的。所以它在底层算法上,和传统理解的world model是有区别的,不只是单向的dynamics建模,而是一个更general的联合建模框架。
所以可以理解为,我们这套方法更偏向一个概率建模更完整的框架,把不同方向的关系都显式纳入进来,这和我们长期做贝叶斯建模的一些思路是比较一致的。
很多人会把world model理解成一个transition function,也就是从当前state和action出发,去预测下一步state。从数学上来说,其实就是在建模这个条件分布:给定当前状态和动作,预测下一状态。所以严格来说,transition function本身也只是其中一个概率分布而已。
但我们这里的unified world model,不只是这一种关系/概率分布。你刚才说的这种transition,其实只是其中一个单向的“流”,也就是action→observation这一条。
而我们这里其实同时在建模多种关系/概率分布。如果把它写全的话,不只是这一条,还包括像视频生成VGM(obs→obs)、IDM(observation→action)、以及policy(action的self-attention)等等。
所以可以理解为,传统的world model只是这个大框架里的一个子集,而我们做的是把这些不同的预测关系都统一进来,一起去建模,而不是只做一个单一的transition。
4. 不同路径怎么走到机器人Policy?
底层其实大家是有共性的,比如diffusion本质上也是在做一种能量建模或者能量最小化的过程,这一层其实是共通的。但从建模方式上看,unified world model和传统理解的world model还是有挺大差别的。
很多做world model的人,他们的思路更偏向一种“逐步扩展”的路径。比如先把一个单向的world model(也就是transition model)做好,然后在这个基础上再去扩展,比如加上IDM,最后形成一个policy。这是一种比较自然、逐步搭建的路线。
而我们这边,其实一开始是更“激进”一点,尝试把这些东西一起做、一起建模,相当于直接用一个更统一、更scale的方式来解决。但这条路是不是更优,其实现在还在探索,也没有一个确定答案。
从当前大家的思路来看,其实有几条不同的“流”在尝试把video的能力传到policy上:
一种是通过IDM这条路径,比如先做video prediction,再通过逆动力学IDM把action解出来,这就是像UniPi, RoboDreamer, Vidar,Gen2Act,Lingbot-va,这一类的路线:VGM——IDM——得到Action Policy
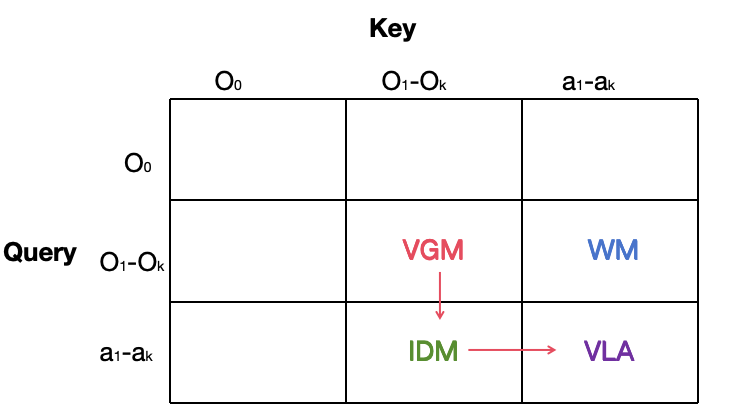
另一种是通过world model,比如action-conditioned world model,先把dynamics学好,然后在这个模型里面做RL或者planning,最终得到policy:WM——RL——得到Action Policy,所有做原始定义world model的团队应该都会想用WM来增强Policy。
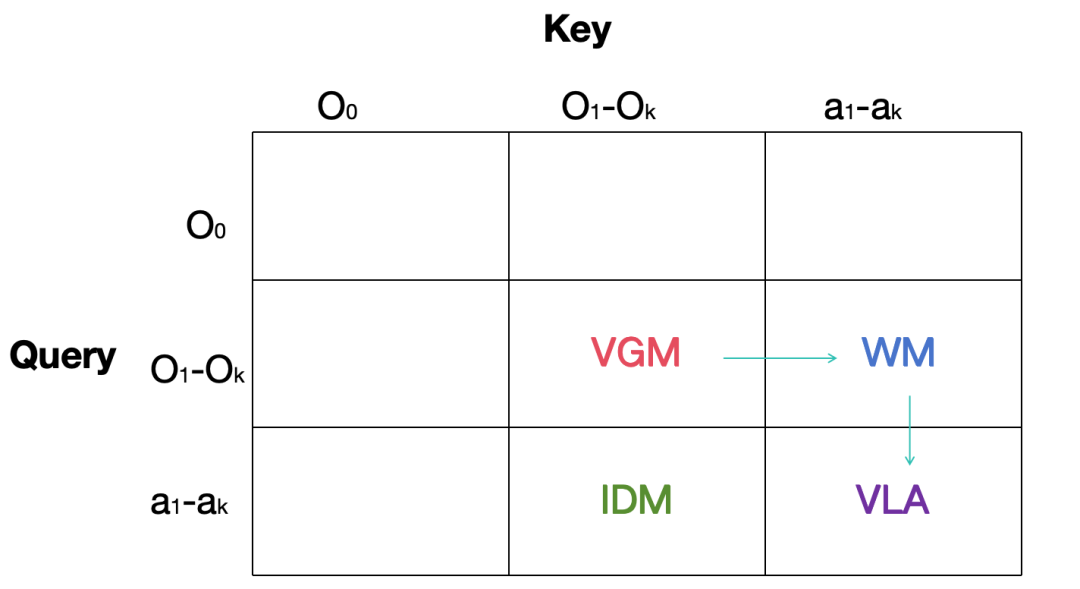
还有一种就是像我们这种,更偏向同时建模video和action,让两边的信息一起流动,直接去学一个联合的模型,联合建模->Policy。
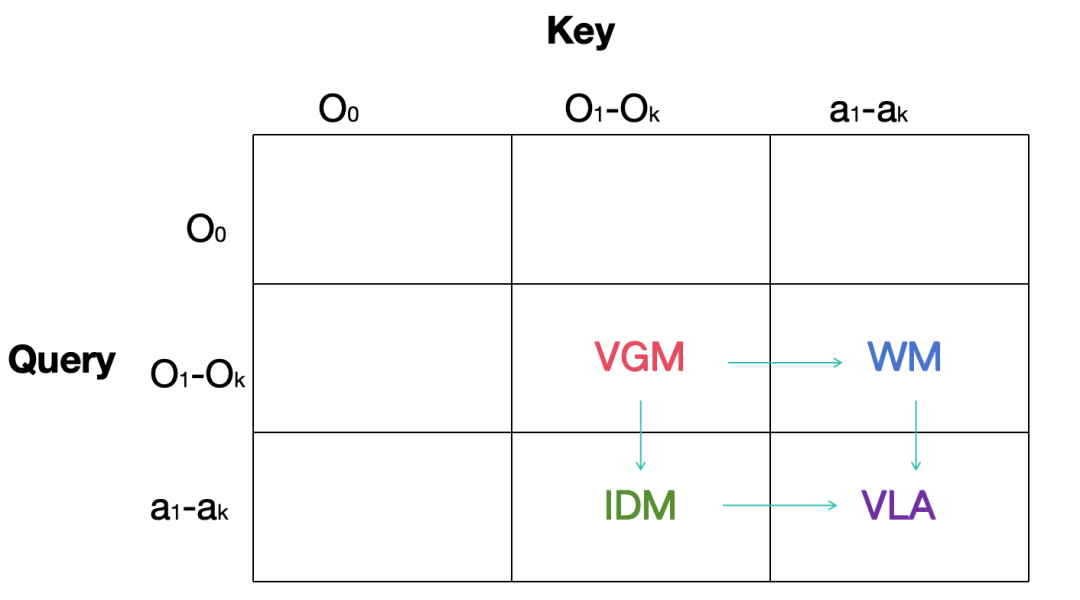
所以可以理解为,现在大家其实是在探索几种不同的路径:要么是从video走到action policy,要么是从world model走到action policy,要么是两边一起走。至于哪一条路径最终更可行,其实现在还没有定论,总之video generation是个很好的起点、巨人的肩膀,而action的policy是我们最终的目标。我们目前是在尝试“两边一起流”的这条路线。
5. Motus训练框架
我们最初的理想,其实是希望做一个“多expert”的统一模型。比如有负责视频生成的expert,有负责action的expert,还有负责理解的expert。然后把这些expert全部放在一起,通过joint attention去做交互。不管是不同模态之间的交互,还是不同认知功能之间的交互,比如理解和生成,都统一在一个框架里。
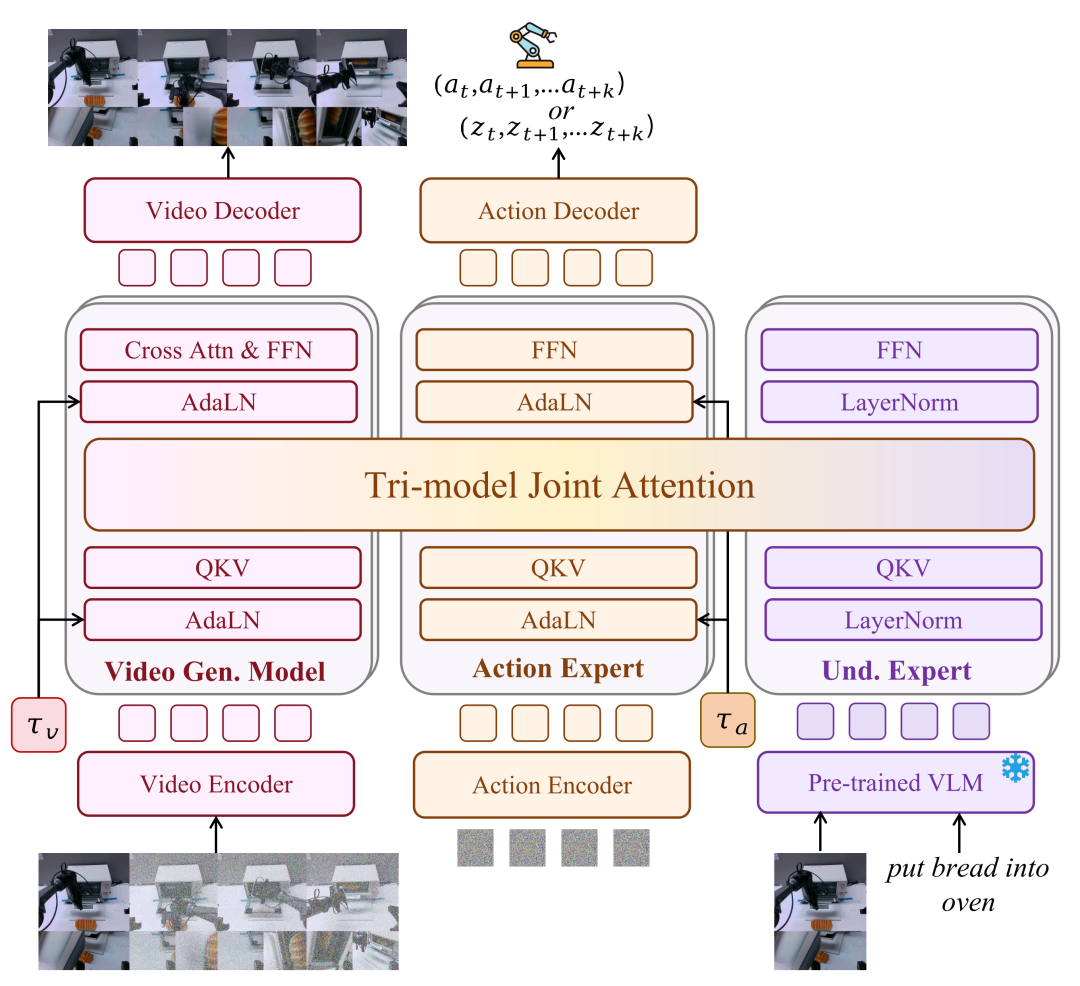
理想情况下,是希望一次训练,就能同时完成所有任务,比如IDM、world model、VLA、视频生成等等。而且不同来源的数据,也可以通过统一的训练策略一起喂进去。
但现实中直接这样做是有问题的。比如如果一开始就把所有模块一起训练,很容易把原本视频模型已经学到的能力“训坏”。所以我们在训练上做了很多工程上的trade-off。
比如第一阶段只训练视频生成;第二阶段把视频部分freeze住,再去训练其他模块,比如action和understanding这部分。
understanding这块,当时的实现其实是接了一个VLM的feature,比如我们用的是Qwen,它从图文里提取出来的feature本身就带有比较强的语义信息。然后把这些feature送进一个类似expert的模块,这个模块本身是一个多层transformer,并且在每一层都会和其他expert做joint attention,实现信息的融合。
所以简单可以理解为,这个understanding本质上就是一个VLM模块,做了一些适配之后接进来一起训练。当时因为模型结构对不上,所以用了这样一个相对工程化的方式,其实后面是可以做得更优雅的。
总结来说,理想是“全部一起训”,但现实是还是需要分阶段来做。
从更抽象一点的角度,我们当时的目标大概有三点:
第一是融合各类多模态异构数据,这是最核心的。因为本质上我们认为,数据的多样性和scale是智能的重要来源。
第二是尽量站在已有工作、已有基座模型先验的基础上,比如已有的视频生成模型、VLM,甚至其他人训练好的action模块,都可以拿来用,而不是全部从零开始。
第三是把不同类型的模型统一到一个框架里,比如VLA、world model、视频生成等。我们用的是一个类似unidiffuser的框架,通过控制各个expert的diffusion的timestep,可以在同一个模型里切换不同的推理模式。这一点和DreamZero他们的做法还是有一些区别的。
比如从外部评价来看,我们这个work算是比较早把这个方向scale起来、并且效果做得比较好的。所以很多人后来在强调的一个点,就是这种“unified”的思路——把多模态统一到一个框架里。
这个思路带来的好处,其实也就是刚才说的三点:第一是数据,可以吃进更多不同来源的数据;第二是可以利用已有的预训练基座模型,比如视频模型、VLM等等;第三是把不同的任务模式统一起来。
而且这个框架本身是可以不断扩展的,比如后面还可以加更多模态,比如音频、触觉等等,本质上就是不断往里面加专家模块,比如加一个DiT或者加transformer。
至于你刚才提到的unidiffuser,它是在最后这一层起作用的。我们训练的时候其实就是用unidiffuser的方式来训练的,本质上是一个DiT结构,通过diffusion的timestep来控制去噪过程,从而实现不同模式之间的统一和切换。
6. Motus训练数据
我们这边其实设计了一个“数据金字塔”,一共分成六层。最底层是互联网视频数据,然后往上是egocentric数据,再是模拟器数据、任务无关数据,再往上是多本体数据,最顶层是target本体的数据。
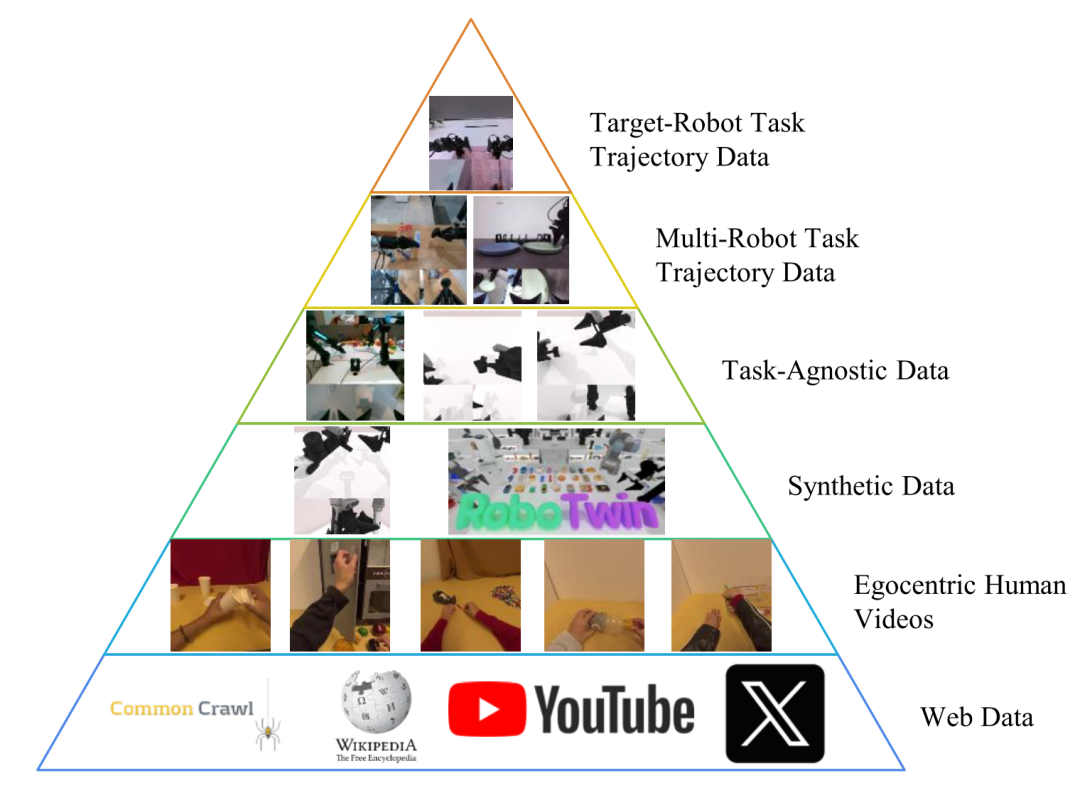
这六层数据,会在不同的训练阶段逐步注入到模型中。之所以可以这样做,是因为我们的模型是一个unified world model,可以兼容不同类型的数据。
比如,如果你只是训练IDM或者world model,其实只用任务无关数据就可以了;如果是做视频生成,那可以用底层这些视频数据;如果是做VLA,最终要输出action,那就主要用多本体和target本体的数据。
我们当时大概用了几百万条数据,规模在当时算是比较大的,大概有200万条左右。训练上用了二十台机器左右,每个stage大概训练一周,三个stage加起来大概两周多一点就可以完成。
训练过程大致分三个阶段。第一阶段主要是训练视频模型;第二阶段是做联合训练,把model的不同部分开始融合;第三阶段再做SFT。每个阶段用的数据其实是不一样的。
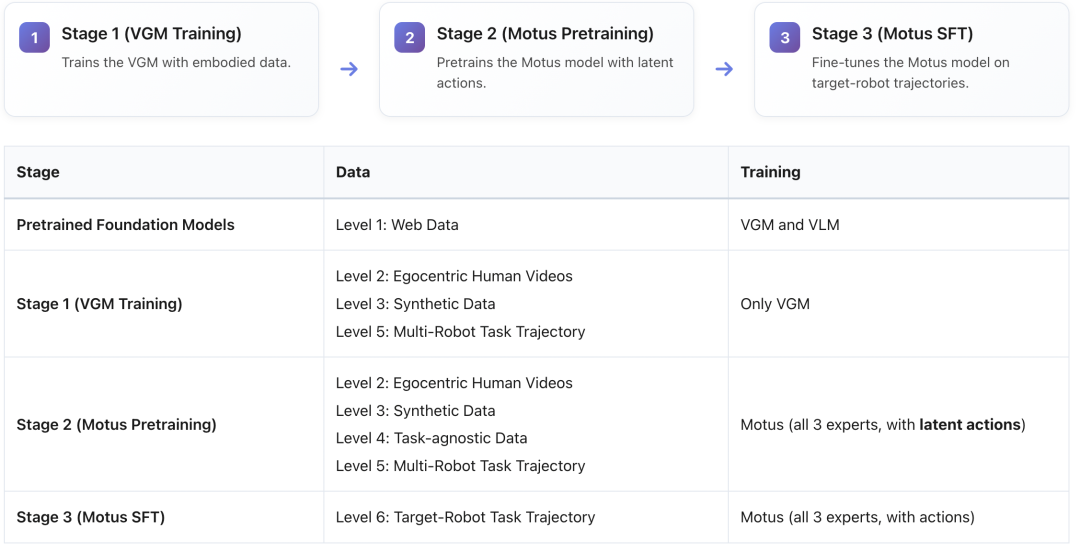
比如在最开始训练视频模型的时候,主要用视频数据,包括互联网视频、一些带任务的视频数据等。只要满足“从当前帧和条件去预测未来”的分布,这些数据都可以用。但像最顶层的target数据,一开始是不会用的,避免污染后续测试或微调阶段。
随着训练往后推进,才逐步引入更贴近任务的数据。
另外一开始我们其实是尝试过直接做融合训练,把所有模式和数据一起喂进去,但后来发现训练比较困难、不稳定。所以实际做法是分阶段训练,比如先训练一部分、freeze住,再逐步解锁其他模块,相当于是逐层搭起来。
整体来说,这个过程本质上是在不同数据、不同任务模式之间做一个逐步融合,而不是一开始就全部一起训练。
在这个过程中,我们引入了latent action。原因是很多数据本身是没有action label的,或者它的action信号是比较弱、噪声比较大的。另外,不同机器人本体之间的action space也不一样,这也会带来不一致的问题。
所以为了统一这一部分,同时也为了让action expert这一块有一个更好的初始化先验,我们引入了latent action,用一个统一的潜在表示去对齐这些不同来源的动作信息。
7. 不同层级数据量的需求
刚才提到这几个stage,其实每一层的数据量差别是非常大的。
最底层像YouTube这类互联网视频,规模可以到几十亿小时,量级是非常夸张的。再往上像egocentric数据,现在很多团队也在做,大家动不动就说今年要采一百万小时,这一层的数据规模也已经很大了,但和互联网视频相比还是差几个数量级。
再往上是模拟器数据,它可以通过自动生成来补充,但和真实数据之间还是有一定gap,所以更多是起到辅助作用。
然后是任务无关的数据,这一层其实很有意思。它的作用更多是帮助模型快速适应一个新的机器人本体。因为如果完全依赖人工去采集任务数据,成本会很高,而这一层可以用自动化方式来做,比如写一些脚本,让机器人在action space里随机探索,有点像婴儿一开始的“摸爬滚打”。
这种数据不需要一定成功,反而可以包含大量失败的尝试,比如乱碰、乱试,通过这些数据去覆盖更多可能的状态和动作。这类数据相对来说是比较容易获取的。
最上面就是目标本体、目标任务的数据,这一层通常是最精细、最“干净”的,需要人工去做真实操作采集。
从数据规模上来看,其实是逐层递减的。
最底层像互联网视频,是几十亿小时这个量级;再往上像egocentric数据,现在大概是在几百万小时级别;再到多本体数据,可能就只有几万小时。
比如现在一些团队,整体数据规模也就在这个数量级。而视频生成模型这边,听说已经用到了接近上亿小时的数据。
关于egocentric数据,一般是头部视角的数据。我们觉得这一点还是可以参考人的第一性原理:人主要是通过头部的视觉来完成大部分感知和决策的,而不是依赖手腕上的摄像头。
当然现实中很多数据采集方案还是会加腕部相机。原因也很直接:当前模型能力还不够,如果只用头部视角,很多细节会看不到,比如手部操作时会被遮挡,或者距离太远导致精度不够。
所以为了保证数据质量和可用性,很多系统会用腕部相机来补充视角,解决遮挡和细粒度信息不足的问题。
如果未来再引入力反馈或者触觉信息,这种对多视角的依赖可能会有所缓解。那这个问题往后怎么解决?比如引入触觉,比如在手上加传感器或者戴手套,这肯定是一个方向。
当然也不是说像腕部相机这种多视角方案一定要被完全替代。我觉得从第一性原理来看,理想状态下可能是不需要这么多相机的,但那可能是比较远期的事情,要等算力更强、模型更成熟、触觉等模态也足够完善之后,才有可能逐步减少这些辅助传感。
在短期内,其实更现实的方式是“兼容”。像我们这个框架,本身就是支持多模态输入的,你有多个相机、多个视角,甚至很多不同角度的数据,其实都可以接进来一起用。
从数据规模来看,现在这一层的发展其实很快。比如egocentric数据,今年很多团队都能做到几百万小时;再加上互联网视频这种几十亿小时的数据,这一层已经开始有规模优势了,对模型能力提升会非常明显。
但数据质量这块,其实要求也挺高的。比如标注粒度,是做到原子动作级别,还是任务级别;数据怎么切片;以及多样性,包括场景、物体、任务的多样性,这些都会影响最终效果。
这确实是一个不小的数据工程问题。但一旦把这一套流程跑通,比如数据组织方式、标注规范、整体SOP建立起来之后,后面就会顺很多,模型迭代速度也会很快。在实际操作上,今年有非常多的数据供应方在做ego数据的数采。
8. 后训练阶段
在fine-tune阶段,我们是把所有模式一起做联合训练的。也就是说,视频生成、IDM、world model、VLA这几种模式是被包含在了训练中。
在训练过程中,video和action之间是双向交互的,不只是单向依赖,而是相互condition、相互影响。到了推理阶段,我们可以做联合推理。也就是说,video和action是同时生成的,两者的diffusion timestep是同步去噪的
9. next token prediction到next sate prediction有什么本质的区别?
我觉得可以这样理解。之前做语言模型的时候,比如next token prediction,token是离散的,用cross entropy去做建模是很自然的,也比较直接。
但现在在机器人或者world model里,我们要建模的是action和视频,这些本质上都是连续的。如果强行离散化,会带来比较明显的信息损失,尤其是精度、大小关系上的损失。
所以更合理的方式还是用连续建模的方法,比如现在比较主流的就是用diffusion来建模单帧图像或者状态分布,这一块是没有太大问题的。
但一旦涉及到时序,本质上还是需要一个自回归结构。也就是说,在时间维度上还是要一步一步往前rollout。
所以现在比较主流的做法,其实可以理解为:在时间维度上是自回归(AR),而在每一个时间步或者每一帧内部,是用diffusion来建模连续分布。也就是AR+diffusion的组合。我觉得这一点现在基本已经算是一个共识了。
可以这样理解:自回归、时序和causal这三件事情,其实本质上是绑定在一起的。
因为当前的状态,一定是由过去的状态决定的,这里面天然就有因果关系。所以一旦你在建模时间序列,就基本一定会落到自回归这个框架上。
在world model里也是一样。现在主流的做法,其实就是把自回归和diffusion结合起来用。具体来说,在时间维度上,是自回归的。比如一帧一帧往后推,或者一个chunk一个chunk往后推,这本质上就是next prediction,是一个自回归过程。
而在每一个时间步内部,比如每一帧图像或者每一个state的生成,是用diffusion来做的。也就是说:时间上是AR,单步内部是diffusion。这一点现在基本已经是一个共识了,比如像Genie3这些工作,本质上也是类似的思路。
另外,从整体路线来看,现在大致可以分成三种不同的路径:
一种是像world action model,或者我们这种unified的方式,是video和action两边一起建模、一起流;
第二种是action-conditioned world model,从world model这一侧出发,先学dynamics,再往policy走;
第三种是类似unipi和vidar那种路线,从视频模型到IDM,通过video反推出action,得到policy。
所以可以理解为,现在大家是在探索三种不同的信息流:要么从两边一起建模,要么从world model往下流,要么从IDM往右流。
我们其实是从2024年就开始做这个方向了,但在当时,很多人其实是不太相信这个video-centric路线的。一直到最近这一两年,大家才逐渐开始意识到它的重要性。现在越来越多的人开始觉得,world action model有可能会逐步替代之前的VLA,成为一个新的范式。
10. 为什么中国这么多世界模型相关的创业公司?
视频模型这个领域,和之前语言模型的发展不太一样。现在看下来,视频模型这块,中国公司整体是比较强的。
比如像Sora出来之后,大家一开始期待很高,但实际效果和后续发展并没有完全拉开差距。反而从一些榜单或者实际产品来看,现在很多领先的模型基本都是中国团队在做。
尤其是把世界模型和具身智能结合起来这一块,国内的创业公司数量明显比美国要多。
至于为什么中国在视频模型这块更强,其实有很多原因。
一个微观的原因是中国积累的视频数据优势更大,美国视频数据存在合规性等问题。
另一个比较宏观的解释是“人变了”。做语言模型那一代的核心人员,大多是90年前后出生的;但现在做视频模型的主力,很多是95后,甚至00后。这一代人整体的教育背景、技术能力,相比之前是有明显提升的。
而且这种提升在中国更加明显。也就是说,中国的00后相对于90后的能力提升幅度,是要大于美国同一代人的。这背后是整体教育水平、技术环境等长期积累的结果。
当然,美国也有很多优秀的年轻人,包括很多中国背景的人才,但从整体数量和结构上来看,这种差异还是存在的。
所以从人才结构来看,这一波变化对中国是有利的。再叠加国内更活跃的创业环境,视频模型这个方向在商业化和落地上,确实开始有一些反超的趋势。
11. 和把Interactive World Simulator这类工作的思想对比
也可以从一个更宏观的角度来看这个问题。一种思路是先把一条路径做到极致,再逐步扩展;但从更抽象的角度来说,事物是普遍联系的。
具体到这里,video和action这两个模块,本质上是紧密耦合的,并不是完全独立的。它们之间是双向交互的关系。如果只建模一个方向,比如只从video到action,或者只从action到video,其实学到的信息是不完整的,对世界的认知也是片面的。
从概率建模的角度来看也是一样。如果你只建模一个条件分布,比如传统world model里的那种transition的条件分布,那么你只覆盖了整个系统的一部分。
但如果你去建模一个更完整的联合分布,同时覆盖边缘分布、条件分布等不同关系,那么理论上你能捕捉到的信息会更全面,也更容易覆盖一些长尾或者复杂情况。
所以本质上还是一个建模视角的问题:是选择只建模其中一部分关系,还是直接从一开始就用一个更统一的方式,把这些关系一起建模。
从更底层来看,其实所有AI模型本质上都是在做概率分布建模。不管是语言模型的next token prediction,还是现在的视频生成、world model,本质都是一样的。
还有一个比较有意思的点,是我们在data scaling上的观察。
比较常规的scaling曲线我们也做了,比如和π0.5做对比,这一块结果还比较直接,我们在data efficiency上大概有2.6倍到13倍的提升,这个算是比较明显的优势。
更有意思的是多任务这件事。大家通常会觉得像VLA这类方法,本质上是在拟合单个任务里的图像到action的映射,所以它的多任务泛化能力是有限的。
我们实际做了实验,从1个任务扩展到50个任务。结果发现,π0.5的平均成功率是随着任务数量增加反而下降的,说明不同任务之间是互相干扰的,并没有带来正向收益。
但我们这边是相反的,任务越多,平均成功率反而越高。这说明模型在学一种“world knowledge”,也就是任务之间共享的知识,而不是孤立地学每一个任务。
从具体数值上看,π0.5从最开始大概70%左右,随着任务增加会降到50%;而我们从类似水平一路提升,最终可以到接近90%的成功率。
也就是说,仅仅通过增加任务数量,就能把平均成功率从50%左右提升到90%,这个提升还是挺显著的。
这里的评测主要是policy层面的评测,是在一个类似模拟器的benchmark上完成的,大概是50个任务的设置。
Reference:
Motus:https://motus-robotics.github.io/motus
石麻好物推荐
看具身智能方向的投资人、创业者可能最近一段时间都异常忙碌。很多项目需要判断,很多人还要聊,出差忙碌一周之后,非常需要周末带着家人孩子,去海边或草地chill一下。推荐一个很解压,并且适合大人小孩一起玩的产品,5分钟上手,自己弹奏出喜欢的旋律和歌曲,适合一家人聚会或者户外休息的时候,一边演奏一边发呆。我自己是上手即上头,也推荐给石麻笔记的读者。