第一次听到Genesis是一年前,一直非常期待这个全新的机器人仿真平台的发布,直到今天,历时两年开发的Genesis终于公开发布。Genesis具有变革目前机器人仿真生态的潜力,应该是目前速度最快、仿真最准确、且支持非刚体的物理引擎。看了Demo视频,非常惊艳:
在Genesis发布前的一年,我也和这个工作的主要参与者淦创和周衔陆续交流,和他们请教了可微分物理引擎,RoboGen,以及Genesis相关的知识。关于可微分物理引擎和RoboGen之前的一期文章有非常详细的整理EP8对话淦创、周衔:RoboGen如何通过生成模型和可微分模拟大规模合成机器人示教数据(附可微分物理引擎论文综述)。Genesis是一个跨19个单位,汇集众多机器人学以及计算机图形学优秀华人学者的工作,非常不易,也给如今通用操作+仿真这条有点暗淡的路线上增添了一道曙光。
我第一次听到淦创老师和周衔博士提到这个工作的时如同发现新大陆,也基于此看了和可微分物理引擎相关工作,为了更好的理解Genesis对于整个机器人仿真生态的影响,强烈建议读者朋友也看下之前的两个系列,一个是关于可微分物理引擎以及可以理解为Genesis一个模块的RoboGenEP8对话淦创、周衔:RoboGen如何通过生成模型和可微分模拟大规模合成机器人示教数据(附可微分物理引擎论文综述),另一个是关于整个机器人模拟器生态聊一聊“Sim”(上)——一览机器人模拟器生态。
在目前的机器人操作领域,大家的共识集中在真机,仿真对于操作来说是冷板凳,今天Genesis的发布以及后续的关注可以让冷板凳重新热起来。关于Genesis,我结合目前官方公开的信息和之前对淦创和周衔的访谈内容整理了一篇科普,希望可以更多人关注到这个工作。
查看原文目录
以下为本文目录
👇
1. 什么是Genesis
2. Genesis与其他仿真平台对比的核心特点
可微分性
真实的渲染能力
机器人数据生成
仿真加速
3. 关于Genesis的拓展应用
4. Sim2Real Gap的问题
5. 关于仿真与可微分模拟
可微分物理引擎原理简介
6. 为什么开源
7. 一些想法
1. 什么是Genesis
Genesis 是一个用于通用机器人学习的生成式和可微分的物理引擎,提供了一个统一的模拟平台,支持各种材料的模拟,能够模拟广泛的机器人任务,同时完全支持可微分特性。Genesis作为下一代模拟基础设施,原生支持生成模拟:这一未来范式结合了生成式人工智能和基于物理的模拟,旨在为机器人代理解锁无限且多样化的数据,让它们能够在前所未有的各种环境中学习广泛的技能。
Genesis包括一个从零开始重建的通用物理引擎,能够模拟各种材料和物理现象;一个轻量级、超快速且易用的 Python 风格机器人仿真平台;一款强大且高效的照片级真实感渲染系统;以及一个生成数据引擎,可以将用户输入的自然语言描述转化为多种形式的数据,满足不同应用场景的需求。
Genesis 是整个大的框架或平台的统称,他的核心可以分成两个层次:首先是底层物理引擎,作为一个统一的框架,它能够模拟各种物理材料,以支持不同任务的仿真。高速的物理引擎使得我们能够更快地生成示范数据,从而提高整体的任务执行效率。
而上层则是一个生成式智能体的框架,包含多个独立开发的模块,我们将每一个环节都嵌入其中,包括复杂场景的生成、自动任务生成、策略学习等。此外,我们还支持人类角色的生成、机器人形态的生成等功能,目标是能够生成几乎所有需要的内容,构建一个全面的生成系统。我们将这些单独开发的模块进行整合,形成一个统一的平台,整个系统就叫做 Genesis。
每个模块都是独立开发的,比如机器人策略生成、场景生成和运动生成等。这些模块各自有一套方法,用于生成不同的数据类型。上层有一个统一调度的代理(agent),它会接收输入的请求,明确用户需要什么,并判断需要生成哪些内容。然后,代理会调度相应的生成模块来完成这些任务。生成的内容会相互耦合,代理还会检查生成的场景,进一步优化和提升最终效果。
比如,场景生成是通过扩散模型(diffusion model)来实现的,但扩散模型只是一个底层的网络结构,负责生成内容。在此基础上,我们会有一套方法来决定在什么样的空间中进行生成,并确保生成的内容能够转化为一个可交互的场景。对于运动生成,我们同样使用类似于Transformers的后台模型,这些模型每一个都是独立的网络,执行特定的任务。
目前,整个系统的上层尚未完全实现,如果完全实现,可能会大大推进整个机器人领域的突破。但在初期版本中,我们将这些模块统一整合,并且每个模块都会有很大的提升空间。
2. Genesis与其他仿真平台对比的核心特点
可微分性
现有的大多数物理引擎实际上都不支持可微分性,这导致它的解法有局限性,必须依赖于RL(Reinforcement Learning)或者一些motion planning来进行(关于物理引擎的科普可以参考聊一聊“Sim”(上)——一览机器人模拟器生态)。从使用的工具角度来看,这非常受限制。
但是做机器人的人可能都知道,做trajectory optimization是一个非常高效的方法,比RL更高效,但因为支持可微分性门槛非常高,所以这个领域的发展进展缓慢。但一旦这个问题得到解决,对于机器人学习来说,是一个革命性的进步。虽然目前RL是在仿真环境中机器人学习技能很常用的方法,但实际上,绝大多数做Robotics Learning的人都不认为RL是一个非常高效的学习skill的方法,但是又没有其他更好的方法。我们希望能够构建这样一个具有可微分性的高效系统,尽管这条路非常漫长,工程量非常大,但是我们认为这是一条必须走的道路。
真实的渲染能力
我们希望通过Genesis这整套系统,构建一个可以广泛适用刚体、软体,到各种类型的特殊物体的模拟器,同时还有好的渲染能力。这其实是回到了一个问题,就是怎么构建一个仿真环境,使得机器人能够在这个虚拟世界里学习并将所学应用到现实世界中。将虚拟的转化为真实的,这是我们的一个使命。因为机器人领域目前最大的问题就是缺乏数据,尽管很多人用遥操作采数据,但遥操作产生的数据很难scale,我更相信在模拟器里采数据,但模拟的问题是,写物理引擎的门槛比搭一个遥操作系统的门槛高很多。
很多机器人lab会倾向于遥操作,门槛更低,但这是不是最终的路径是一个问题。现在的simulation有点像八十年代的Deep Learning,很多人都觉得这个门槛很高,不是那么多人愿意投入精力。我们愿意沉下来做一些对这个领域有革命性意义的事情,尽管可能需要三五年甚至更长的时间。我们还是认为,通过模拟器和可微模拟来生成数据这条路线是真正能解决机器人领域数据从哪里来的手段。
机器人数据生成
在过去半年里,我们提出了一个更具广泛性的愿景。我们意识到,我们开发的这个Genesis平台不仅仅是一个物理引擎,它的最终目的是为了自动生成各种数据。这个平台的底层是一整套我们重新构建的引擎,上层则是一个生成式智能体的框架。
在生成方面,我们做了大量工作,包括场景生成、任务生成、奖励函数生成、以及多种如关节体和机器人物理形态的生成。我们现在正在构建一个统一的生成式智能体框架,用来调用这些模块。这意味着用户可以通过自然语言描述需求,平台将生成静态环境、物体,甚至动态的策略。
仿真加速
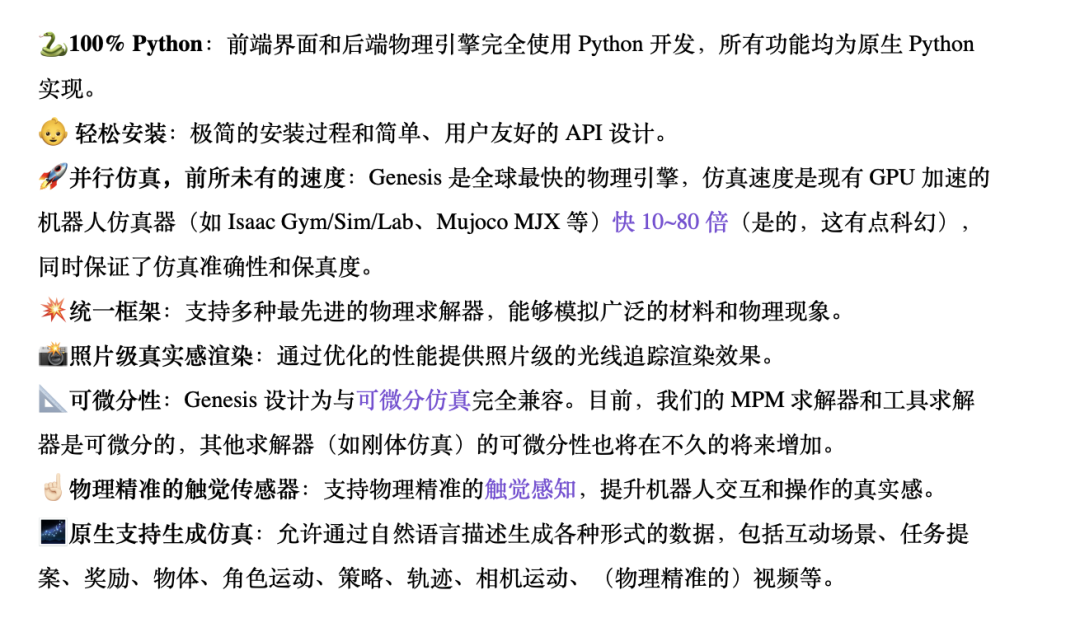
基于CPU的仿真引擎面临一个问题,就是它的样本效率较低,需要大量的数据才能产生有效的结果。而当NVIDIA推出了一套GPU加速方案后,能够在数千个环境中同时进行仿真,这虽然没有完全解决样本效率问题,但显著缓解了这个挑战。随着GPU加速技术的发展,最近各种高效技能的突破也随之而来。与上一代技术相比,NVIDIA的方案在速度上提高了20到30倍。
然而,我们最新版本的引擎Genesis比NVIDIA的系统快了20到50倍,这个提升不仅仅体现在速度上,我们还支持各种材料的仿真,并且在应用层面,我们对底层框架进行了全新的设计。目前,很多内部用户已经开始使用我们的系统,并且从旧有的方案迁移过来,发现我们的引擎在易用性上有了巨大的改进。
现有的一些仿真系统往往设计得非常复杂,功能的实现往往需要经过十几层函数调用和大量的代码,而我们的系统则大大简化了这一过程。基本上,一行代码就能实现一个功能,极大提升了开发效率和用户体验。Genesis项目主页对和其他仿真器对比的特点也有明确描述:
3. 关于Genesis的拓展应用
我们最近意识到,我们的这个平台不仅能用于解决机器人领域的问题,还能够惠及更多领域。虽然我们的初衷是为机器人学提供数据,但实际上,这些数据形式具有普遍性和通用性。机器人学所需的数据包括静态数据(如任务描述、环境特征及其交互方式)和动态数据(如学习到的策略与世界的动态交互)。借助物理引擎,通过前向模拟,由于物理的存在,可以生成各种动态数据。这些数据格式非常通用,能够适用于广泛的应用场景。
机器人策略和示范数据
(可参考RoboGen EP8对话淦创、周衔:RoboGen如何通过生成模型和可微分模拟大规模合成机器人示教数据(附可微分物理引擎论文综述))
我们不必将这个统一的系统局限于机器人领域。事实上,它可以应用于许多其他领域。一个容易理解的例子是视频生成。如果我们思考人类是如何拍摄视频的,通常不是像现有的基于扩散模型的学习方法那样逐帧生成并串联成视频,而是通过搭建一个三维场景,放入演员,由导演指导动作,设计摄影机的参数和轨迹,最终用摄影机捕捉这些场景。
生成 4D 动态与物理世界
如果我们拥有一个强大的物理引擎来模拟整个世界,再加上一套先进的渲染器(我们目前已经集成了一套),就可以在虚拟世界中重现这个过程。这不仅能用于机器人学,还可以用于视频生成等领域,极大地扩展了其应用范围。
因此,我们不仅能够生成机器人数据,还可以生成人类角色的动作、面部表情,以及各种参数,如光线强度、镜头焦距、轨迹设计和运动速度等。通过这种方式,我们能够生成各种类型的数据。如果利用这些数据进行拍摄,就可以生成物理精确的视频数据。
角色运动生成
语音音频、面部动画与情感生成
我个人认为,这是一种全新的视频生成范式。通过这种方法,不仅可以直接生成视频,还可以用生成的数据来反哺基于学习的模型。此外,这套系统可以通过自然语言描述来控制场景中的各种元素,例如在特定时间点让某个角色从某处进入,或者让摄像机以特定方式切入,从而确保生成的数据在非常细粒度的层面上对齐。
3D 和完全交互式场景生成
开放世界关节化物体生成
通过这种方法,语言描述与视频生成可以实现高度对齐,生成的成对数据质量远超当前较为粗糙的语言与视频对齐数据。这种高质量的数据有很多潜在的应用,远不止于当前的使用方式。虽然我们的初衷和主要目标是机器人学,但这种方法也能生成4D视频数据,特别是互动性场景数据,可以从不同角度渲染,生成多模态数据。我们认为,这些数据能够广泛应用于各个领域,带来更多的可能性。
4. Sim2Real Gap问题
关于“gap”这个问题,我想从几个层面来解释。首先,我觉得很多人忽视了一个关键点:这个问题并不是本质上属于科学的问题。例如,单靠仿真环境(sim)是无法解决机器人技术的挑战的。仿真环境和现实世界(real)之间必须有结合。每一方都有自己的问题:仿真的物理特性与现实世界不可能完全匹配,现实世界也面临着许多困难,比如缺乏可扩展性、数据模态不完整、难以收集闭环数据等。你只能获得正确的轨迹,而不能全面反映整个过程。因此,最终要解决机器人技术问题,必须将仿真与现实相结合。
至于两者的比例问题,我认为,最大的挑战在于,现实世界数据的可扩展性非常有限。尽管现实数据是准确的,但它不具备无限扩展的能力。相比之下,仿真可以通过计算资源无限制地扩展,尽管它不能做到与现实完全一致,但能够提供大量多样的数据,帮助我们进行更广泛的探索。
在未来,假如我们能拥有一个统一的基础模型(foundation model),仿真数据将成为提供丰富、广泛分布的训练数据的关键,帮助我们构建能够与物理世界交互的基本常识。之后,再用更精确的现实数据来填补空白,最终形成完整的闭环。
我想从几个角度来阐释这个问题。首先,关于real data和仿真数据之间的“gap”,最大的挑战是real data本身很难做到大规模收集和扩展。现实世界的数据可以提供90%以上的质量,但由于规模限制,难以覆盖所有场景。相比之下,仿真数据能够提供海量且多样的数据,虽然它可能和现实世界存在差异,但它能为模型提供丰富的训练数据。而real data更多的是起到“锦上添花”的作用,作为对仿真数据的补充和校正。
其次,如何缩小仿真数据与现实数据之间的差距是一个技术挑战。一个关键的方向是通过提高仿真环境的逼真度,使得它在物理、传感器数据等方面尽可能接近现实世界。例如,在我们的系统中,基于物理原理的触觉传感器是之前仿真环境中并不支持的,我们通过真实的反馈和优化算法,使得传感器的形变观测数据能够几乎与现实世界中的传感器匹配。这种逼真度的提升是我们不断追求的目标。
然而,我们不一定需要完全精准的匹配。我们可以通过引入足够的随机性,生成多样化的仿真世界。这就像模拟多个平行宇宙,每个宇宙的物理属性可能不同,但通过这些不同的物理世界数据,可以形成一个广泛且平滑的分布。在这个分布上,虽然每个数据点与现实世界的某个状态不完全一致,但它们为训练机器人提供了足够的多样性,使得机器人可以应对各种可能的情况。
另外,从哲学层面来看,仿真训练和现实部署的gap并不是一个真正的“问题”,因为仿真环境与现实世界本身就存在差异。就像如果我今天教你如何抓一支笔,在一个仿真环境中学到的技能,不一定能完全适应你换一支笔或进入一个新场景的情况。这个“gap”并不是来源于仿真与现实的直接对比,而是来自于不同环境的根本差异。
这个问题可以从两个层面来看。首先,当你从一个平行宇宙(比如仿真环境A)切换到另一个平行宇宙(比如现实世界B)时,肯定会有差距(gap)。但是,重要的是,我们要不断缩小这个gap,让它变得越来越小。第二个问题是:这个gap到底是不是问题?很多人没有深入思考这个问题的本质。事实上,在拥有通用智能体(或通用机器人)之后,即便从宇宙A转移到宇宙B,这个gap是否依然存在,还是可以被适应和克服?这是一个值得探讨的核心问题。
如果我们做一个思想实验,假设你是一个拥有强大运动技能的人,今天我把你放到月球上,或者把你带到一个完全不同的物理环境中,虽然这些环境的物理特性与现实世界有很大不同,但你依然能凭借你对世界的基本理解进行快速适应。这就是人类基于物理世界的常识做出的快速调整。
如果我们有一个类似人类的AI,具备强大的物理理解能力,我们有理由相信,它可以通过少量的现实数据微调,在现实世界中快速掌握生存规律。现在我们没有做到这一点,是因为当前的机器人策略通常是针对非常特定的任务而设计的,缺乏通用的物理理解。随着仿真数据的不断丰富和基础模型的发展,未来的通用物理理解模型(generalist agent)将有可能在现实世界中快速适应并有效执行任务。
至于为什么当前存在这个gap,可以从两个技术层面解释。第一,当前的物理引擎能力有限,很多复杂的物理现象无法被准确模拟。大多数物理引擎(如NVIDIA的物理引擎)只能模拟简单的钢铁等物质,对于更复杂的物理现象(如柔性材料、液体动力学等)的支持相对薄弱。解决这个问题的关键在于提升物理引擎的能力,这也是我们当前努力解决的方向。第二,大多数仿真平台例如SAPIEN等都被英伟达这套闭源的物理引擎bottleneck住,而这些引擎的物理参数无法进行定制和控制。
例如,假设我们想要模拟一个钢铁球的弹跳,调整球的属性来控制其弹性或能量耗散。现有的物理引擎无法让我们精确调节这些参数,导致仿真效果与现实有较大偏差。这种缺乏灵活性的控制是目前的一个限制。然而,我们的解决方案是:通过开发一个开放、可调的物理引擎,让每个人都能够贡献和修改物理参数。通过这种方式,我们可以根据真实观察到的数据,调整和优化物理模型,使仿真环境能够更加接近现实。随着物理引擎的可控性提升,这种gap也会进一步缩小。
总结来说,虽然目前仿真与现实之间存在gap,但随着物理引擎的改进、开放性和可调性增加,我们能够缩小这个gap,使得通用智能体在仿真环境和现实世界之间的转移变得更加顺畅。
5. 关于仿真与可微分模拟
仿真(simulation,也可成为模拟)是图形学的一个重要分支,图形学可以分为渲染和仿真两大块。作为从事机器人研究的人,我能感受到,机器人领域的从业者往往对仿真技术存在一定的恐惧感。原因在于,这涉及到大量底层的数学和图形学知识。很多人不熟悉这些底层原理,导致他们在使用现有工具时遇到困难,最终停滞不前。其实,问题的核心在于缺乏一个能有效连接图形学和机器人领域的桥梁。因此,我们的目标是将这两个领域的专家结合起来,促使他们相互沟通,发现彼此的需求,并通过不断迭代和完善,共同发展这一生态系统。
但不得不承认的是,构建一套机器人仿真引擎非常难,并且知道如何构建这套系统的人是小众群体。首先,模拟本身就是一个小众领域,图形学已经是一个相对小众的领域,而模拟又是图形学的一个子领域,而在模拟中,可微模拟又是其中的一个更小的子领域。因此,整个可微模拟的研究和应用范围本身就非常有限。要在这个领域取得进展,往往需要大量底层算法上的创新,这也是机器人领域的从业者可能缺乏的专门知识。
此外,当前在复杂材料交互方面的模拟研究(如流体、软体等)一直是一个相对较新的方向。过去几年,模拟领域的主流更多集中在与刚体的交互上。这种历史的局限性也进一步加剧了对新型复杂模拟技术的接受难度。
另外,可微模拟作为一个研究领域,其核心挑战之一是如何从模拟中获取有效的梯度信息,并利用这些信息加速策略优化。这个问题仍处于探索阶段,目前尚未有一个成熟的研究范式或公认的结论。因此,研究人员在这一方向上还在摸索,整个领域的发展仍面临许多不确定性。
推动仿真(尤其是底层数学与算法的开发)需要很多突破,这才是一个真正具有挑战性的任务。我们每天都在为此思考新的算法,但这个过程充满了不确定性。在我们实现之前,根本无法确定这些算法是否可行。
可微分物理引擎原理简介
什么是simulation,比如现在有一个物体的状态(State),你对物体进行一个操作,机器人有了一个动作(Action),通过动作,物体的状态发生变化,从一个状态到另一个状态,整个过程是forward(前向)的。这种给定状态,机器人做动作,再预测下一步会发生什么的过程叫physical dynamic或者forward simulation。这个过程中,对机器人task到最终的goal的距离可以算一个reward,和RL有点像,这一步做完之后离goal更近了还是更远了,算出来一个reward。如果模拟器不可微,只能做search,这个非常低效,你可能需要几千万上亿的数据去找到哪个trajectory是最好的。所以Forward simulation本质是search的问题。
可微分物理模拟的好处是,有梯度信息,可以用梯度下降的方式找到最优解。从state到action到state,每一步都有导数,有导数之后可以用梯度下降的方法求解,让reward的数值最大。对于不可微分的物理引擎只能用search或者近似的梯度,可微分物理模拟是每一步都用数学公式可以精确的算出每一步的梯度,用这个梯度来做优化,结果肯定是更好和更快地。
解释:可微分物理引擎(Differentiable Physics Engine)是一种用于模拟物理系统的工具,其主要特点是可以对其输入参数进行微分。传统的物理引擎通常是基于数学模型和物理定律来模拟物体之间的相互作用和运动规律。然而,这些传统的物理引擎在计算梯度方面通常是不可微的,这使得它们难以直接应用于需要梯度信息的机器学习任务中。可微分物理引擎通过引入可微分的物理模型或数值计算技术,使得其在输入参数上具有可微分性。
我们的系统最早是和胡渊明的Taichi合作,可微分模拟在计算图形学(computational graphics)是一个很大的分支,但他们的侧重是用可微分的方式让模拟做的更准更快。在机器人领域,我们考虑的是怎么让skill learning更高效,用梯度的方式去做robot skill。
比如我们21年和胡渊明合作的PlastineLab,对于PPO或者RL他们的学习效率非常低,而我们的方法学习效率是RL几个数量级的提升,这也是我们为什么后面坚定的去创建这套可微模拟系统来做机器人skill learning。当我们有了这种很高效机器人skill learning的方法之后,可以在模拟器里收集大量的robot demonstration的数据,再去学一些real world skill transfer。所以我们整体的逻辑是通过构建强大的可微分物理模拟系统,来生成和收集大量机器人操作的数据,有了数据之后,可以训练机器人操作Skill Learning的基础模型,然后再学习一个adaptive policy,将这个模型transfer到真实世界。
很多task,RL训练不出来,很痛苦,policy训练了很久也找不到,而用我们的可微引擎train个半小时就可以找到policy。所以可微分物理引擎是比RL更有效的寻找policy learning skill的方式。但现在有个问题,现在大多数的simulation不支持可微,这也是现在整个robotics领域的痛点。如果不支持可微,你就没有其他解法,你就只能做RL或motion planning,没有trajectory optimization的选择。可微物理引擎门槛很高,全世界做机器人可微模拟的人没多少,会写可微物理引擎的不超过100人。这也是我们做Genesis的初衷,把会写可微分物理引擎的华人都聚到一起去做这个事情。可微物理引擎对数学和编程的门槛很高,即使在计算机图形学,可微模拟也是个出力不讨好的事情。
目前机器人模拟器的两大难题,一个是怎么更快的在simulation里学会skill,可微模拟可以迅速地找到对于一些task比较好的policy。另一个难题是怎么减少sim2real gap,可微模拟整个概念也是将Sim和real更好的结合,它可以enable更好的sim2real alignment,这也是可微模拟和Pybullet这类物理引擎不同的一点。对于Pybullet这种物理引擎,解决Sim2Real gap的办法就是domain randomization,但这个方法非常不可控。可微分模拟还有一个好处是,它可以用真实数据校正模拟数据,比如有一个现实世界的视频,可以利用现实世界的视频来校正这个可微模拟器。
我们整个一套东西是希望给机器人构建世界模型。人为什么学skill快,人是有一个world model的。Robot Intelligence从哪里来,我一直认为这个intelligence应该从world model来,这就需要给robot建立一个state-action-state的能力,包括需要给他建立一个非常有效的寻找action sequence做planning的能力。这个能力从哪来来,我一直比较坚持的认为需要建立一个强大的可微分物理引擎来作为robot的大脑,来支持他学习各种skill。当然这个world model也可以从现实世界里学习,但共同的目的是怎么给robot构建一个大脑,不一定是某个skill,而是更广泛的对物理世界的理解,你只有真正的有了这么一个大脑,真正的有个对物理世界的建模,你才能真正的generalize。
关于可微分仿真的论文综述可以参考EP8对话淦创、周衔:RoboGen如何通过生成模型和可微分模拟大规模合成机器人示教数据(附可微分物理引擎论文综述)。
6. 为什么开源
第一代版本的重点是完全开源底层物理引擎。这个引擎已经远远领先于当前市面上所有的物理引擎,在各个方面都具备显著的优势。我们刚发布的这个版本,已经在性能、可扩展性和灵活性上做出了许多突破。而在未来的版本中,我们计划继续优化和扩展,不仅提升物理引擎的能力,还将加强与其他模块的结合和支持更多复杂的应用场景。
我的动机之一是这样的——如果你看看计算机图形学领域,你会发现,过去他们取得了很多令人瞩目的成就。每天都有新的论文发布,今天可能是“我可以模拟这个场景了”,明天是“我可以模拟那个现象了”。比如,他们可能能够模拟面包在烤箱中膨胀的过程,或者牛排被切开的效果,甚至是红烧肉切开的纤维变化。然而,这个领域的问题在于,它相对封闭。虽然他们注重制作炫酷的视觉演示,但许多研究成果仅停留在论文和展示层面,代码很少开源,且开源的代码通常难以理解,使用起来也不方便。因此,虽然技术不断进步,但它们并没有得到广泛的应用。我认为需要做出一个大的努力,将这些令人印象深刻的技术整合到一个易于使用的框架中,让更多的人受益。
在我们的长远规划中,我们将不断向框架中添加最新的技术和复杂的物理效果,最终实现我们重建物理世界的目标。虽然在早期阶段,系统还无法达到模拟像红烧肉被切开这样的高度,但它已经能够做出一些相对完整的模拟,例如软体物质、流体、衣物等多种物理效果。
7. 一些想法
关注Genesis有一年多的时间,我作为石麻笔记的小编,可能是robot learning学术圈以外最关注这个工作进展和发布的人之一。所以今天Genesis发布,我真的是非常激动!从最初听到Genesis的概念,就会觉得这真的可能会颠覆目前机器人学习的范式。
虽然当今端到端模仿学习和真机是非常有共识且主流的一个路线,但不可否认的是,在这个路线上,依然有着诸多不知道的答案的问题,比如多少的真机数据量才可以达到scaling law,比如这么大量的真机数据应该如何获得?我们是否可以有另外一条完全颠覆式的路线,比如仿真环境的变革?Genesis也许不是答案,但至少他有机会成为答案。
前几天在播客:RL+Control 如何将机器人可靠性逼进99.9x%访谈中,罗剑岚博士提到Moravec's Paradox(莫拉维克悖论),人工智能系统在执行任务时的反常现象:对于人类而言简单的任务,比如感知和运动控制,对机器却极其困难;而复杂的任务,比如逻辑推理和数学计算,对机器来说却相对容易。莫拉维克指出,这种悖论源于人类智能的非对称性:“低级”技能(如感知和运动控制)基于数百万年的进化,深深嵌入了生物的感知运动系统中;而“高级”技能(如逻辑和数学)发展时间相对较短。
人类或者动物对物理世界的物理直觉是几万亿年(如果追溯到恐龙时代)进化结果,这种物理直觉已经成为动物本能。对机器人这种硅基“生”物来说,现实环境数百万、千万或者上亿条真机数据足以构建它对物理世界的本能吗?仅仅这些数据就可以让他拥有人类这种生物体通过亿万年的进化获得的对于世界模型的物理直觉吗?
如果是的话,那对真正的碳基生物来说也太不公平了。在我看来,硅基生命的物理直觉,应该通过一种非常强大且高效的运算机制,以人类无法理解的模式构建的吧!Genesis至少具备了这套运算机制的基本素质,接下来的是看是否有更多的人愿意投入时间和精力到这条路线上来,一起突破。
References:
Genesis
https://genesis-embodied-ai.github.io/
https://genesis-world.readthedocs.io/en/latest/
zhouxian主页
Ganchuang主页
https://people.csail.mit.edu/ganchuang/