最近几个月石麻笔记更新的比较慢,很多读者催更,2025年还剩最后两个月,小编下班后会好好熬夜写稿[加油]。接着Human Data系列第一期Human Data EP01-MoCap:TWIST,我们继续探索和人体动捕数据以及人形机器人全身运控相关的一篇工作,GMT: General Motion Tracking for Humanoid Whole-Body Control。GMT是一个通用的运动追踪框架,通过利用大规模、非结构化的人体运动数据训练单一策略,使人形机器人实现高保真运动追踪。
GMT这篇工作的一作是陈子玄和季马泽宇,我们这期采访对象是陈子玄博士,他目前在UCSD王小龙老师组里读博,本科毕业于复旦大学。他同时也是TWIST(Human Data EP01-MoCap:TWIST)的共同一作。采访稿有很多很有启发的细节,一起来了解下这篇工作。
查看原文目录
以下为本文目录
👇
1. GMT的核心思想
2. GMT的方法介绍
3. 怎么理解Motion Tracking
4. 关于动捕数据集
5. 动捕数据 vs 视频数据
6. GMT vs DeepMimic
7. 关于MOE
8. 全身运控不同方法的对比
9. Retarget的方法
1. GMT的核心思想
GMT 的一个核心问题在于,我们希望能够实现真正的 general:也就是说,用一个 policy 就能产生各种各样的动作,并且在机器人上执行。
现在很多公司他们的 demo 里展示了一些很炫酷的动作,比如跳舞、翻跟斗、跳跃等等。但他们通常的做法是:针对一段 motion,就训练一个对应的 policy。这样虽然能做出单个动作,但如果我们想要构建一个通用的控制器,这种方式就很难扩展。
而 GMT 的思路是:如果我们用一个 policy,就能覆盖和理解各种 motion,那么在机器人执行任务时,我们既可以生成任意的动作序列,这个 policy 也能对其进行跟踪,从而让机器人表现出不同的行为。这样的话,它就能够作为一个基础性的控制器,用来完成各种各样的任务。
2. GMT的方法介绍
GMT的方法是基于Jason Peng在 2018 年提出的DeepMimic,本质上还是在用强化学习,我们定义一些 reward,让它去完成 tracking。GMT 主要是解决了两类问题,一类是 data 带来的问题,另一类是 model 的 architecture 带来的问题。
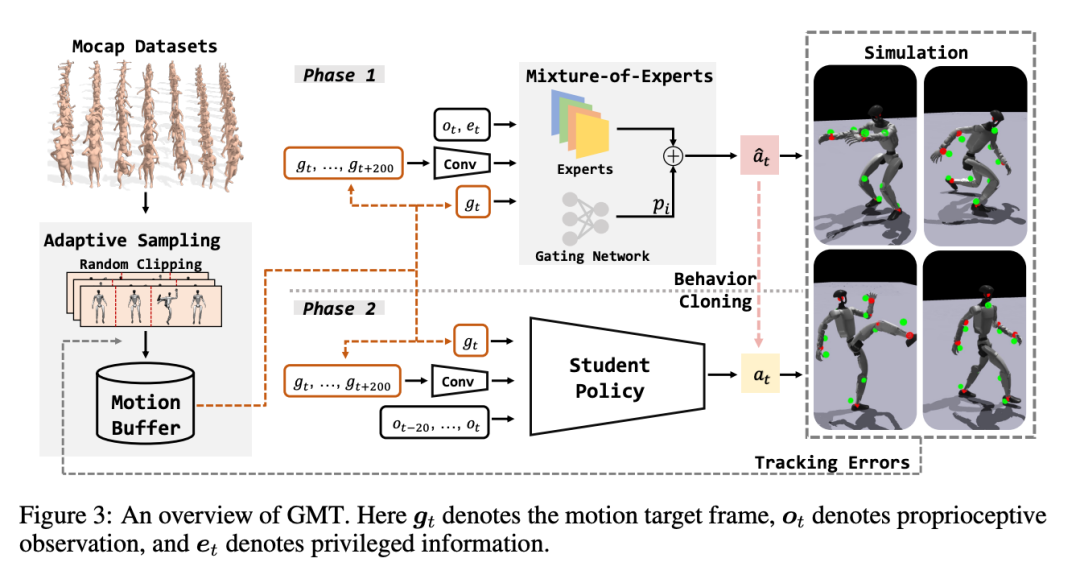
关于数据的问题,第一个是训练数据的质量。因为训练这样一个控制器需要大量数据,而这些数据一般都来自像AMASS和LAFAN这样的大型人类动作数据集(MoCap data)。但这些数据集会有很多噪音,比如有些数据本身就不够完善,或者有些特别高动态的动作需要非常大的力量,机器人根本没办法完成。我们需要把这些数据过滤掉,所以做了 data curation,把那些过于动态的动作和低质量的数据去掉,最后得到一个质量更高的训练数据集,这样能够提升 policy 的表现。
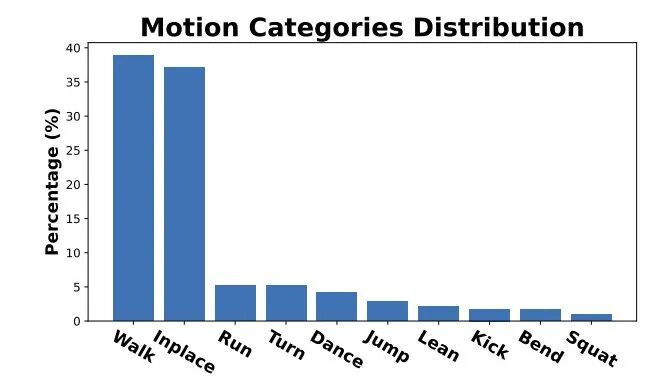
第二个是 sampling 的问题。动作数据里面有的比较简单,比如走路,有的则比较复杂,比如跳舞、跳跃这些非周期性的运动。像在 AMASS 或 LAFAN 这样的数据集里,60-70% 都是走路,剩下的 30% 才是比较有挑战性的动作。但我们希望 policy 既能学到简单的动作,也能学到复杂的动作,所以需要做 adaptive sampling。具体来说,就是给不同的动作分配一个概率,复杂的动作多 sample 一些,简单的动作少 sample 一些,这样能在训练中达到平衡。我觉得这是一个比较重要的点。
再说模型结构的问题,之前很多工作,尤其在 locomotion 上,都是用很简单的 MLP 网络。但我们需要一个 policy 去 handle 各种各样的 motion,而且这些 motion 时间跨度很长,MLP 很多时候就不够用了。所以我们换成了一个 MoE 的架构,有很多个 expert,这个设计是借鉴了语言模型里的思路。我们发现 MoE 显著提升了模型的表示能力,效果也更好。
另外在 motion 的输入上,我们也做了一些设计。人类在做动作时,会提前感知未来要做什么,比如提前几秒钟知道自己接下来要完成什么动作,然后身体会做相应调整。所以我们参考这个思路,不是只输入一帧,而是把未来两秒的 motion target 压缩成一个向量,一起输入到模型里。但这样会有一个问题,就是压缩会带来信息丢失,tracking 的准确度可能会下降。为了解决这个问题,我们除了输入压缩后的未来向量,还显式输入了最近的一帧,把这两部分结合起来。这样模型既能感知到最近一帧这个最重要的 tracking target,也能知道未来的趋势,最终训练出来的 policy 效果会更好。所以 GMT 主要就是在数据和模型这两个方面做了改进。
3. 怎么理解Motion Tracking
Motion Tracking可以简单理解为:我们先给机器人一段人类的运动数据,这类数据通常是基于运动学的(kinematics-based)。Motion tracking 的作用就是把这些人类的运动在机器人上复现出来。它既可以是在线(online)的,比如实时跟踪并复现人的动作,类似TWIST这种工作;也可以是离线(offline)的,即先输入一段数据,再让机器人完整地把这段动作复现出来。
离线的Motion Trakcing是我们先给机器人一段录制好的动作,把整段数据一次性输入进去。它和 online 的最大区别在于:online tracking 是实时采集数据的,所以你只能拿到未来的一帧,再把这一帧输入给机器人;而 offline 的情况下,因为整段数据已经提前给到机器人,它就可以获取任意未来时刻的动作信息。比如说,我们可以把未来的一个时间窗口作为输入,这样机器人能利用更长的窗口,对整段数据有更全面的理解。
4. 关于动捕数据集
AMASS这个数据集虽然很大,大概有几十个小时的长度,但里面有很多质量不高的片段,比如脚部穿模、悬空等问题。像 AMASS 这种数据,我们可能需要优化一些 motion 与地面的接触之类的细节,这样能提升整体效果。但我觉得对 GMT 来说,更重要的是要把那些机器人根本无法完成的动作筛选出去,只在机器人能够执行的动作上进行训练。这样带来的效果提升会更明显。
LAFAN这个数据集整体来说动作比较 dynamic,有些动作难度较高,但总体上都是可执行的。每个 motion 的质量也都比较高,他们在预处理阶段手工调整了一些数据,所以整体质量还是挺不错的。
现在开源的数据集中,最大的就是AMASS。我们之所以选择AMASS,是因为它覆盖了各种各样的技能,但在质量上可能有一些欠缺。其实现在的一个概念是,我们想做一个行为层面的 foundation model,也就是说,希望它能执行所有各种各样的动作,包括通过生成模型生成的动作,然后在模型里进行 tracking。为了做到这一点,训练时可能需要非常大的数据集,尽量把各种动作都覆盖。如果我们能有一个高质量、由人类采集的新数据集,我觉得对整体效果会有很大帮助。
5. 动捕数据 vs 视频数据
其实我现在并不是特别偏向单纯的视频数据。因为如果只是视频数据,我们还需要用 video-to-motion 的模型把视频转化为可用的 motion 数据,而机器人只能直接使用 motion 数据。这个转换过程比较困难,而且对拍摄角度和其他条件要求很高。拍摄角度对视频数据的要求也比较高,角度越好,转化出来的效果可能越好。但从精度上来看,视频数据肯定不如 motion capture(动捕)数据。我觉得如果最终要用于机器人,还是使用动捕数据更好,因为它可以直接转成机器人可用的数据,质量也更高。
6. GMT vs DeepMimic
DeepMimic我觉得它最重要的一点在于,它把 motion tracking 这个问题比较正式地 formalize 成了一个 reinforcement learning 的问题。在每一步中,它会给出一个 motion target,然后计算机器人当前状态与目标动作的差异,从而得到一个 reward,并把这个 reward 用来定义整个强化学习任务。我觉得这是DeepMimic最大的贡献。
现在几乎所有的模型,包括 PHC、MaskedMimic、 ASAP,以及最近的 GMT或TWSIT,其实都是在使用 DeepMimic 提出的这个范式,然后在此基础上进行创新。
DeepMimic另外一个创新点是 RSI(Random State Initialization),在训练时,如果机器人表演动作时摔倒,我们不是每次都从头开始,而是从 motion 中任意截取一帧作为初始状态。这样,机器人可以在不同阶段学习动作,而不必先学完开头才能学后面。这个方法显著提升了整个训练效果。我觉得这就是 DeepMimic 影响最大的创新点之一。
7. 关于MOE
我们用的这个 MOE 实际上是 soft MOE。我们的做法是直接把所有的数据放在一起训练,而不是像LLM里传统 MOE 那样。传统的 MOE,比如在语言模型里,通常是先训练很多不同的 expert,每个 expert 专门负责某种 skill,然后再组合在一起。
但 soft MOE 的思路不一样:它在原有的基础上多了一个 gating network。你可以这样理解:假设我们现在有六个 expert,我们事先并不知道每个 expert 在负责什么。gating network 会输出六个概率,对应这六个 expert 的权重。然后我们把六个 expert 的输出按照这些概率加权求和,得到最后的 action。
这种方式的好处在于,我们不需要人为去规划或者预先定义 skill,而是让模型自己去学,自己去发现、分类并组合不同的 skill,最终完成 motion。
这里面有一个比较直观的启发,就是来自于 ExBody2。他们的一个发现是:如果把同一类 motion 放在一起训练,比如说把走路的动作都放在一类,把跳舞、踢腿这些放在另一类,那么训出来的 policy 会表现得更好。这个发现提醒我们,不同的动作类别,其实需要不同的“expert”去学习,才能真正精通不同的 skill。
基于这个想法,我们最后选择了 soft MOE 这种方式。它的好处就是可以保持端到端的训练流程,同时又能让模型内部的不同 expert 自动去分工,分别擅长不同的 skill,最后再组合在一起完成复杂的 motion。
Soft MOE 的一个特点就是:即便它在某个时刻更侧重于一个技能,也不会让其他 expert 的输出完全变成零。比如说,有的 expert 可能更擅长踢腿,有的更擅长走路。当机器人在踢腿时,擅长踢腿的 expert 权重就会比较高,但其他 expert 依然会有一定的贡献。我们在实验中加上 MOE 之后,可以很直观地看到提升,MOE 这种架构对于一些比较简单的 motion,其实提升并不大;但在比较难的 motion 上,它能够明显提升整个模型的 performance。
8. 全身运控不同方法的对比
我觉得首先可以说一下 PHC 或者 MaskedMimic 这些工作的方向,他们是在 graphics 上面。我觉得 graphics 和 robotics 还是有本质上的区别,因为 graphics 很依赖全局信息,包括他们用的仿真条件也更简单,没有各种各样的 domain randomization。这就导致他们会比较依赖 global 的一些信息,还有一些 privilege information,比如说拿到机器人的线速度。
在 graphics 里面,选一个 motion tracking 的控制器其实更简单,难度更低。但 graphics 的这些条件和假设不能直接用在机器人上。我觉得我们和 graphics 的工作是分开的,graphics 更多是验证算法可行性,但最终要真正部署到 robot 上,还需要更多工程和设计。
至于 robot 上的一些工作,比如说 HumanPlus 和 OmniH2O,他们用了整个数据集去训练。在 paper 里面 HumanPlus 和 OmniH2O都写了用了完整数据集。但他们用的机器人是 Unitree H1,那时候是比较早期的工作。H1 的体型和人的差异较大,所以在 motion retarget 后会有比较大的质量差异。再加上 H1 的构型,和人的构型差异也比较大,他们更多是 focus 在 teleoperation 上,并没有去做比较兼容的 motion tracking controller,这也是我们和他们工作的差异。
像ExBody,其实它是上半身进行 Tracking,下半身依赖 locomotion policy,它也不是完整的 whole body tracking。虽然 policy 控制全身,但并没有真正做 whole body tracking。EXBody2 是第一篇能够真正做到 whole body 各种 motion,但用的数据比较小。他们会针对不同类别的 motion 训练不同 policy,最终达到较好效果,但没有用一个 policy 去覆盖所有 motion。ASAP 展现了各种 extreme skill,比如跳跃或者翻腾,但每一个 motion 都对应一个 policy,缺少 scale-up 的能力。他们的数据集是自己手动筛选的,从Internet data和开源数据集里面挑选。
相比之下,GMT 核心在于一个 general policy 可以对应追踪很多动作。很多动作在数据上是经过筛选的,架构上用 MOE,这使得全身运控的进展很快。现在全身运动的突破在于能够做各种 dynamic motion,以前我们可能没想过机器人能做的动作,比如翻跟斗,或从地上跌倒后站起来。近期很多工作做得非常好,这些突破得益于 robot 的体型较小,可以复现更多动作,促进学术发展。但功能性方面还没有充分探索,单纯展现运动能力不能直接转化为功能。要让机器人做家务或工厂任务,需要一个 general policy,支持多种 skill。
9. Retarget的方法
GMT的Retarget 主要是基于 PHC 这个工作提出的Retarget方法。我们主要关注机器人动作中的关键点,比如手脚,然后让机器人的相应部分尽量去 match 这些关键点,通过解一个优化问题,最终把人的 motion 映射到机器人上。
一个比较重要的点是如何去 match 一个 skill。人的 skill 会受身高、体重等因素影响,不同的人在动作表现上会有差异。我们会对不同的关节设置系数,把人的 skill 转化到机器人上,这是比较关键的一点。
另外,retarget 的效果好坏还取决于机器人的构型。各种开源数据或者动捕数据都是基于人的,如果机器人越像人,理论上 retarget 的效果就越好。我们实际试下来也明显发现,G1上的retarget 效果远好于 H1,因为G1更像人。
References:
https://gmt-humanoid.github.io/