欢迎来到Human Data第三期,这一期继续介绍一篇基于人体动捕数据来进行机器人全身运控的工作Exbody2。Exbody2的一作是季马泽宇和Xuanbin Peng,我们这次访谈对象是季马泽宇,他在UCSD获得硕士学位,由王小龙老师指导,他本科毕业于同济大学,也是我们上一期报道的GMTHuman Data EP02—MoCap:GMT这篇工作的共同一作。
Human Data这个系列,我的初心是通过访谈多篇基于人体动作数据来进行人形机器人全身运动控制的论文,来了解作者对于目前人体动作数据的观点。所以除了这些论文本身的方法介绍和核心贡献,每篇访谈的一些细节都很值得细看,未来的趋势也许藏在共同的细节里。和季马泽宇博士的这次交流,也有非常多很有启发的细节,一起来看看。
查看原文目录
以下为本文目录
👇
1. Exbody2方法介绍
2.关于Retargeting
3. 关于MoCap训练数据
4. 微调阶段
5. 关于Sim2Real Gap
6. 未来优化和迭代的方向
7. 如何激发机器人自主完成任务
1. Exbody2 方法介绍
Exbody2 与Exbody1 最大的区别其实在于Exbody1采用了上下半身分离控制的策略:上半身做 mimic,下半身不追踪具体动作,只跟随简单的指令,比如向前或向后。而 Exbody2 是全身协同的 mimic,采用了全身动作跟踪(whole-body tracking)。
Exbody1 之所以没有做全身mimic,一个主要原因是直接一阶段训练太困难,Exbody2通过引入 teacher-student 机制进行了升级。Teacher–Student核心思想是:在仿真中,模型可以获取机器人的全部状态信息,而在真实环境中,这些信息往往难以获得。
举例来说,机器人在仿真中可以直接读取自身的绝对速度(root velocity)等关键运动信息,而在现实中要获得这些信息非常困难。若想实现,需要借助额外传感器或视觉系统,结合 IMU 等方式进行估计,但目前为止仍没有成熟、稳定的解决方案。因此,为了弥合这种 sim-to-real 的差距,采用了两阶段训练策略。
第一阶段:Teacher 训练阶段
在这一阶段中,Teacher 可以访问机器人在仿真环境中所有完整的状态信息,包括那些现实中无法直接观测的数据。通过强化学习方式,根据奖励信号训练 Teacher,让它能够在仿真中稳定、准确地完成动作跟踪。由于信息完备,Teacher 能在仿真环境中学到非常精确的策略。不过,这样的策略无法直接部署到真实机器人上,因为真实机器人并没有相同的信息输入。
第二阶段:Student 学习阶段
在这一阶段中,Student 不再直接使用强化学习,而是采用监督学习进行训练。具体做法是利用 Teacher 作为教师模型,为每个状态提供一个理想动作作为真值(ground truth)。Student 在训练时根据这些真值调整自己的输出,使其行为尽可能接近 Teacher 的表现。
由于 Student 无法直接获取 Teacher 所用的完整信息,为了让它能够弥补信息缺失,模型通常会增加更多的历史观测。Student 通过神经网络,从自身的历史状态变化中学习推断出那些无法在现实中直接获得的隐藏变量。这种方法使得 Student 的策略能够在真实机器人上直接部署,实现稳定的全身运动控制。
这种 Teacher–Student 两阶段训练方式在locomotion研究中非常常见,无论是基于视觉输入的任务,还是纯运动控制任务,都广泛采用这一思路来缩小仿真与现实之间的差距。
2. 关于Retargeting
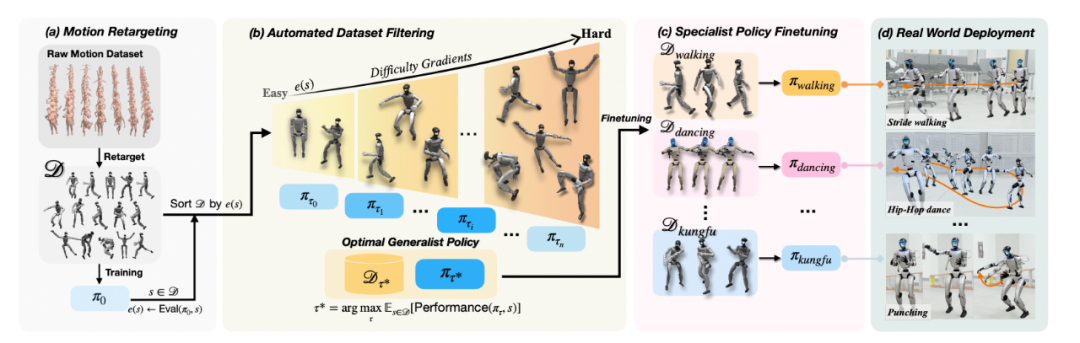
在全身动作跟踪研究中,我使用的数据主要来自开源动捕数据集。由于这些动捕数据是基于人类身体结构采集的,机器人无法直接使用,因此我们需要对数据进行处理。最关键的一步是将人类的动作重新映射到机器人的身体结构上,这个过程称为动作重定向(retargeting)。
动作重定向的过程有很多技术细节。即使完成了重定向,机器人也不一定能完美复现人类动作,因为机器人和人类在尺寸、关节构型以及硬件性能上都有显著差异。特别是当机器人的性能有限时,即便重定向的动作合理,也可能无法顺利执行。
在训练真实机器人时,我最初尝试过一次性让机器人学习所有动作。例如,同时启用成千上万个机器人,每个机器人被分配不同动作,采集数据后再统一训练,希望它们能快速掌握任意动作。但实践证明,这种“一股脑式”的训练方式极为困难,模型始终难以收敛。
后来,在 Exbody2 的研究中,我们采用了一种更系统的训练方法——动作难度梯度。这一方法的核心思想是让机器人先学习简单动作,在此基础上逐步增加动作复杂度。通过这种“由浅入深”的训练路径,机器人能够更稳定地掌握动作控制。然而,我们也发现一个问题:当模型不断学习更复杂的动作时,容易遗忘先前学过的简单动作,出现“灾难性遗忘”(catastrophic forgetting)。
为了解决这个问题,我们进一步优化了训练策略。具体来说,我们先利用一个初步训练得到的策略对所有动作进行排序,以动作难度为依据,将动作按复杂度划分层级。然后在训练时,只选择一定难度范围内的动作进行学习。实验结果表明,这种方式能让机器人在特定范围内的动作表现更好,同时对更困难的动作也能保持一定的泛化能力。整体跟踪精度甚至超过直接使用全部动作混合训练的效果。
为了进一步提升机器人执行复杂动作的能力,我们提出了一个分层策略:先用相对简单的动作训练出一个通用策略(general policy),然后将更困难的动作划分成若干较小的子集,对每个子集分别进行专项训练。通过这种方式,机器人在面对不同难度、不同类型的动作时都能保持较好的控制性能。尤其当动作子集划分得足够细时,机器人几乎可以对每一个动作都实现稳定的跟踪与复现。
3. 关于MoCap训练数据
我们现在使用的数据集是 AMASS 数据集。在我看来,这个数据集对我们工作的影响主要体现在两个方面:一是动作质量,二是动作分布的平衡性。
首先,数据质量是最基础的前提。AMASS 的数据在仿真环境下表现非常好,像罗正宜他们在早期工作(PHC、UHC)中展示的那样,几乎所有 AMASS 数据中的动作在模拟器里都能被精确复现。换句话说,从纯粹的动作精度角度来看,AMASS 的问题不大。它的骨架标注、关键点精度和动作流畅度都达到了很高水平。
真正影响训练效果的核心问题,是不同类型动作之间的不平衡。AMASS 的动作分布非常不均衡,比如其中有大量的行走动作——上万条数据中可能有八千条都是走路或类似的基础动作,而高难度或多样性的动作数量相对很少。这样一来,在训练时,模型会更倾向于反复学习走路、跑步这类简单模式,而复杂动作的学习比例被大幅压缩,导致模型的泛化能力受限。
我认为,维持动作类型之间的平衡是训练成败的关键之一。即便数据质量很高,如果动作类别分布过于集中,机器人在学习时依然会陷入偏倚。像 PHC 的研究中,他们在训练过程中非常重视动作样本的比例控制,通过精心设计的数据喂入策略,让机器人在不同类别动作上都能获得足够的学习机会,从而实现了几乎全动作范围的掌握。
当然,从更长远的角度来看,我觉得我们现在仍然缺乏足够多样的动捕数据。现有的数据大多是“人本身的动作”,而真正让人形机器人具备智能行为,还需要包含人与物体交互、人与场景交互 的数据。这类数据能让模型理解动作的意图和目标,而不仅仅是模仿动作轨迹。未来更丰富、更具语义层次的动捕数据集,应该是推动整个人形机器人控制能力进一步提升的关键。
4. 策略微调阶段
在 specialist policy fine-tuning 这个环节中,我们主要做的是将原本的通用策略在更小的动作组上进行针对性微调。
首先,这种微调的基本逻辑是:当模型被限制在一个较小的动作子集上进行训练时,无论这个子集如何划分,它的表现通常都会优于在包含大量复杂、多样动作的大规模混合数据上直接训练的结果。也就是说,只要把范围缩小、动作相似性提升,训练就会更稳定、更高效。
我们在具体实现时的做法是,把相似或相关的动作划分到同一个组内。例如,一组可能包含几种步行、转身或跑动类动作,而另一组可能包含跳跃、翻滚、旋转等高难度动作。显然,如果一个组内的动作在动力学特征和身体协调模式上越接近,训练出的策略效果就会越好。相反,如果把差异极大的动作混在一起,比如“走路”和“翻跟头”,那模型在优化时就会面临更大的梯度冲突和学习干扰。
在我们早期的实现中,分组方式相对直接。我们使用人工标注的方法,根据动作类型进行粗略划分,比如把“跑步、行走”类动作分成一组,“跳跃、旋转”类动作分成另一组。然后针对每个组分别进行 fine-tuning。结果表明,这种方式虽然简单,但效果显著:每个 specialist policy 都能在其负责的动作类别上获得更好的跟踪精度与稳定性。
当然,之后我们也在探索更自动化的分组策略,希望能通过聚类(clustering)或基于特征相似度的算法,让系统自动识别动作的动力学模式并划分组别。不过在 Exbody2 阶段,使用人工标注和直接划分类别的方式,已经能明显提升模型在特定动作上的控制效果。
5. 关于Sim2Real Gap
这个 sim-to-real 的 gap 完全取决于机器人本身的情况,尤其是电机,电机越老化,gap 就越大,这是没办法避免的。你可以想象,电机用了很久之后性能会下降,甚至在机器人刚启动时电机表现还好,但运行一段时间后电机会发热,发热之后它的特性就会发生变化,比如转速响应、摩擦、阻尼这些都会变得不一样。这个变化是没法在仿真里完全优化掉的。
基本上,现在的 gap 就是电机的 gap。你要想在机器人运行的过程中去自适应地调整电机参数,几乎是不可能的。除非有非常特殊的传感器去实时检测电机状态,否则做不到动态修正。
一般来说,大家在做 sim-to-real 优化时,主要针对电机参数进行建模,比如用 system identification的方法去拟合电机的真实参数,也有用神经网络去学习电机的非线性特征的做法。通过这种方式可以在仿真中尽量还原电机的真实特性,从而缩小仿真和现实之间的差距,但这个差距永远不可能完全消除。
有时候 sim-to-real 的效果会带有一点“碰运气”的成分。不过如果策略本身足够好,这种不确定性就会小很多。从我们的经验来看,最大的 sim-to-real gap 其实主要集中在脚踝部分,其次是腰部,其中脚踝的问题最明显。脚踝的误差非常大,这是因为脚踝的受力情况复杂,对平衡和落地都有直接影响。比如,如果 policy 对脚踝的依赖很强,一旦电机特性或摩擦发生变化,机器人就容易不稳定。相反,如果 policy 设计得比较鲁棒,让动作在落地时更平稳、力量分散得更均匀,不依赖脚踝的小范围摆动来维持平衡,那么即便脚踝存在一定偏差,机器人也能保持稳定运行。
所以最终能否在现实中跑得好,是由多个因素共同决定的:policy 的设计是否足够稳健,电机等硬件性能是否可靠,以及仿真与现实之间的动力学差异是否被充分建模。只有这几个方面都协调得好,sim-to-real 的迁移才能取得比较理想的效果。
6. 未来优化和迭代的方向
在整个工作完成之后,如果继续迭代和优化,有几个方向显得尤为关键。
首先,我们在 Exbody2 的实验中发现,平衡对机器人动作控制至关重要。GMTHuman Data EP02—MoCap:GMT 在 Exbody2 的基础上进行了直接改进,GMT 针对这一点引入了更优的采样策略(sampling method),在训练阶段通过均衡不同类别的数据,让机器人在学习时能更稳定地覆盖多种动作类型。通过这种方式,机器人即使不再对各个动作组进行单独微调,也能在大多数情况下完成各种动作,只要不是特别极端的情境,都能表现良好。
其次,Exbody2进一步提升的思路在如何让一个统一的策略自动适应不同动作组。Exbody2 在最后阶段将数据划分为多个 group,每个 group 上的训练结果都很好,但当时我们还没有实现一个机制去“融合”这些 group。现在有一些新的研究尝试让一个网络在不显式区分动作类别的情况下,自动在不同 group 之间切换。
这种思路的核心是使用各个 group 的训练结果来监督一个新的统一 policy,通过网络结构自身的学习能力,让它能够在多种动作之间自然过渡,而不需要人为指定切换逻辑。这样一来,即便只用一个 policy,机器人也能完成全范围的动作跟踪。
目前很多新的研究正沿着这个方向发展,尝试通过网络自适应地整合多类动作的控制策略,从而进一步提升泛化性与稳定性。
后面的方向,其实指的是在机器人学会了 track 各种动作之后,它接下来能做什么。现在整个领域的趋势是,验证一个 policy 可以在不同类型的动作上都实现稳定的跟踪,不再局限于“让机器人跳舞”这种纯模仿类的任务。
更重要的是,接下来的研究重点,是如何让机器人在不同场景下自主使用这些动作。当机器人已经具备一整套基础运动技能后,问题不再是“它能不能做动作”,而是“它在什么情境下该做哪个动作”。换句话说,就是要研究如何激发机器人在合适的时机、合适的场合下自主选择和组合动作。
这将是未来的核心方向——让机器人不仅能模仿动作,还能理解动作的意图,学会在真实任务场景中根据目标和环境去行动。
7. 如何激发机器人自主完成任务
这个“激发”的过程,其实指的是让机器人在已经具备大量动作技能的基础上,学会在合适的情境下主动调用这些技能,去完成一个目标或任务。最终的理想形态,其实和 manipulation是一样的。可以想象为一个具身智能体,它有视觉系统,比如一个摄像头在观察周围环境,当我告诉它“去拿起桌上的杯子”“向前走三步”“跳一段舞”时,它能够理解指令,并以最合适的身体动作去执行。
这个“激发”大体上有两种思路。
第一种方式是通过生成模型(如 diffusion model) 直接生成动作。
这种方法很直观:输入一段文字或任务描述,比如“往前走三步再向右转两步”或“跳一支舞”,模型就可以直接生成一段连续的全身动作序列。因为我们已经有 whole-body tracking 的基础,它就能顺着生成的动作自然去做。这种方式已经有不少研究在做,比如 GMT 等系统里也有类似的例子,通过语言直接生成机器人的动作轨迹。
不过,这种方法有明显的局限——它更适合做一些不涉及复杂交互的任务,比如跳舞、导航、展示动作等。如果要让机器人与物体交互、完成特定任务,单纯的动作生成就不够用了,因为它缺乏环境反馈和任务约束。
第二种方式是通过潜空间激发(latent skill activation)。
这类方法的核心思想是,不再直接生成整段动作,而是把机器人的所有技能都编码成一个潜在空间(latent space)。每一个向量(vector)代表一个技能,比如“行走”“下蹲”“抓取”“搬运”“放下”等。这样,当我想让机器人执行一个任务时,只需要从这个 latent space 中采样或选择对应的技能向量,再结合任务输入去“激发”它。
比如,任务是“把物体从这里搬到那边”。机器人本身已经有一系列技能:走过去、下蹲、双手抱起、站起、行走、放下。通过在 latent space 中激活这些技能向量,并用一个高层模型来调度它们,机器人就能组合出一条完整的动作序列去完成搬运任务。
在训练时,还可以把任务的奖励信融合进来,比如强化学习的形式。机器人不仅能激活已有技能,还能根据任务目标动态调整动作。这样,它既能复用已有的动作控制能力,又能通过奖励驱动学会更高层次的行为规划。
简单来说,前一种方法是“从文字到动作”,后一种是“从技能到任务”。前者更像“我告诉你怎么做”,后者更像“我告诉你要做什么”,机器人再自己决定“怎么做”——这正是整个行业未来正在探索的方向。