Human Data第一期我们采访了TwistHuman Data EP01-MoCap:TWIST,一个以动捕设备作为人形机器人遥操作媒介的工作,Human Data系列最后一期论文访谈,我们以Twist2来收尾。Twist2和Twist1相比,采用的遥操媒介设备精度上有所下降,采用VR+手柄+腿环来替代光学动捕设备采集人体动作,另外引入VR视觉回传系统。Twist2的一作迮博也是我们访谈的老朋友,一起来了解下Twist2这个工作。
TWIST2:人型机器人大规模数据采集系统 由来自Amazon FAR,Stanford,UC Berkeley,CMU,USC研究人员完成。可在15分钟内采集大规模人型机器人数据。 网页:https://yanjieze.com/TWIST2 演示视频请在项目页面观看:https://yanjieze.com/TWIST2/
查看原文目录
以下为本文目录
👇
1. Twist2的核心思想
2. VR+穿戴式设备精度问题
3. 低精度动捕是否需要以高精度动捕数据做基础
4. Twist2方法介绍
5. Twist2的设备介绍
1. Twist2的核心思想
在完成 Twist 1 之后,我的最大感受是——它还没有达到一个可以让所有人方便使用的程度。Twist 1 的目标是实现高质量的全身数据采集,但做完之后我们发现,虽然系统能用,却没有真正把数据采集这件事“采起来”。这是一个核心痛点。与此同时,行业里大多数的数采方案都是用于简单的控制或模仿任务,但质量普遍不高,通常只能做一些片段式的动作——比如“走几步、停下来、做一点事”,缺乏连续的高质量全身数据。
因此,Twist 2 的出发点就是要解决这个矛盾:既要保持像 Twist 1 那样的高质量全身数据,又要达到更高的采集效率。这两者看起来有点像“鱼和熊掌不可兼得”,但我们希望能兼顾两者。
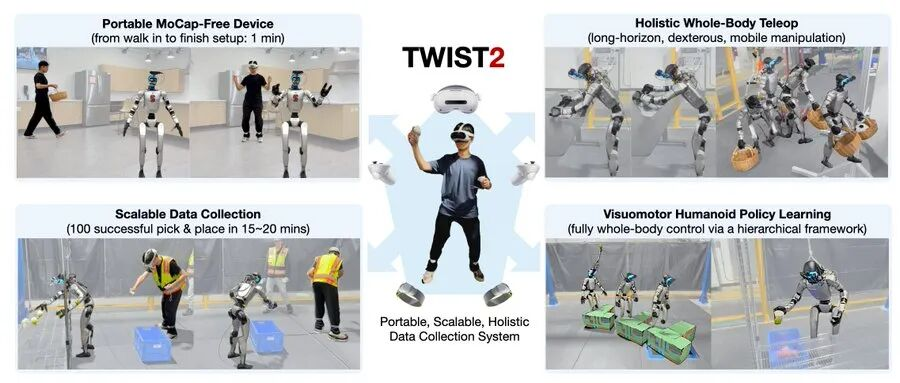
第一个关键改变是,我们用纯 VR 方案取代了传统的全身动捕设备。这样做的好处是,VR 系统不需要外部相机,也不需要长时间的校准——不像动捕服那样穿戴复杂、准备时间长。通过这种方式,我们让系统更轻量化,使用门槛更低。
第二个改变是,我们把机器人视角实时 stream 到 VR 系统里,让操作者能直接看到机器人看到的画面。这一点非常关键。即使拥有一套全身 VR 系统,如果人看不到机器人视角,数据质量仍然很差。操作者只能从第三人称视角判断,无法进行连续、精确的操作。因此,我们在机器人上设计了一个 active vision 模块,将它的视觉流实时传入 VR 中,显著提高了操作效率与采集质量。
第三个改变是,我们真正把整个系统打磨成了可连贯运行的完整系统。这不仅仅是“功能能用”,而是系统层面实现了完整流程的连贯控制——例如如何用手柄启动与停止系统、如何暂停与恢复数据采集、如何稳定记录长时间交互等。这些看似细节的小环节,其实极大提升了数据采集的稳定性与可靠性。
最后一步,我们真正把采集的数据用起来。我们将数据串联到不同的策略上,部署到 human-robot 系统中,实现了学术界首次通过完全全身(非上下半身分离)的 vision-based 采集系统进行 manipulation与 locomotion训练的实验。这是一个重要的突破,也标志着 Twist 2 相较于 Twist 1 的根本进步所在。
2. VR+穿戴式设备精度问题
Twist2的动捕方案是基于VR+穿戴式设备,在人体姿态估计的精度上,确实不如光学动捕系统,比如诺亦腾或 Vicon 那样高精度的方案。
我们在设计时考虑到这一点,因此采取了几种方法来弥补精度差距。首先,从强化学习或模仿学习的角度看,即使人体姿态估计在全局坐标系下存在一定误差,只要在局部参考系中保持一致性,这些数据仍然是可用的。换句话说,在 VR 系统的局部坐标系中,动作的相对结构是连贯的。虽然从全局精度上看会有偏差,但对于学习控制策略的模型而言,这些偏差是可以接受的。
为了让系统更稳定,我们还设计了一套局部接口。在这套设计中,操作者(human)和机器人(robot)之间的交互不是建立在全局坐标系上的,而是局部对应的关系。与之相比,像北大 CLONE 那样的系统属于全局配准系统,它要求人和机器人的姿态估计都非常准确,然后通过严格的全局映射进行配对。
而我们的系统没有这样的要求。正因为如此,它可以支持更长时间、更连续的任务执行。即使存在漂移(drift),由于是人实时在进行遥操作,人类的主动控制可以在操作过程中不断修正偏差,从而在交互中动态补偿这种误差。
这种方式的优势在于,它同时消解了人端和机端姿态估计不精确的问题。对于机器人端来说,
如果要获得极高的姿态估计精度,就需要配合 state estimation 模块,比如LIO/VIO算法;对于人类操作者,要获得精准的 global pose,就必须依赖昂贵且复杂的 VR 定位系统。我们的方案避免了这些复杂性,通过局部对齐与实时修正机制,简化了系统的整体设计,同时依然能实现稳定、连续的操作任务。
3. 低精度动捕是否需要以高精度动捕数据做基础
理论上来说,确实可以在没有高精度动捕数据的情况下,直接使用低精度 VR 动作数据进行训练或操作,是“有可能”的。
不过我们在实际做的时候,会采用一种折中的方式。我们主要还是用高精度动捕数据来训练我们的模型和控制器,大概有 99% 的数据都来自高精度动捕系统,其中也包括了 Twist 1 采集的数据。这些数据提供了非常稳定的时空一致性和骨骼姿态的精度,是模型学习动作模式和控制策略的核心基础。
与此同时,我们也会用大约 1% 的低精度数据来让模型去适应这部分“噪声更大”的输入,尤其是针对 VR 系统中精度不足的部位,例如下半身(腿、腰)。这些区域的漂移较明显,因此我们会在高精度数据的基础上,混合少量低精度数据,帮助模型在训练阶段就学会一定的鲁棒性,在部署到低精度系统上时能自动适应。
总结来说,就是一种 “高精度为主、低精度补充”的混合训练策略。它既保留了高精度动捕的可靠性,又让模型具备在低精度系统中运行的适应性。
4. Twist2方法介绍
这个系统主要分成两个部分,一个是系统设计(system design),另一个是学习系统(learning system)。
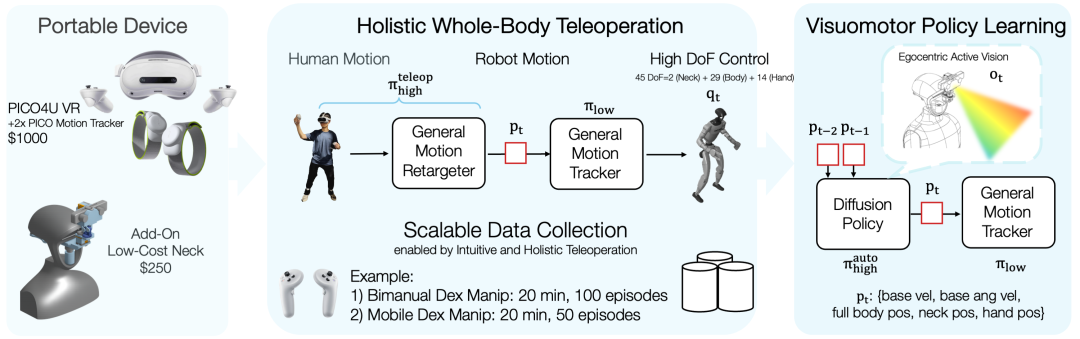
系统设计的部分,整个逻辑和Twist 1差不多,都是拿动捕数据,然后用 GMR 去做。Twist 2里面用的是完整版本的 GMR,而Twist 1当时还只是一个前身或者弱化版。Twist 2在 controller 上也有一些改动,还加入了一些 VR 和 vision 方面的处理。
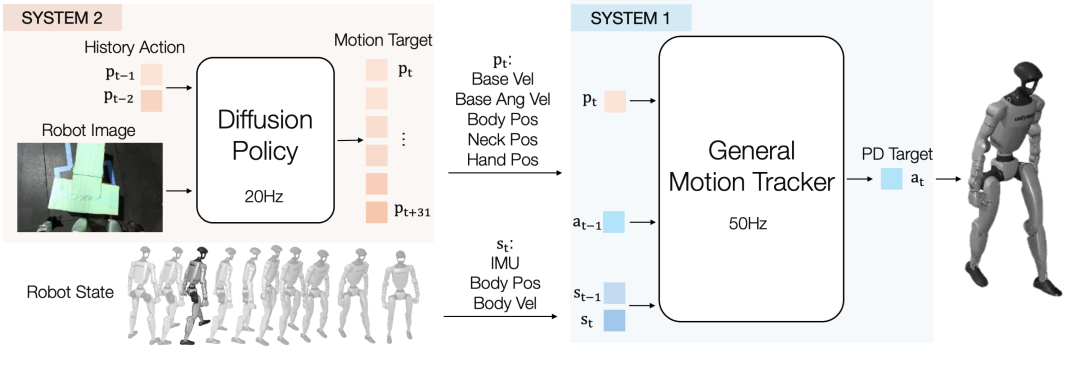
学习系统部分,是一个分层结构。我们先用一个生成模型去生成 human 的动作,它会产生一个中间层的表征,然后我们再运行一个 controller,把这个表征输入进去,让 controller 去模仿人类遥操作的过程。人类操作的方式是先通过视觉去观察,然后根据观察获得一个 observation,再输出一个 action,controller 接着把这个 action 转换成机器人可以执行的动作。
通过这样的设计,我们可以让机器人实现比较连续的上半身动作,同时下半身也能完成一些像踢腿这样的操作。
5. Twist2的设备介绍
我们这套工作用的是Pico的VR系统,这是唯一一套能满足我们需求的设备。它有配套的腿环、手柄以及完整的生态系统。我们的系统需要视觉传输,又需要全身姿态估计,而这套设备可以在一个统一的生态下完成所有功能。
相比之下,Vision Pro 和 Quest 都做不到。它们虽然在视觉或手部识别上有一些能力,但缺乏完整的交互支持,也不能在同一个应用体系中实现全流程。
VR 的手柄可以提供非常不错的 tracking 精度。以前我们的 tracking 稳定性不够高,所以在 Twist 1 的时候很难实现特别复杂的交互。到了 Twist 2,我们能做更好的 wrist tracking(手腕追踪),也就是对手部和手腕的跟踪更精确了。
这对操作任务来说非常关键,因为手部的 tracking 决定了物体交互的准确性和流畅性。现在的系统非常灵活,可以让操作者自然地转动手腕、调整姿势,做出各种灵活的动作,也能实现一些更有趣的任务,比如叠衣服这样的复杂交互。
当然,这套设备在人体全身动作捕捉上还是存在一些局限。主要问题在于全局坐标系(global coordinate system)下的不准确性。也就是说,它在空间中的绝对位置(global position)可能会有偏差,尤其是在长时间操作或大范围移动时,这种漂移(drift)会更明显。
目前我们是通过使用局部坐标系(local coordinate system)的方式来解决这个问题。让人和机器人在各自的局部坐标下对齐(alignment),而不是强制依赖一个全局参照系。全局姿态估计(global pose estimation)一直是一个长期存在的难题,不只是这套设备,包括很多其他系统在这一点上都还没完全解决。
如果一定要解决全局坐标系的问题,一个办法是通过工程优化(engineering optimization)去提升系统精度,比如改进硬件同步、优化算法、做更好的状态估计(state estimation)。另一种方式,就是我们现在采用的——使用局部坐标系(local coordinate system)。
这种方式的逻辑是,人类在行动时其实并不依赖全局坐标。例如,你走路时不会想着自己在“全局”上移动了多少米,而是通过视觉判断“门离我还有几步”,然后走过去、停下来。也就是说,人类的行为是基于视觉感知(visual perception)和相对距离判断(relative distance estimation)的,而不是依赖于绝对坐标。
所以,如果目标是实现更通用的智能(general intelligence),其实并不需要强依赖全局坐标系统。系统只要能通过视觉去理解环境、判断自己是否到达目标、是否与物体产生交互,就足够完成任务。
当然,传统的机器人系统(例如导航类)仍然会用全局定位、路径规划等模块来维持全局一致性,这一套在某些固定场景下依然是有效的。只是对于具身智能或者更灵活的遥操作系统来说,局部感知和视觉判断可能是更自然、也更可行的路径。
References:
Twist2: