对于Human Data的使用,Retargeting是一个非常重要的环节。我们之前的一些采访陆续介绍了一些Retargeting的方法,比如PHC专访罗正宜:解密PHC——人形机器人通用控制器,比如GMRHuman Data EP01-MoCap:TWIST。
Retargeting指如何把一个主体(通常是人类)的动作,转换成另一个主体(通常是机器人或虚拟角色)能够执行的动作的过程,简而言之就是把人的动作移植到机器人身上。
Human Data系列加更一期,介绍一篇非常优秀的人形机器人Retargeting相关的工作,OmniRetarget,一种基于 interaction mesh 的、能够保持交互关系的数据生成引擎。先看效果(所有机器人视频均以实时方式运行。其对应的强化学习策略使用统一的 5 个奖励项和 4 个域随机化项进行训练,并且完全依赖本体感知输入):
WallFlip
Flagship Demo
传统的Retargeting方法,机器人重定向后的动作里会出现一些不太自然的表现,还经常发生穿模。OmniRetarget的效果整体看起来更自然,而且能够很好地保持交互,并真正落实各种硬约束。此外OmniRetarget还可以进行数据增强,减少对原始动捕数据数量的依赖,而之前那些 retargeting 的方法其实很难做到这一点。
这篇访谈来自对OmniRetarget一作之一杨麓洁的专访,麓洁博士毕业于MIT,师从Russ Tedrake教授,本科毕业于加州大学伯克利分校,师从 Francesco Borrelli 教授。她的研究方向是将机器学习、优化和控制理论结合起来,用于机器人系统的规划与控制。开发同时利用数据驱动与模型驱动优化的方法,使机器人在灵巧操作、复杂接触等任务中具备更高的性能和可靠性。
如果你对人形机器人全身运控以及Retargeting问题感兴趣,一起来了解下OmniRetarget背后的思考。
查看原文目录
以下为本文目录
👇
1. OmniRetarget的核心思想
2. Interaciton Mesh
3. 过往的Retargeting方法有什么问题?
4. OmniRetarget方法介绍
5. 关于数据源
6. 对Model-based和Learning-based的思考
7. OmniRetarget方法中的Model-based精髓
8. OmniRetarget比传统Retargeting方法的提升
9. 为什么传统的Retargeting方法无法做数据增强
10. 什么类型的动作无法通过数据增强来实现?
11. OmniRetarget的效果
12. OmniRetarget对推动增加交互的全身运控路线发展的作用
13. 不同的人穿戴动捕服对Retargeting的效果有影响吗?
14. 理想中的robot foundation model
15. 关于PhysicsGen
16. 关于研究的Vision
17. 关于数据类型的偏好
1. OmniRetarget的核心思想
我觉得可以从我是怎么开始这个项目说起。一开始,我其实是想做我之前一个工作(Physics Gen)的延伸。之前那个工作是关于灵巧操作的,主要做的是灵巧操作的数据生成。所以一个非常自然的想法就是:能不能用同样的方法来做人形机器人的数据生成。
当然,第一步就是先做运动学重定向(kinematic retargeting),也就是说先不带动力学,只做运动学层面,把 human data 转成 robot data。
然后我发现之前的Retargeting方法里面其实有很多问题,比如:脚会穿地,会滑步,有时候解出来的动作不够自然、不够平滑,而且也不能加各种 hard constraint。那时候我就意识到:其实这是一个挺大的问题。但是目前做 RL 的人并没有从根本上去解决这个问题,而是不断地靠加 reward engineering 去弥补 retargeting 这个阶段的本质问题。
所以我当时就觉得:这是一个非常重要的环节,需要有人去写一个真正好的 retargeter。这大概就是项目的初衷。
在做的过程中,我们也发现,以前做 retargeting 的一个非常通用的办法是用 global 的 keypoint matching,也就是在人类在世界坐标系里的某个位置,比如人的手在哪,机器人就把手移动到对应的位置。但这种做法其实有很多问题,对于形态结构和人类差异巨大的 humanoid 来说,这其实非常有挑战性。比如机器人通常更矮、手更短,所以根本不能直接把人的位置按比例缩小,也不能简单地用人的全局位置来告诉机器人应该走到哪里。
所以我们认为应该用更 principled 的方式,比如保留相对的空间关系、接触信息。后来我们找到一个来自计算机图形学(CG)的思路——interaction mesh。就是在人和机器人的身体表面 sample 一些关键点,比如手臂、手腕、脚跟、头部、肩膀等,同时在物体上也选一些关键点。通过保留双方的相对空间信息来实现 retargeting。
举个例子:如果人手与物体的距离很近,我们也希望机器人手与物体的距离同样保持很近,但机器人实现动作的关节角度可能会跟人类完全不一样。所以这就是我们方法里的一个创新点。
2. 怎么理解OmniRetargeting提出的Retargeting方法——Interaciton Mesh
Interaction Mesh我觉得可以把它理解成一个网。我不仅关心某个点本身的位置,不管是机器人身上的点还是物体上的点,我更关心的是这张网的结构,也就是这些点之间的连接关系(edge)。这些 edge 表示的是点与点之间的相对位置关系,还有它们之间是否存在“前后”“遮挡”“跨越”等关系,如下图所示。
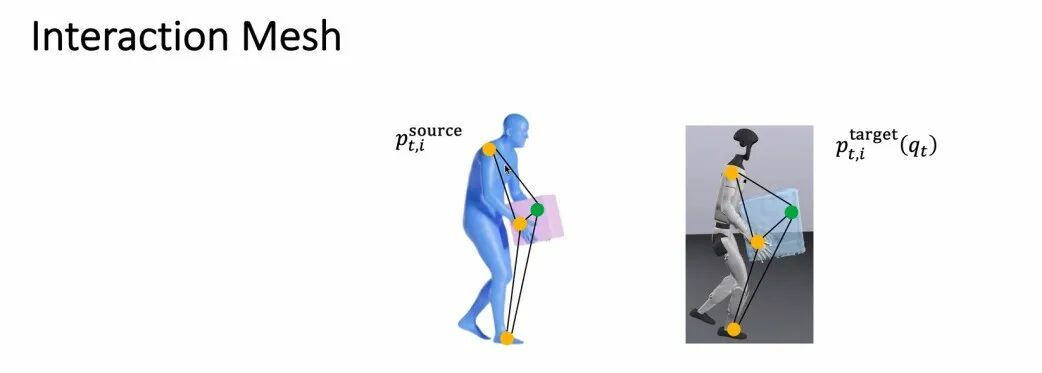
我需要确保绿色的点一定在黄色点的前面,也需要保证这些点之间的相对空间关系在人和机器人身上是尽可能一致的。因为机器人比人矮很多,这张图本身会有一些“拉伸”(stretch),所以相对关系是被放大或压缩之后的结果。
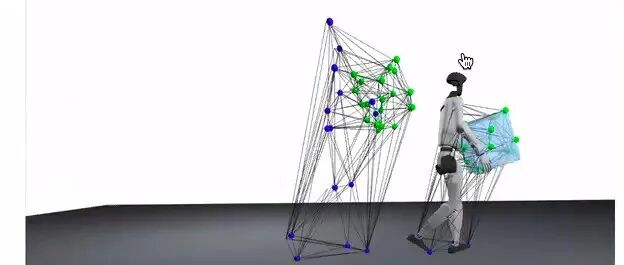
在机器人和人身上,这些点的密度其实并不算特别高。动画里蓝色的是机器人和人身上的采样点,绿色的是物体上的点。人体上大概包括:左右肩膀、胳膊肘、手掌,骨盆附近的几个点,膝盖、脚跟和脚尖。
如果我们更关注某些点或某些部位的映射,就可以增加这些部位的采样点数量。这样一来,在重定向的时候,这些区域之间的相对位置关系就更容易被保持住。
3. 过往的Retargeting方法有什么问题?
PHC(专访罗正宜:解密PHC——人形机器人通用控制器)或者GMR(Human Data EP01-MoCap:TWIST)使用的Retargeting方法,本质上都非常直观,它们其实就是在绝对坐标系下做一个点到点的简单映射。
这些传统的Retargeting方法,如果是 online 情况会稍微好一点,相当于是由人在线上去闭合机器人与物体之间的关系这个 loop;但如果是 offline,就会出现比较明显的问题。比如说,人可能是 1.8 米高,而机器人,比如 G1,只有 1.3 米。机器人比人矮很多,那怎样才能让人的演示动作在重定向到机器人上时依然看起来合理,这是个很大的挑战。
一个比较直接的做法是把人的动作按比例缩小,也就是把 1.8 米的动作 scale down 到 1.3 米。但这样会带来一个问题:如果在人类动作里,手刚好碰到箱子的边缘,那么在按比例缩小之后,手的那个点可能会直接穿进箱子里面。也就是说,它没办法保持手、手腕和物体之间的相对位置关系。
当出现这些问题的时候,补救的方式通常是在后续的强化学习训练阶段,不断添加各种奖励项去“hack”这个问题。也不能说是完全补偿,而更像是在用奖励去掩盖或弥补这个前期重定向阶段留下的这些 artifact。
我感觉以前大家对Retargeting这一环节的处理都有点“糊弄”,质量并不算高。对于locomotion来说,反正可以通过各种 reward engineering、reward hacking 去勉强修补,所以即使重定向阶段做得不够好,最后也能让机器人“能走能跳”。
但如果要做更复杂、更困难的任务,就会明显看到一些问题。例如有些 policy 会呈现出非常抖或不稳定的趋势,或者生成的动作很奇怪。这些现象都说明:这个问题其实需要从根本上去解决,而不是仅靠后续奖励去掩盖前面步骤的不足。
4. OmniRetarget方法介绍
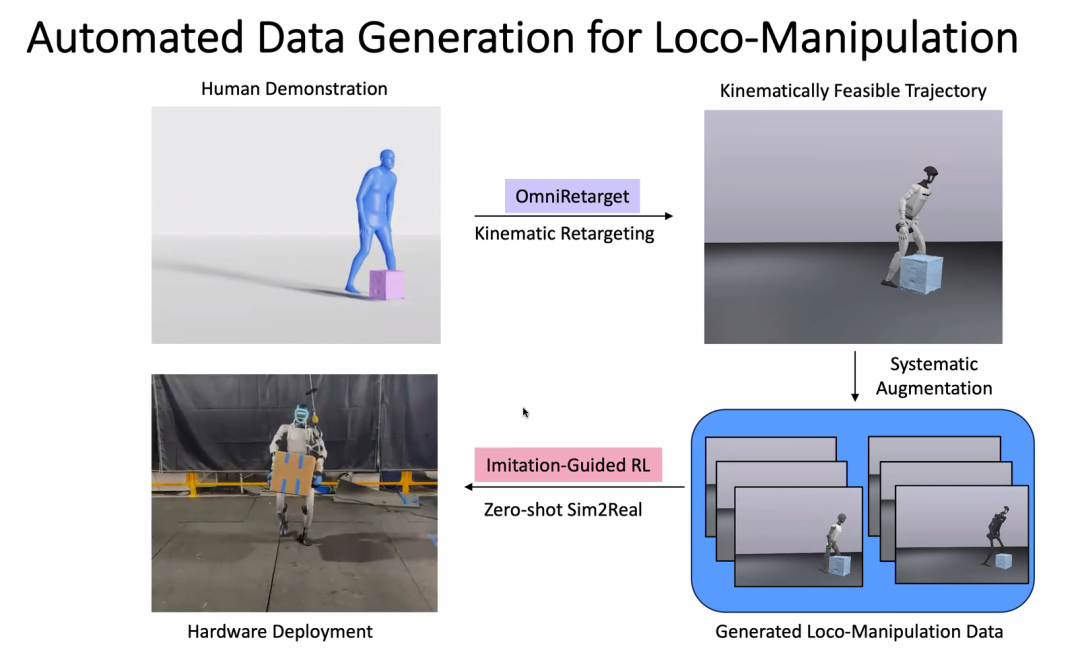
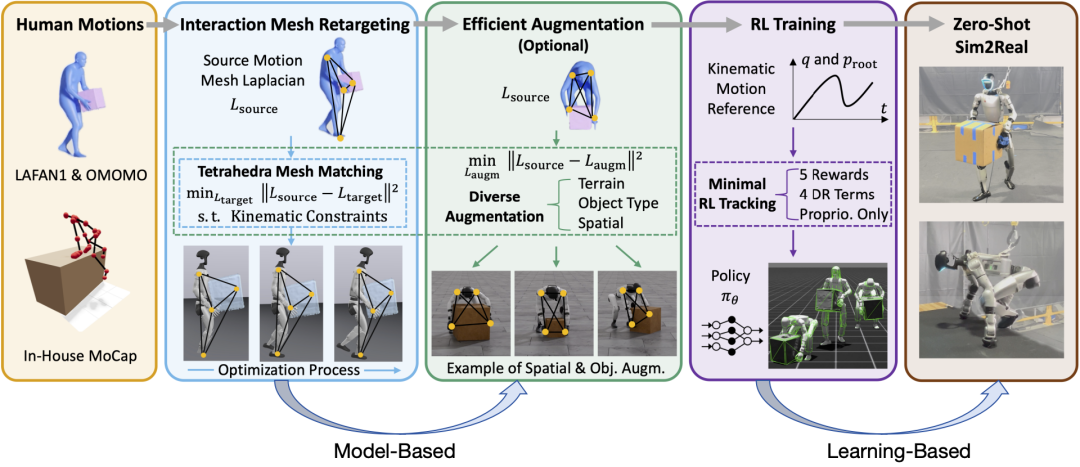
首先,我们从人类示范(human demos)开始,通过Retargeting获得一条满足运动学约束的机器人轨迹。
在此基础上,如果希望进行数据增强,例如改变物体的尺寸、方位,或替换成不同的机器人模型,我们只需要基于 retargeting 即可生成相应的数据。通过这种方式,可以获得大量运动学可行(kinematic feasible)的轨迹。然而,这些轨迹在大多数情况下并不满足动力学可行性,也即不具备动力学上的可实现性。
接下来,我们需要进一步将这些轨迹转化为动力学可行的轨迹,或直接据此训练出相应的策略。我们采用的方式是 imitation-guided RL。这种方法在locomotion领域已被广泛使用,即通过提供参考轨迹令强化学习策略进行模仿,同时确保满足动力学约束。
这一范式最早由DeepMimic 提出,近年在 locomotion 任务中尤为常见。由于我的合作者是 BeyondMimic 的第一作者之一(Huang Xiaoyu),我们在本工作中也直接采用了 BeyondMimic 的完整 RL pipeline,并在此基础上加入了更多关于物体以及环境的交互建模。
之后我们我们直接将策略部署到真实机器人上,完全未使用任何真实数据,也没有任何遥操作数据参与训练。
5. 关于数据源
我们的数据来源主要包括两个动捕数据集:LAFAN 和 OMOMO,以及我们自行采集的动捕数据。此外,我们还有一位合作者亲自录制了大量示范,例如攀爬不同尺寸的箱子等动作,这些也构成了我们数据的一部分。
现有的开源数据集中,涉及与环境进行复杂交互的示范其实并不多。以我们最终的示例为例:机器人需要先搬起一把椅子,再踩上椅子,利用椅子作为支撑攀上更高的平台,随后再从平台跳下。像这样同时涉及物体交互与环境交互的动作数据,在现有公开数据集中非常稀缺。
6. 对Model-based和Learning-based的思考
我觉得 model-based 和 learning-based 各有自己的优缺点。model-based 的优势在于,它依赖明确的模型和数学原理,可以从原理层面出发,更有效率、更高质量地解决一些学习方法难以处理的问题,比如求 IK,或者做等式约束的优化(EC formulation)等。
但它的缺点也很明显:需要非常准确的模型,需要良好的状态估计(state estimation),而且对于一些很难精确建模的系统,比如流体、可变形物体、衣服等,模型并不容易以数学方式准确写出来。
相对而言,learning-based 的方法,也就是现在大家最常用的深度学习方式,非常灵活,能力也很强,可以做端到端,从图像直接输出关节力矩(torque),并且不需要状态估计。
但 learning-based 的局限在于两个方面:第一,它并不能特别有效地利用计算资源;第二,它需要极其大量的数据。
所以对我来说,更好的方式应该是结合两者的优势。用 model-based 的方法生成数据,比如我现在在做的 retargeting 和数据生成;然后再用 learning-based 的方法,把这些数据变成可以部署的、更加灵活、反应更快的策略(policy)。
7. OmniRetarget方法中的Model-based精髓
OmniRetarget提出的全新Retargeting方法得益于model-based 和 optimization 的背景。因为对于做优化的人来说,当我想要加入一些约束时,我会希望这些约束是可以真正被满足的,也就是 hard constraints 能够被严格地 enforce。同时,我希望我的优化问题本身是定义清晰、结构干净的,并且最好它的解还能具备某种 optimality(最优性) 或者 convergence(收敛性) 的保证。
当然,现实中这个问题非常难,它本质上是一个非凸(non-convex)问题,所以确实很难给出任何严格的最优性或收敛性保证。但我们做了一个凸近似(convex approximation),在实际使用中,在我们遇到的所有情况里,它的求解都非常稳定、很鲁棒,而且过程本身也更有原则性(principled)。这样我们就能真正 enforce 各种等式和不等式的硬约束。
比如说,我们想要满足一些硬约束,比如脚不能滑、不能超过关节的上下限(也就是每个关节的最大值和最小值),以及不能发生碰撞等等。而通常做深度学习的人,会把这些约束转换成软惩罚,把 penalty 当成一个软约束项加到整体的代价函数里,然后用类似 SGD 之类的方法去优化,把它当成软约束来处理。
但我更倾向于把它们当成真正的硬约束来处理,把这个原本非凸的问题近似成一个凸问题。这样做的好处是:第一,不用调各种惩罚系数;第二,求解过程更可控,我们能明确知道这些硬约束一定不会被违反。而且很多时候,这些约束本身其实非常关键。
我们在这里关心的对象并不是物体本身,而是机器人自身的一些运动学规律和原理。比如说,这是我最后写下来的一个等式,这个等式想表达的就是:机器人的脚不能滑动。
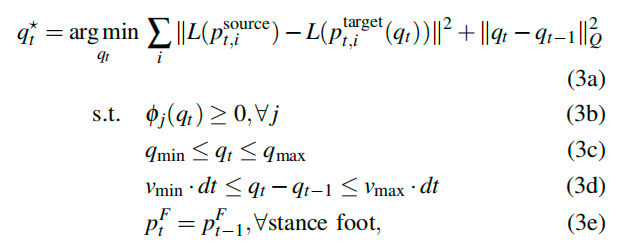
等式的左边表示脚在第 t 个时刻的位置,右边表示脚在第 t−1 个时刻的位置,我希望强制这个等式成立,也就是让这两个位置保持一致。
一般来说,做学习的人可能会直接把Pt-Pt-1的平方放进代价函数里,把它当成一个软约束项。这样对优化过程来说会简单很多,但无法真正保证Pt=Pt-1(3e)。然而,这个性质其实非常重要,因为它直接决定了机器人在行走过程中会不会出现滑动。
而我们的方法就是把这个等式作为真正的硬约束来处理,确保它一定成立,从而保证机器人不会滑步。
在涉及交互的时候,我们的这个代价函数的作用会更大一些。比如说,这里就是我构建的一个 interaction mesh,也就是一个交互网络。我们的目标是:人体和物体之间形成的这个网络,和机器人与物体之间形成的网络,它们之间的差别不要太大。所以在交互场景里,就是通过这个 cost 来实现这种对应关系的。
但在实际过程中,很容易出现问题,比如手直接穿模。我给一个例子,比如这里这个情况,就是直接跑一个全局关键点匹配(global keypoint matching)的结果。它相当于把人的关键点压缩到机器人的尺寸上,而在压缩之后,手一下子就会穿进物体里面。
但在理想情况下,我们当然不希望机器人的身体部位之间,或者机器人和物体之间出现穿模现象。所以我们需要加入硬约束(hard constraints,3a)。这里的约束是“非穿透约束”,也就是所有身体部位之间,以及身体与物体之间,都不能发生穿透。
8. OmniRetarget比传统Retargeting方法的提升
在文章中我们有做定量分析来论证这一点;从定性结果来看,也可以很明显地看到差异。比如左边是 PHC 的效果,而且这个例子并不是精挑细选出来的,是非常常见的情况:动作里会出现一些不太自然的表现,还经常发生穿模。右边是我们的方法,整体看起来更自然,而且能够很好地保持交互(interaction),并真正落实各种硬约束。
OmniRetarget和GMR使用的Retargeting方法效果对比
OmniRetarget和PHC使用的Retargeting方法效果对比
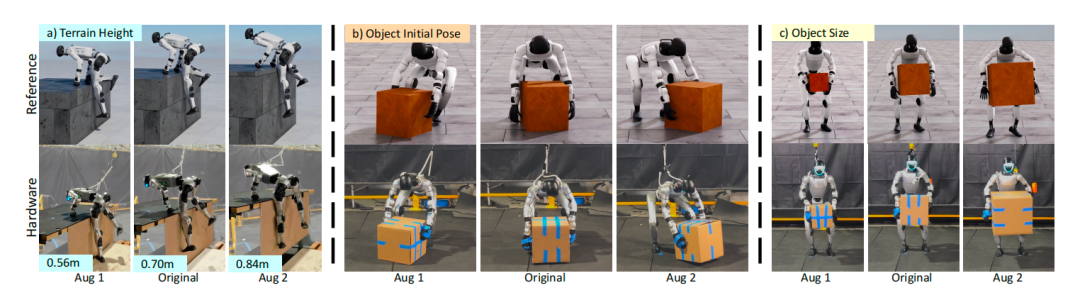
另外,我们的方法还可以进行数据增强(data augmentation),而之前那些 retargeting 的方法其实很难做到这一点。OMNIRETARGET 能够从一条人类示范中系统地生成多种变化,包括:(a) 地形高度、(b) 物体初始姿态、(c) 物体形状。在仿真中优化得到的动作(上方)能够稳定一致地迁移到真实硬件上(下方)。
9. 为什么传统的Retargeting方法无法做数据增强
因为之前的Retargeting方法没有保持人和物体之间的相对关系,这就会造成一些问题。我举个例子:比如说这个例子里,前一段是原始的 demo,其他的是通过数据增强生成的结果。如果你再看这一段动作,可以看到我们的方法保留了机器人上半身和物体之间的相对位置关系,所以机器人会知道要向左扭身去抱住物体。
但是如果只使用绝对位置,那么即使箱子的初始位置发生变化,机器人依然只会“往前抱”这个箱子,而不会意识到需要调整姿势去真正把它抱起来。这样它就可能根本抱不动这个箱子。
像 GMR,比如 Twist 或 visual Mimic 这些方法,它们其实是 online 的,由人来闭合这个交互的 loop,也就是说由人来决定机器人该如何与物体和环境互动。所以它们也能够完成一些Loco-manipulation的任务。但如果是 offline 的方式,就需要考虑的因素会更多,处理起来也会更复杂。
10. 什么类型的动作无法通过数据增强来实现?
如果动作本身差异过大,也会带来一定困难。比如同样是跨越一个平台,有的人会用手支撑着跨过去,有的人会直接跨过去,还有的人会用膝盖点一下再跨。这类动作方式差异明显的情况,仍然需要一定量的原始数据支持。
对于不同形状的物体而言,如果是在同一类别内部进行变化,问题通常不大。例如都是水杯,只是有的更胖、有的更瘦,或者杯把的形状略有差别,这类变化属于类别层面的泛化,通常比较容易处理。但如果把水杯直接换成一个方形的盒子,这类跨类别的变化就会相对更具挑战性。
11. OmniRetarget的效果
我认为目前的效果已经出乎意料地好。其他同事也直接将我们的方法应用在一些非常具有挑战性的物体上,例如灯具等,基本都能直接使用。OmniRetarget的核心贡献,首先,能够实现与环境的交互,并且确保我们重定向得到的轨迹质量较高——例如不滑步、不发生碰撞;其次,我们能够进行有效的数据增强。
不过,仍然存在一定的局限性。其中一个限制是,当我们进行数据增强时,如果增强后的物体位置或尺寸与原始情况差异过大,就会出现一些伪影(artifact)。例如,如果原始物体只有五十厘米左右,而在增强时将其直接扩大到一米见方,那么在某些情况下,机器人可能会出现“漂浮”在空中的现象。这是因为物体变得过大,系统试图保持机器人与物体之间的相对位置关系,但因此未能同时很好地维持机器人与地面之间的相对距离。
因此,数据增强并不是可以无限扩展的;这种方法并不能在任意尺度的变化上都保持完全可靠的效果。
我们会开源这一套方法,官方的计划发布时间是 12 月 1 日,会推出正式的开源版本。此外,我个人之后也会开源自己的实现。之所以会有两个版本,是因为官方团队使用 Mujoco 重新复现了我提出的方法,而我在开发过程中使用的是 Drake。因此两者主要区别在于底层的求解引擎不同,例如服务器端的实现方式以及雅可比矩阵等动力学相关计算所依赖的引擎各不相同。
12. OmniRetarget对推动增加交互的全身运控路线发展的作用
一方面,在数据采集上会快很多。例如在同一个场景中,我们只需要采集一条示范数据,就可以生成不同大小、不同形状、不同高度以及不同方位的多种轨迹,而不必对每一种变化都重新录一条示范。重新采集每个 variation 是非常耗时的,而数据生成可以通过大量CPU 并行完成,因此效率非常高。
另一方面,当我们的参考轨迹质量更高时,下游的 RL 训练会收敛得更快,成功率也会显著提升。这里的表格展示的就是我们之前提到的 retargeting 质量问题。
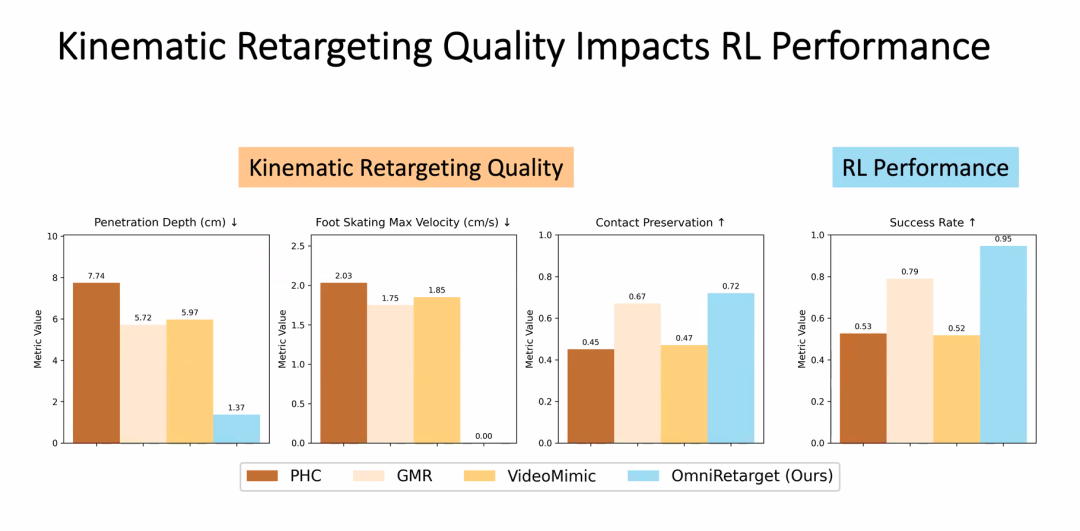
从定量指标来看,我们统计了穿模的程度、滑步的程度,以及相对位置保持得有多好。表格中蓝色部分对应的是我们的OmniRetarget方法,可以看到在所有指标上,穿模最少、滑步最少,并且保持相对位置的效果最好。我们在进行 RL 训练的过程中发现,这三个指标对最终的强化学习效果影响非常显著。因此,相对而言,我们下游 RL 任务的成功率也更高。
13. 不同的人穿戴动捕服对Retargeting的效果有影响吗?
基本上我只需要知道示范者的身高,这就是我需要的全部信息。至于示范者的胖瘦、体型比例这些因素都不会影响重定向结果。
14. 理想中的robot foundation model
我可以简单讲一下,我理想中未来这个“生成数据”的系统应该是什么样子。我的目标是做一个比较通用的 data generation framework,它可以同时适用于 manipulation、locomotion 和 loco-manipulation 这几类任务。
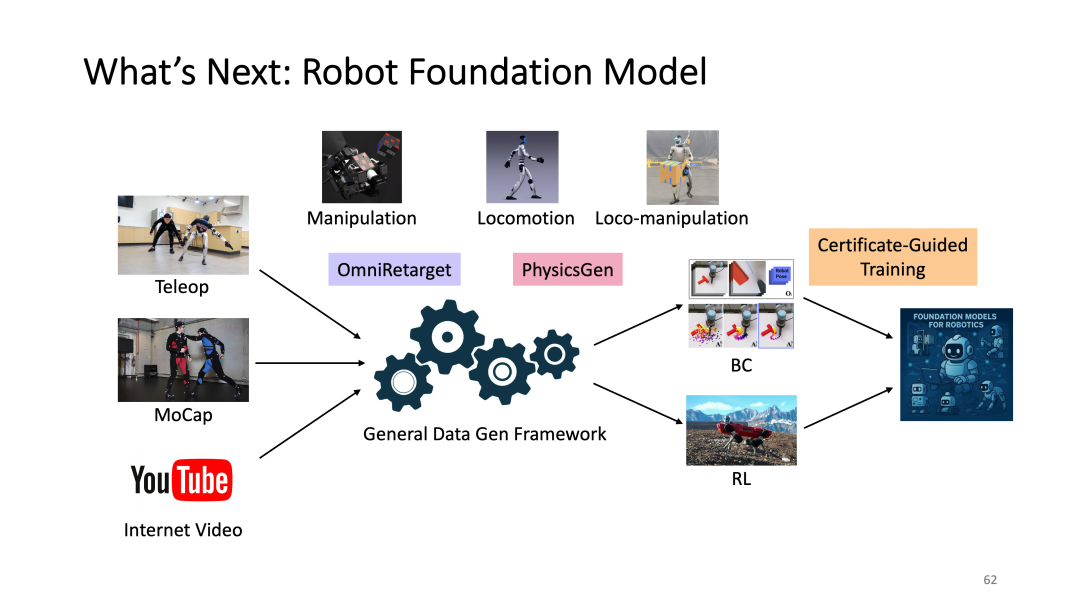
在上游的数据形式上,我理想中是各种类型都能支持:可以是遥操作数据,可以是动捕数据,也可以是视频数据。当然,从质量上来说,动捕数据和遥操作数据通常会比互联网视频更可靠。怎么从一张二维图片,或者一段“二维加时间”的视频,重建出一个三维的人和三维的物体,这本身就是一件很有挑战的事。
但互联网视频的优势在于数量巨大、分布广泛、类型多样,而且往往还带有更丰富的语义信息。比如各种教程类视频,会一步一步教你怎么折箱子、叠衣服、整理物品等等,所以从内容角度来看是非常丰富的。因此,从长期来看,我们肯定是希望各种数据源都能用起来。
在下游任务上,我希望这个系统是开放的:既可以用来做 behavior cloning,让机器人去模仿自己“经历过”的事情;也可以在一个足够强的模拟器里,用 RL 的方式去学习如何利用这些数据,最终得到一个通用的、可以支持多种任务的机器人基础模型(robot foundation model)。
15. 关于PhysicsGen
PhysicsGen 是我之前在做机械臂操作时提出的一套数据生成方法。我可以简单讲一下,它的整体理念其实和 OmniRetarget 很接近:同样是先采集自己的示范数据。
这里展示的是我采集的 VR 数据,当时我戴着 Vision Pro,在 VR 环境里模拟了一个小方块,并通过 VR 手势完成示范,然后再将这些示范通过 retargeting 映射到两个机械臂上。有趣的是,我在 VR 里是用两根手指完成的操作,而最终却能够把它重定向到体积大得多的两台机械臂上。VR 里的方块大概只有 6 厘米,而现实中的大箱子可能是 30 厘米,尺度差异非常明显。
在此基础上,我们同样可以进行各种物理参数上的数据增强,也可以测试不同形态结构(morphology)的机器人。
在下游部分,我采用了 behavior cloning训练得到一个策略。可以看到最终机械臂执行的动作比我在 VR 里采集到的原始示范要大很多。当时我用的仍然是比较朴素的全局关键点匹配,整个方法还比较简单。
这篇工作的关键在于:在进入轨迹优化之前,我除了运动学重定向(kinematic retargeting)之外,还加入了一些动力学方面的增强(dynamics augmentation)。因此,在轨迹优化阶段,我能够显式处理不同箱子的摩擦系数、尺寸变化以及质量差异——例如原始示范是一个 100 克的轻物体,但通过动力学增强之后,系统可以成功生成搬运 500 克箱子的策略。
16. 关于研究的Vision
我可以简单讲一下我的 big vision。给一点背景:我之前做的一系列研究,主要还是集中在 dexterity 和 agility 这类偏底层的控制方向上。但现在大家更关注的问题,往往是 general robotics、cognition、如何做更强的泛化,以及更高层的任务组合和理解。
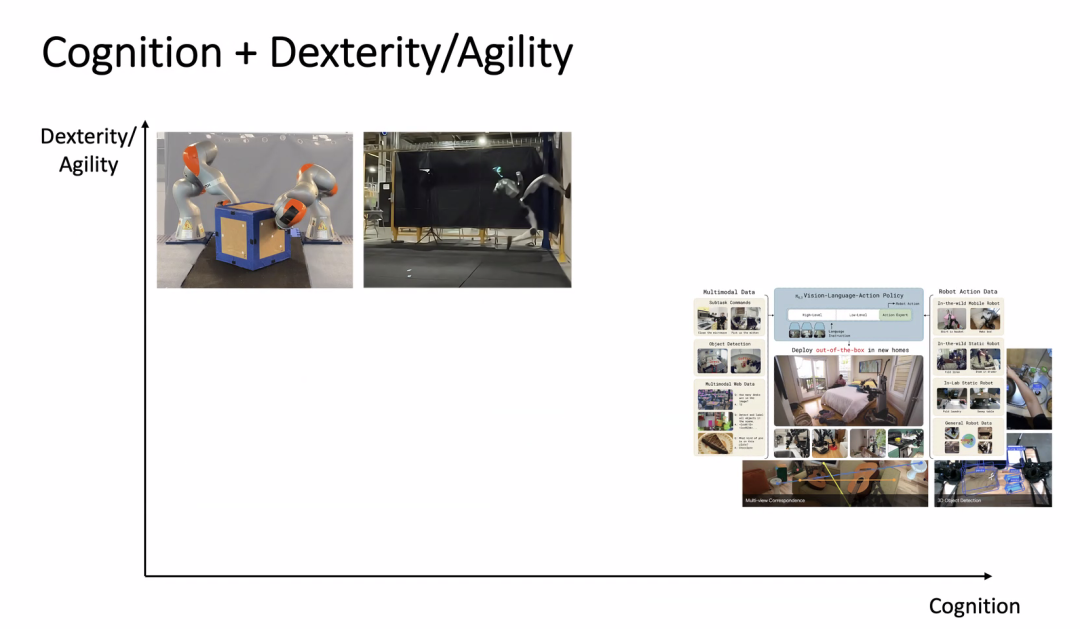
不过在我看来,低层控制其实还有很大的提升空间。如果我们想真正迈向下一代的机器人基础模型,模型中必须同时包含两部分:一是底层的 dexterity 和 agility,二是高层的任务理解与认知(cognition)。
这两部分需要同时被涵盖,而且必须能够相互作用、协同工作。只有这样,机器人才能既足够灵巧、敏捷,又具备智慧与稳定性)。
换句话说,我们必须同时做 cognition 与 dexterity/agility,并让智能在这两个层面之间自然流动。
17. 关于数据类型的偏好
我对遥操作其实有一些自己的看法。我认为真实的实体数据当然是需要的,但遥操作本身仍存在不少问题。例如延迟、人与机器人之间的形体差异,以及缺乏触觉反馈——人在操控机器人时,机器人“感觉”到的触觉,人类无法同步感知。因此中间始终存在一层差距。此外,操作者本人的动作可能会抖动,导致记录下来的轨迹和最终得到的 policy 也会出现抖动等问题。
但如果我们能在这些遥操作轨迹上再加一些优化方法,使轨迹变得更优,也许能够进一步提高数据的质量。另一个局限在于,有些任务并不现实依靠遥操作来完成——比如让操作者直接遥控机器人做后空翻,这显然不太可行。如果我们希望获得某些超人类的能力,就必须依赖遥操作之外的其他方法。
就我个人而言,我更偏好使用 human data。人类的数据量大,而且动作通常更自然。
拿自动驾驶和机器人做对比的话,对于自动驾驶:汽车从设计之初就是给人开的,因此人的驾驶数据天然适合训练驾驶模型。但机器人并不是为了“被人操控”而设计的,而是为了完成一些人类日常会做的任务。如果某件事人类平时都很少做,那么让机器人专门去做这件事,应用价值也未必高。
因此在人类能够熟练完成的任务上,人类示范数据对于机器人来说是最有价值的资源之一。
References:
Lujie主页
OmniRetarget:
https://omniretarget.github.io/
PhysicsGen:
https://lujieyang.github.io/physicsgen/