在Human Data系列总结篇:Human Data—The “Key” to Robot Data,我们总结了Human Data金字塔。今天这期专访,我们很荣幸的邀请到致力于解决Human Data金字塔各层级数据问题的公司诺亦腾机器人的首席科学家韩磊博士做专访,作为压轴专访第一篇。
熟悉石麻笔记的朋友们一定看过2023年的一篇文章AI+Robotics华人图谱。在 Human Data 系列的最后两期采访中,我非常荣幸地邀请到曾经出现在过这个图谱中的一位学者——韩磊博士进行深入对谈。
韩磊博士目前担任诺亦腾机器人(Noitom Robotics)联合创始人兼首席科学家。此前,他在腾讯 Robotics X 实验室 工作六年,担任具身智能负责人兼首席研究科学家。在此之前,他曾在腾讯人工智能实验室(Tencent AI Lab) 担任高级研究科学家。
在加入腾讯之前,韩磊曾任职于美国密西西比州立大学(Mississippi State University)基础科学系,担任助理研究教授(Assistant Research Professor)。他在北京大学获得博士学位,师从谢昆青教授,并先后在香港浸会大学(与张宇教授)和美国罗格斯大学(与张桐教授)从事博士后研究工作。他的研究兴趣在大规模统计机器学习、强化学习、优化、多任务学习以及它们在机器人学、游戏、自然语言处理、计算机视觉和生物信息学等领域的应用”
在这次正式访谈之前,我曾经和韩磊博士多次请教过强化学习与机器人结合的一些问题,非常欣赏他对技术思考的深度以及广度。这次访谈,我和韩磊博士请教了关于以Human data为代表的机器人数据问题,以及目前机器人算法路径等问题,非常非常推荐你也一起听一听,或读一读。
搜索小宇宙“ReSpark”收听播客。
播客:对话韩磊:强化学习与动捕数据——诺亦腾机器人的数据故事(上)(在微信公众号原文中收听)
查看原文目录
以下为本文目录
👇
1. 自我介绍
2. 怎么看强化学习近些年在各领域的发展
3. 创业为什么会选择机器人数据?
4. 如果视频数据有突破动捕数据还重要吗?
5. 3D模态对视频数据的重要性
6. 诺亦腾机器人给社区的贡献
7. 动捕数据和方案对比
8. 动捕+RL在解决操作任务上的机会
1. 自我介绍
我是诺亦腾机器人的首席科学家兼联合创始人,在创立公司之前,我在腾讯工作了八年,先后就职于 Tencent AI Lab 和 Tencent Robotics X 实验室。
早期我的研究方向主要是强化学习。那时候我们在做游戏 AI,尝试将强化学习应用到游戏场景中。那也是AlphaGo 刚出现的几年,我们主要研究博弈论、复杂对弈类游戏的策略空间与动作空间,开发能够在复杂游戏中达到超越人类水平的智能体。
大约在 2019 年至 2020 年 期间,我转入腾讯的机器人实验室,开始从事机器人运动控制相关研究。那个阶段整个行业的硬件还没有现在这么成熟,所以我们实验室也在做自研硬件,包括自制机器人平台和四足机器人。在这些自研平台上,我们将强化学习和模仿学习等算法技术结合,用于机器人控制与运动规划。
一直到今年上半年,我们观察到整个行业的发展速度显著加快。尤其是在具身智能领域,对数据的质量与多模态多样性的需求变得越来越迫切。我们意识到,未来机器人智能能力提升的核心瓶颈之一,不仅在算法,而在于如何获取和管理高质量的数据。
正因为如此,我和戴博士(戴若犁)一起创办了诺亦腾机器人(Noitom Robotics),希望能在高质量多模态数据采集与具身智能训练体系方面,探索并构建行业级的技术基础设施。
2. 怎么看强化学习近些年在各领域的发展
其实我最早接触强化学习是在 2015 到 2016 年左右。那时 AlphaGo 刚出来,对我冲击很大。我第一次真切感受到,有一种算法能够在没有明确数据集的情况下,仅凭“胜负”这样极简的 0/1 信号,就能学出超出人类经验的数据分布之外的策略。那时候我就对强化学习特别痴迷,也因此一路坚持做相关研究。到现在我仍然相信,RL 是实现 Human-Level 甚至 Superhuman 智能的一条必要技术路径。
不过,随着研究问题越来越复杂,尤其是进入真实世界和机器人领域后,我也越来越清楚,仅靠纯粹的 RL 是不够的。就像大语言模型一样,智能体要想在复杂环境中高效学习,必须先通过大规模数据训练积累大量“预备知识”,这样 RL 才能在其基础上更高效地迭代。这一点其实在游戏 AI 阶段我们就已经体会到了。
以围棋为例,2015、2016 年时大家认为围棋是极其复杂的游戏,但 AlphaZero 证明,通过纯强化学习的自博弈(Self-Play)也能解决它。回头看,这其实说明了围棋的 Action Space 仍然较小。但当问题升级到像 RTS 这种即时战略类游戏时,就不能再用 AlphaZero 那样“从零开始”的方式。必须先通过人类专家数据或 Replay 学到一个不错的 Warm Start 基础模型,再用 RL 继续优化。这样探索空间的效率会成倍提升,最终策略也会更优秀。
从 2020 年开始,我们就尝试把机器人与 AI、尤其是强化学习结合起来。那时我们开始使用一些仿真系统,把机器人放进模拟环境里训练,就像在玩一个“物理游戏”。我们当时的想法很直接:能不能像做 Game AI 那样来做机器人控制?
在仿真环境里,这种方式确实很快能学到不错的结果。比如 2018 年 Jason Peng(专访Xue Bin(Jason) Peng:探索人形机器人全身运控的通用控制器)的基于强化学习的人体动作控制技术路线是非常值得尊敬的工作,能够在虚拟环境里让角色模仿人类动作,对后续的虚拟角色和机器人控制有很大的影响力。但当我们进一步把模型从仿真转移到真实物理世界时,就发现问题远比想象复杂。
当时我们自己在做机器人硬件开发,因为那时市面上还没有太多成熟的消费级平台,所以我们一边摸硬件、一边摸算法,也体会到这两者的融合是一个需要长期迭代的过程。仿真训练很容易出成果,但要真正让机器人在现实中稳定执行,就会遇到很大的落差。这也让强化学习在机器人领域的挑战从“如何设计复杂策略空间”,变成了“如何解决 Sim2Real Gap”。
游戏是一个完全定义好的理想环境,训练和测试条件一致;但真实世界的物理环境充满不确定性。于是,这几年行业内出现了很多尝试,比如通过域随机化(Domain Randomization)来让仿真环境覆盖尽可能多的真实物理变化。这是一种有效的路径,但它的代价很高——随机化会让模型花大量时间去探索一些现实中根本不会遇到的情况。只有覆盖足够多的随机情境,模型才有可能在真实世界里工作。这种方法提升了鲁棒性,但大大降低了训练效率。
强化学习的核心问题在于探索效率。做游戏 AI 时我们就知道,如果完全从零开始学习,效率非常低。更高效的方式是先让模型聚焦在几个比较优秀的初始解上,再在此基础上继续做小范围的探索,这样效率会高得多。
当然,提前用监督学习去做 Warm Start 也会带来另一类问题——可能会限制最终策略空间,让模型陷入局部最优。但总体来看,一个更好的路径是:先训练出一个好的基础模型(Base Model)或初始策略,再接入强化学习去做微调和策略优化。这样不仅效率更高,也能在复杂的机器人系统中更稳健地实现持续提升。
3. 创业为什么会选择机器人数据?
我可以讲一下为什么觉得数据非常重要。按照我们前面讨论的思路继续往下推,如果想真正达到 human level 的智能水平,不需要达到 super human 的程度,就会发现这是一个越来越复杂的大模型或者 agent 的问题,也就是机器人的问题,它的整个空间都会变得越来越大,而高质量的数据是支撑这一切的核心。
当时我也做过一段时间的大语言模型,那个时候我看到大语言模型训练数据的体量和机器人相比,差距非常大,完全不是一个量级。因为语言模型的语料来源于互联网、Twitter、博客等,每天新增的文本数据量远远超过目前所有机器人领域汇总起来的全部数据量。那时我就意识到,只有当数据体量达到类似的规模,才有可能为机器人或 agent 的基础模型提供最基本的能力,更不用说在这个基础上再去做 SFT 或强化学习。
从整体来看,机器人领域确实发展很快,硬件在不断迭代,AI 算法在运动控制、基础操作等方面也能展现不错的结果,能让大家看到一些令人满意的 demo。但是从数据体量和第一性原则的角度来看,机器人的问题要比大语言模型复杂得多。机器人涉及的模态更多,不只是文本,还包括视频、图像、触觉以及其他模态,整个空间更大、更复杂。而现在机器人可用的数据量却比文本数据小得多。那时我就意识到,如果未来要真正解决机器人的关键问题,数据一定是核心,但目前现有的数据收集方式仍然存在问题。
过去主流的技术路线VLA主要是用遥操真机数据,大家普遍采用的方式是使用遥控器、手柄、主从臂或动捕系统,通过人来遥控机器人采集真机数据,最早包括Pi0等,整个领域内的主流数据收集方式都是这样。我们自己也做过大量这样的尝试,收集了很多遥操真机数据。在这个过程中,我们发现数据收集效率很低。人操控机器人时,操作方式并不符合人的自然习惯,需要扭头观察机器人的本体,有时因为遮挡看不清,还要调整姿势。整个过程中没有触觉反馈,视觉反馈也是间接的。效率非常低,比如一个人几秒钟就能完成的桌面操作,用机器人执行可能需要几十秒甚至一分钟以上。
第二个问题是,收集数据必须绑定具体的硬件本体。虽然不同本体之间的数据可能有一定的泛化能力,但我们做过实验,用混合不同本体的数据进行训练,发现更多的泛化仍停留在视觉理解阶段。而在真正执行层面,这些数据往往难以复用,甚至可能出现某一构型的数据会影响另一构型的执行能力。这样一来,数据收集既受效率限制,又受本体约束,要在规模上继续扩展非常困难。
继续思考后,我们看到 VLA 往后的发展方向可能有两条路。一种是通过遥操数据训练出一个基础模型,然后在真实机器人上接入强化学习,这是一条合理的技术路径,比如Dyna在做类似的事。另一种思路是使用更多模态的数据来解决问题。那回顾过去,我们在做locomotion的时候,不会像 VLA这样依赖遥操数据。训练locomotion研究者往往采用强化学习的方法,在仿真环境中进行大量随机化训练,从而让机器人学会运动控制。这条路径与 RL 结合得非常紧密,研究者会用动捕数据或视频数据进行模仿学习,从中抽取信息训练模型。
回到前面的问题。首先,数据是最重要的。高质量的数据能让机器人更接近真实本体,更高效地实现真机 demo。但要想进一步扩大数据规模,如果不想继续绑定硬件本体去收集数据,那么下一个可能的方式就是基于人类数据(Human Data)。这类数据的体量至少可以比之前高出一到两个数量级。
因为这类数据直接来自人类,不再绑定具体机器人本体,可以形成统一的数据格式。虽然每个采集者的体型不同,但他们都是人类,基本结构一致,不需要再考虑机器人自由度、关节或单独部件参数的差异。这样的人体数据格式更统一、更具泛化性。
我也知道动捕设备的成本较高,但诺亦腾机器人在该领域已有约十几年的经验,在批量部署和数据收集方面积累丰富,效率很高。我本人以前作为诺亦腾的客户,也采购过他们的光惯混合动捕设备,体验不错,所以我认为这件事完全可行。
现在我们将 human-centric 数据作为第二条主要技术路线。我们会在一个类似“动捕笼子”的环境中,尽可能使用惯性和光学结合的动捕系统。采集者佩戴轻便的追踪器,物体上安装小型光学标记,同时利用 RGB-D 第三视角相机、激光雷达等多模态传感器,采集人类动作、物体交互以及环境的三维模型。这类数据模态非常丰富。我们还会在采集者的手上配备柔性触觉手套,不影响操作习惯的情况下记录触觉信号。最终,我们得到的是一个以 human-centric 视角为核心的多模态数据体系。
与遥操真机数据相比,这种方法不再过度依赖机器人本体,数据规模可以扩展到原来的数十倍甚至上百倍。另一个优势是精度高,这套动捕系统中,人的手指与物体的空间贴合误差可以小于 1 毫米,达到亚毫米级精度。第三个优势是模态丰富,能够完整记录视觉、触觉、运动等信息。
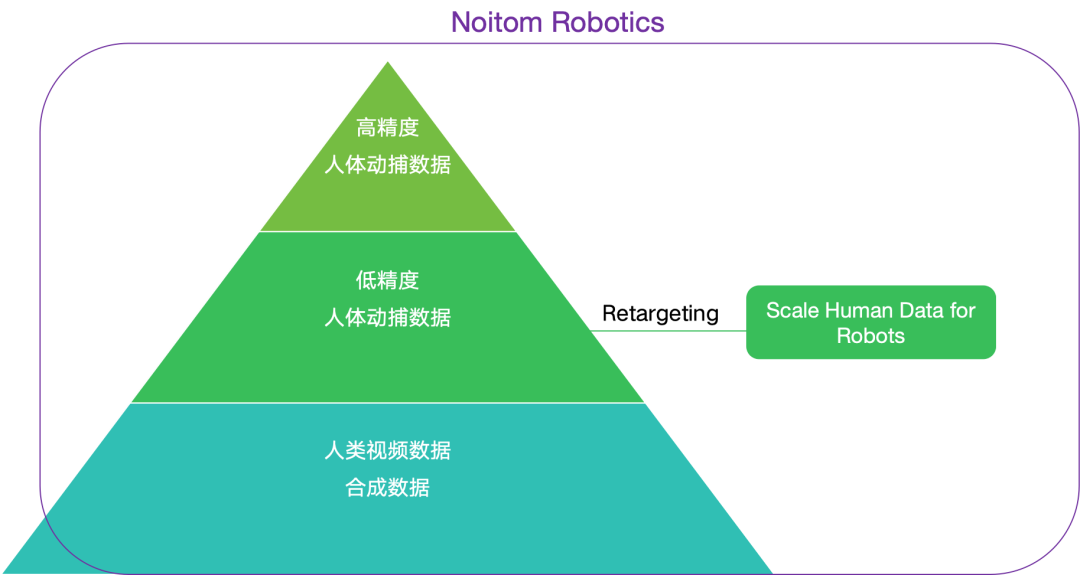
当然,这样的技术路线也带来额外的挑战。首先需要解决的是重定向(retargeting)问题。由于数据不再依附具体机器人本体,必须能将人类动作映射到不同机器人构型上。解决方式包括强化学习,通过模仿学习后再强化探索;也可以直接学习一个神经网络模型,把人类动作数据当作一种特定构型的机器人进行VLA的预训练,实现跨本体的训练。这样,人类就可以被视为统一的“机器人本体”。
除此之外,这类数据在其他领域也有广泛应用。例如在世界模型(world model)、三维视频生成、三维场景生成等研究中,它都能发挥作用。因为它完整记录了人类与环境交互的多模态信息,适用范围极广。
虽然这类 human-centric 数据模态丰富,但仍受限于可控环境。通常需要在实验室或封闭空间中搭建这样的采集系统,无法达到互联网级别的体量。因此,我们还在探索第三层数据模态——轻便型可穿戴设备数据。人可以佩戴手表、眼镜或帽子等装置,在不影响日常生活的情况下采集数据。这类设备能更贴近真实生活场景地记录人机交互,同时我们也会重视隐私与合规问题。
未来的进一步发展,可能是使用互联网中的第三视角视频,例如 YouTube、Twitter 等平台的视频数据,构建类似互联网文本那样的 Internet-scale 数据体系。
我们认为数据大体可以分为四层,从上到下形成一个金字塔结构。越往下,数据体量越大,模态越多,但与真实机器人本体的距离也越远。不同层的数据各有侧重和不足。
对于诺亦腾机器人而言,我们希望能整合不同模态、不同层级的数据,为整个行业提供高质量的数据基础,服务于各种技术路线。无论未来 AI 模型的发展方向如何变化,这些数据模态都能为不同路线提供支持。我们希望能把整个数据模态体系准备好,方便行业内的团队在此基础上探索多样化的 AI 模型路径。这正是我们正在做的事情。
4. 如果视频数据有突破动捕数据还重要吗?
这是一个非常关键的问题。先回答第一个问题,关于诺亦腾机器人是否会关注视频相关的数据,答案是肯定的。我们在采集以 human-centric 为主的数据时,一个非常重要的部分就是会使用头戴式设备,获取第一人称视角下的 ego-centric video 数据。
这类视频数据的特点是从人的视角出发,与互联网常见的第三视角视频或自由拍摄(freestyle)的视觉风格不同。它真正关注的是人眼前的操作场景,比如双手正在执行的动作,或者行走时看到的视野范围。我们会重点收集这些与操作和具身行为密切相关的第一视角视频数据。
此外,我们还会在视频基础上同步采集深度信息或鱼眼信息,以获得更广角、更完整的视觉输入。这些信息都是我们在视频数据采集中会重点获取的内容。
回到第二个问题,确实,计算机视觉(CV)的发展速度非常快。未来如果视频数据的处理做到足够好,它完全有可能在世界模型(world model)中实现对物理世界的重构与高精度预测。
但这里存在一个第一性原理层面的限制——信息维度的问题。简单来说,从二维视频中去估计三维信息,本身是信息缺失的。除非有多个视角,否则仅依靠单一 2D RGB 画面很难精准还原 3D 信息。举个例子,人如果闭上一只眼,只用单眼去看,会发现双手手指对齐都会出现误差,这说明单一视角无法完整捕捉空间深度信息。
因此,仅依靠二维视频数据无法提供精确的三维信息。视觉发展的方向,应该是结合多模态数据,通过将 2D 视频与 3D 结构化数据融合,为世界模型提供高质量输入,从而更准确地预测和重建三维世界。从原理上来说,信息的完整性决定了模型的能力。只有当视觉模型融合了多模态数据,包含足够丰富的三维物理世界信息,才能真正具备精准重建世界的能力。
或许在未来,human-centric 的视频数据最重要的使用方向之一,不仅仅是具身智能,也可能是服务于世界模型或计算机视觉模型。无论最终被用于哪个方向,它们的前提都是这些数据本身提供了最基础、最关键的模态信息来源。
5. 怎么看缺乏3D信息的世界模型
现在已经有一些非常优秀的研究工作在探索类似的方向。前一段时间,英伟达发布了名为 Cosmos 的世界模型,随后他们的团队以及其他研究者也陆续推出了一系列相关研究,其中有一个名为 DreamGen 的项目给我的启发特别大。
DreamGen 的核心思路,是利用一个基于视频生成的世界模型,在虚拟环境中不断进行推演。它生成的画面是机器人在操作场景中的动作过程,模型能够提前预测接下来的画面帧。研究人员会从这些生成的视频中提取出动作信息,再用这些数据去训练机器人行为策略。
这个思路非常典型:希望通过世界模型生成大量视频,让模型自己在“想象”的环境中学会一套行为规律。但从实验结果来看,这种方式的准确率仍然比直接用遥操作数据训练要低。这是可以理解的,因为它缺乏机器人在真实物理环境中与物体接触时的一些关键细节,例如三维空间的位置坐标、关节的姿态与速度等物理信息。
它的优势在于,可以显著提升多样性和泛化能力,因为模型可以在想象中模拟出各种不同的场景和动作。但它的不足在于,缺乏真实世界中精确的末端执行数据,也就是在实际动作执行阶段的物理精度。
这些工作非常有探索意义。随着研究的深入,人们会发现不同技术路线各有侧重:有的更注重多样性和想象能力,有的更关注精准控制。当未来真正出现能够同时包含三维物理信息的世界模型时,这条技术路线也会变得完全可行。前提仍然是要有足够大规模、足够高质量的数据集来支撑,这一点又回到了最核心的数据问题。
6. 诺亦腾机器人给社区的贡献
这是一个非常实际的问题。获取动捕数据的成本确实很高,而这也是当前许多实验室普遍面临的困难。针对这一点,动捕技术本身已经非常成熟,可以支持大规模、高效率的数据采集。近期的目标,是为整个社区提供数百小时到上千小时规模的高质量动作捕捉数据集。这将成为行业内少有的、覆盖范围广且精度高的大型数据资源。
作为对比,目前常见的数据集AMASS规模大多只有几十个小时,LAFAN的体量还会更低。正因为现有动捕数据普遍较少,研究者往往不得不从视频中提取动作信息来补充。从视频中抽取动作数据的方式虽然方便,用普通相机或手机即可完成,但在精度上存在明显的局限。相比之下,大规模、高精度的动捕数据能够在数据质量和可靠性上带来质的提升。
诺亦腾机器人计划提供的数据集将在体量上达到现有水平的数十倍甚至百倍,为研究人员和开发者提供足够丰富的高质量动捕数据。这项工作正在积极推进中。目前的一些数据集中会出现动作悬空、侧滑等问题,行走类动作占比较高,而高动态动作的比例偏低。这正是当前重点改进的方向之一。
在数据质量方面,已经进行了大量投入。通过在模型训练中不断验证和打磨数据,持续提升其精度与稳定性。目标不仅是提供数量充足的数据,更要确保其质量达到研究与应用的标准。在对数据进行充分利用和验证后,将以研究者的标准确保数据的高质量与可用性,再在此基础上扩大规模,为更多使用者提供可靠的数据资源。
8. 诺亦腾机器人动捕数据采集的优势
诺亦腾在动捕设备领域已有十余年的技术积累,在设备技术细节、采集成本控制以及大规模数据采集的运营能力方面,具备显著优势。这套系统的灵活性也非常高。诺亦腾采用的是光学与惯性相结合的混合式动捕技术,这是目前全球范围内极少数能够实现高精度与高连续性兼顾的方案。
纯光学动捕的优点是精度高,但在遇到遮挡或高动态动作时容易出现丢帧;惯性动捕虽然能保持连续性,但在位置精度上会存在偏差。通过将两种技术融合,系统能够在保证高精度的同时维持连续性,避免丢帧问题。这套高质量的捕捉硬件设备和数据融合算法是其中的核心技术。
此外,在动捕数据采集过程中,还可以灵活组合多种感知模态。采集人员在进行动作捕捉的同时,可佩戴其他传感设备,例如头戴式视觉系统或手部触觉传感器,从而同步采集视觉、触觉等多模态信息。这种多模态组合的方式,使得数据在模态丰富度、采集精度以及整体效率方面都能保持较高水准。这正是目前最具优势、最擅长开展的工作方向之一。
9. 动捕+RL在解决操作任务上的机会
我认为这件事情一定会有机会,而且操作任务真正能够落地时,强化学习这一环节是必不可少的。这始终是一条值得坚持的技术路线。
现在,无论使用哪种类型的数据,大家基本都能先训练出一个效果还不错的基础模型。接下来要怎么做,就变得非常关键。有一部分技术路线选择直接在真实机器人上进行强化学习,也就是在人参与的情况下完成整个训练过程。这种方式通常针对特定任务进行优化,可以把某些任务的成功率提高到九成以上。比如在叠衣服这样的案例中,就采用了强化学习的方式,通过设置评估函数来不断迭代策略。
这种方法的优势很明显,但问题在于需要大量人力参与整个训练过程。无论从人力投入还是规模化角度来看,成本都非常高,挑战也很大。
另一种做法与运动控制相似,在仿真环境中进行反复训练。仿真的好处是可以不受限制地探索,代价只是算力。这种方法同样有机会,但也存在自己的难点。运动控制的问题相对简单,因为即使地形复杂,环境本身也是静态的,只有机器人在其中运动,机器人的参数与仿真模型也能做到非常接近,所以训练出来的策略偏差很小。
而操作任务则不同,它需要与可移动、带有物理属性的物体交互。碰撞会成为一个很大的问题。因为操作过程中不只是面对静止不动的物体,还需要与会移动、具备动力学特性的物体打交道,这种接触和动态变化发生的概率非常高,所以在仿真中进行操作类强化学习时难度更大,sim2real gap也更高。
还有一些研究正在探索新的方式。例如,有团队直接使用以人为中心的数据,比如动捕数据,不直接做强化学习,而是选取人手动作中的关键点,将其映射到机器人手部的对应关键点上。然后把机器人的遥操作数据与动捕数据结合,一边是人的手,一边是机器人的手,先建立两者的对应关系,再把这两类数据合并进行联合训练。
通过这种方式,可以把人类的动作数据融入操作策略中,经过联合训练后,动捕数据能够融合进模型的策略部分。这样不仅能引入大量人类动作数据,还能在此基础上形成一个具备基础能力的模型,为后续的强化学习提供起点。
这是目前能够看到、并且非常值得探索的一些方向,尤其是在操作场景中,都是未来可能进一步发展的技术路径。