从 2025 年 6 月开始酝酿的Human Data系列,历时半年,终于迎来总结篇。结合我们 2024 年的Robota DataEP10 Robot Data第一季访谈总结系列与2025年的Human Data系列,我整理出一份“Human Data数据金字塔”。
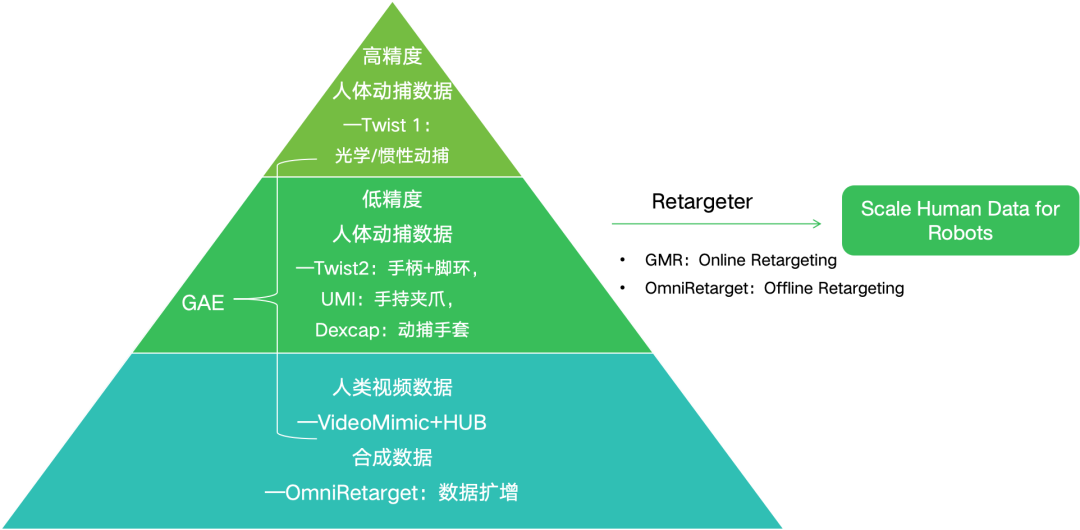
金字塔的顶层是基于光学与惯性动捕的高精度人体数据(Human Data EP01-MoCap:TWIST专访罗正宜:解密PHC——人形机器人通用控制器),精度可达亚毫米级。它们采集难度大、成本高,却是训练人形机器人全身运控base-model最优质的数据源。
金字塔的中层来自各类低精度动捕设备,如 VR 手柄+脚环(Human Data EP07—MoCap:Twist2)、UMI(以夹爪方式采集人手操作数据,EP2对话迟宬、许臻佳:UMI——机器人训练的物理API)、Dexcap(以五指手套方式采集手部动作,EP4对话王辰:MimicPlay & DexCap——如何利用人类视频和人体动捕数据进行机器人训练)等。这类数据采集难度低、可规模化,精度一般在厘米级。
金字塔的底层则是规模庞大的视频数据及合成数据(Human Data EP04—Video:VideoMimicHuman Data EP05—Video:HUB,Human Data EP08:OmniRetarget),这类数据量大,但存在精度低,缺乏3D信息(视频),存在Sim2Real Gap(合成数据)等问题。
在这三类人体动作数据之上,更先进的重定向方法——如 OmniRetarget——能够解决传统 retargeting 的诸多问题,大幅提升机器人与物体、与环境之间交互重定向的质量与效率。
通过融合金字塔各个层级的人体动作数据(如GAE),利用高效的Retargeting方法(如OmniRetarget),丰富的人类数据有机会真正破解机器人数据稀缺这一瓶颈。这篇总结文章,将Human Data系列采访关于数据源选择的核心观点摘取出来,也大致形成了Whole-body Control这条路线上关于数据问题的观点摘录。
查看原文目录
以下为本文目录
👇
1. Human Data EP01-MoCap:TWIST
3. Human Data EP03—MoCap:Exbody2
4. Human Data EP04—Video:VideoMimic
6. Human Data EP06—Mocap+Video:GAE
1. Human Data EP01-MoCap:TWIST
获取人体数据大概有三种主要方式。第一种是基于相机的视频或图像,比如互联网视频,或者通过图像进行姿态估计。这种方式最大的优点就是便携、便宜、容易获取,但缺点也很明显,就是精度太差,质量最差。第二种是 VR,它比相机贵一些,普通人也不太会买,但它能提供更高质量的上半身数据,缺陷是没有下半身数据。不过有些研究通过让机器人补偿缺失的部分,或者加一些额外输入,比如遥控器来提供下半身位移,从而部分解决这个问题。第三种就是动捕设备,它的优点是精度最高、质量最好,但缺点就是极其昂贵,不具备便携性。
这里有一个很明显的 trade-off:设备越便携,数据质量就越差;设备越不便携,数据就越好。大家都想要更多更好的数据,因为像大模型成功的秘诀就是 scaling up。但要想规模化,就得依赖便携又便宜的系统,否则几十万甚至上百万的设备没人用得起。
所以我尝试过 VR 和基于单目估计的方法,但实际下来感觉都还不足以提供高质量的全身动捕,尤其是在 root tracking 上问题很大。(Root tracking,就是人在世界坐标系里的整体位置和移动,比如从 A 点走到 B 点。)如果只用一两个相机,是很难实时准确地提供全身在空间中的移动轨迹的,最多只能在静止状态下获取上半身的动作。
因此,基于相机的方案几乎可以排除了,只剩 VR 和动捕。近期也有不少工作尝试用 VR 做全身控制,比如 vision pro 的应用就是只给手和头的 tracking 数据,然后让策略去学缺失的下半身动作。结果证明是可行的,但问题是下半身会出现不稳定或持续调整的情况,比如机器人明明走到了目标点,但它的下半身动作还在微调,因为它缺乏真实的下半身输入。
有的研究会额外用遥控器提供 base 的移动输入,有的则通过对齐头部的全局 tracking 来巧妙绕开问题。无论哪种方式,都说明 VR 是可用的,但下半身精细的动作,比如下蹲、跨步、马步等,几乎做不到。
相比之下,我们现在坚持用完整的全身数据来做开发,好处就是一切都能做,但坏处也非常明显,就是只能依赖动捕。动捕既不便携,又昂贵,即使实验室有,使用起来也不如 VR 那么方便。所以我认为未来的关键是如何让这些系统更便携。
2. Human Data EP02—MoCap:GMT
现在开源的数据集中,最大的就是AMASS。我们之所以选择AMASS,是因为它覆盖了各种各样的技能,但在质量上可能有一些欠缺。其实现在的一个概念是,我们想做一个行为层面的 foundation model,也就是说,希望它能执行所有各种各样的动作,包括通过生成模型生成的动作,然后在模型里进行 tracking。为了做到这一点,训练时可能需要非常大的数据集,尽量把各种动作都覆盖。如果我们能有一个高质量、由人类采集的新数据集,我觉得对整体效果会有很大帮助。
3. Human Data EP03—MoCap:Exbody2
从更长远的角度来看,我觉得我们现在仍然缺乏足够多样的动捕数据。现有的数据大多是“人本身的动作”,而真正让人形机器人具备智能行为,还需要包含人与物体交互、人与场景交互 的数据。这类数据能让模型理解动作的意图和目标,而不仅仅是模仿动作轨迹。未来更丰富、更具语义层次的动捕数据集,应该是推动整个人形机器人控制能力进一步提升的关键。
4. Human Data EP04—Video:VideoMimic
我们会基于一些通过动捕采集的高质量人体运动数据进行预训练。虽然这类数据规模不大,但质量很高,所以我们先用这些“少而精”的数据去训练一个 base policy,让它具备较强的初始运动能力。
5. Human Data EP05—Video:HUB
至于视频是否能完全替代动捕数据,现在来看仍有一定挑战。视频数据提取的误差相比动捕设备还是略大。但从长远来看,视频数据有巨大潜力,因为网络上有海量人类动作视频可用,比如健身博主、体操运动员等,只要方法不断优化,可以做为传统动捕数据的补充。
6. Human Data EP06—Mocap+Video:GAE
所以我们的模型必须具备兼容性——既能执行高精度动捕数据输入的轨迹,也能执行来自其他方式的人类动作参考轨迹。
我们还发现,如果训练只使用动捕数据,而测试时使用视频估计得到的轨迹,就会出现明显的 domain gap。所以我们意识到,训练阶段就必须包含多种数据来源——不仅要覆盖更多动作类型,还要囊括不同的采集方式。
7. Human Data EP07—MoCap:Twist2
理论上来说,确实可以在没有高精度动捕数据的情况下,直接使用低精度 VR 动作数据进行训练或操作,是“有可能”的。
不过我们在实际做的时候,会采用一种折中的方式。我们主要还是用高精度动捕数据来训练我们的模型和控制器,大概有 99% 的数据都来自高精度动捕系统,其中也包括了 Twist 1 采集的数据。这些数据提供了非常稳定的时空一致性和骨骼姿态的精度,是模型学习动作模式和控制策略的核心基础。
与此同时,我们也会用大约 1% 的低精度数据来让模型去适应这部分“噪声更大”的输入,尤其是针对 VR 系统中精度不足的部位,例如下半身(腿、腰)。这些区域的漂移较明显,因此我们会在高精度数据的基础上,混合少量低精度数据,帮助模型在训练阶段就学会一定的鲁棒性,在部署到低精度系统上时能自动适应。
总结来说,就是一种 “高精度为主、低精度补充”的混合训练策略。它既保留了高精度动捕的可靠性,又让模型具备在低精度系统中运行的适应性。
8. Human Data EP08:OmniRetarget
我们的数据来源主要包括两个动捕数据集:LAFAN 和 OMOMO,以及我们自行采集的动捕数据。此外,我们还有一位合作者亲自录制了大量示范,例如攀爬不同尺寸的箱子等动作,这些也构成了我们数据的一部分。
现有的开源数据集中,涉及与环境进行复杂交互的示范其实并不多。以我们最终的示例为例:机器人需要先搬起一把椅子,再踩上椅子,利用椅子作为支撑攀上更高的平台,随后再从平台跳下。像这样同时涉及物体交互与环境交互的动作数据,在现有公开数据集中非常稀缺。
我对遥操作其实有一些自己的看法。我认为真实的实体数据当然是需要的,但遥操作本身仍存在不少问题。例如延迟、人与机器人之间的形体差异,以及缺乏触觉反馈——人在操控机器人时,机器人“感觉”到的触觉,人类无法同步感知。因此中间始终存在一层差距。此外,操作者本人的动作可能会抖动,导致记录下来的轨迹和最终得到的 policy 也会出现抖动等问题。
但如果我们能在这些遥操作轨迹上再加一些优化方法,使轨迹变得更优,也许能够进一步提高数据的质量。另一个局限在于,有些任务并不现实依靠遥操作来完成——比如让操作者直接遥控机器人做后空翻,这显然不太可行。如果我们希望获得某些超人类的能力,就必须依赖遥操作之外的其他方法。
就我个人而言,我更偏好使用 human data。人类的数据量大,而且动作通常更自然。
拿自动驾驶和机器人做对比的话,对于自动驾驶:汽车从设计之初就是给人开的,因此人的驾驶数据天然适合训练驾驶模型。但机器人并不是为了“被人操控”而设计的,而是为了完成一些人类日常会做的任务。如果某件事人类平时都很少做,那么让机器人专门去做这件事,应用价值也未必高。
因此在人类能够熟练完成的任务上,人类示范数据对于机器人来说是最有价值的资源之一。