Human Data系列前三期我们都聚焦于利用人体动捕数据做人形机器人控制数据源的工作,分别是Human Data EP01-MoCap:TWIST,Human Data EP02—MoCap:GMT和Human Data EP03—MoCap:Exbody2。这一期,我们来看一个依托视频数据做人形机器人运动控制数据源的工作——VideoMimic。
VideoMimic是一个可以让人形机器人通过用手机随手拍摄的人体视频学习动作的方法。这篇工作的一作之一是章俊一,他目前是UC Berkeley在读博士,导师是 Trevor Darrell 教授,本科毕业于上海交通大学。这篇访谈有关于基于2D视频重建三维人体动态点云方法的介绍,有关于人体视频数据和高精度动捕数据金字塔的思考,也有关于人形机器人全身运动控制在RL还是IL方法选择上的探讨,非常有启发,推荐阅读。
查看原文目录
以下为本文目录
👇
1. VideoMimic的核心思想
2. VideoMimic 方法介绍
第一部分:Human Motion三维重建
Human Motion三维重建方法
Human Motion三维重建方法
关于视频数据
MonST3R如何从普通视频重建出动态点云
第二部分 Humanoid Motion训练
3. 关于动捕数据和视频数据使用
4. 关于视频数据和动捕数据的金字塔
5. 利用人类视频的相关工作对比
6. 关于人类视频数据和动捕数据优劣对比
1. VideoMimic的核心思想
我们想要解决的核心问题,其实就是实现一个具有泛化能力的全身运动控制系统。所谓泛化,一方面是方法上的泛化,也就是在网络设计、训练方式、奖励设计上都能够具备通用性;另一方面是任务上的泛化,也就是机器人能够在不同的地形和环境下实现稳定的运动,而不需要针对每一个任务单独设计。
我们具体要解决的任务是人形机器人的运动,特别是在复杂地形下的人体运动控制。为了实现这一点,我们最开始是基于 DeepMimic 这一系列思路出发的,也就是用强化学习的方式在仿真环境中模仿人类的动作。但是在这种方法中存在几个明显的问题:
第一个问题是它对地形的鲁棒性不够。如果应用到真实或复杂环境中,比如上坡、下坡、楼梯这样的场景,它往往表现不稳定,需要针对具体情况重新调整。
第二个问题是它在任务上的可扩展性有限。比如你想让机器人实现上楼或下楼的动作,就需要去重新设计相应的奖励函数,手动去调参数,这在方法层面上就不够 generalizable。
第三个问题是它对数据依赖比较强。DeepMimic的思路中,不同动作往往需要对应不同的source motion,而这些 source motion 数据并不容易获得。
基于这些问题,我们希望能够在两个方向上改进。
一个是从任务角度出发,让模型可以从任意视频(casual video)中直接得到人类的动作,通过视频生成对应的人体运动,从而摆脱对固定动捕数据的依赖。
另一个是从方法角度出发,尽量减少手工设计 reward 的部分,通过让网络自动去学习,从而让整个训练过程更加通用。
整体来说,VideoMimic这项工作主要是希望模型既能从任意视频中获得运动信息,又能通过减少人工干预,在方法上更具普适性。比如说,如果训练数据中只有“上楼梯”的动作,而没有“下楼梯”的动作,那么在测试时,以往的模型往往就无法完成下楼的任务。换句话说,每一种动作都需要有相应的人类参考(source motion),否则模型无法学习到对应的技能。
我们在自己的方法中发现,这个问题(缺少泛化性)可以在一定程度上被缓解。我们的模型在训练时做了更大规模的覆盖,在训练过程中加入了几类典型场景,比如上楼梯、下楼梯、坐椅子等动作。当模型在测试时遇到一些训练中未见过的场景,比如跨过门槛、跨上一个台阶、走过松软的土坡或不平地面,它依然能表现出比较强的泛化能力。也就是说,通过在训练中覆盖多样化的运动模式,模型能够学到一种更加通用的身体协调策略,从而在新环境中自适应地应对不同地形。
2. VideoMimic 方法介绍
第一部分:Human Motion三维重建
Human Motion三维重建方法
我们这个方法其实是一个完整的系统,包括从输入视频到最后得到可以在仿真环境中使用的动作的可以在仿真环境中使用的全过程。输入非常简单,就是用手机拍一段有人的视频,比如上楼梯、坐在椅子上、躺在床上,随便拍一段都可以。
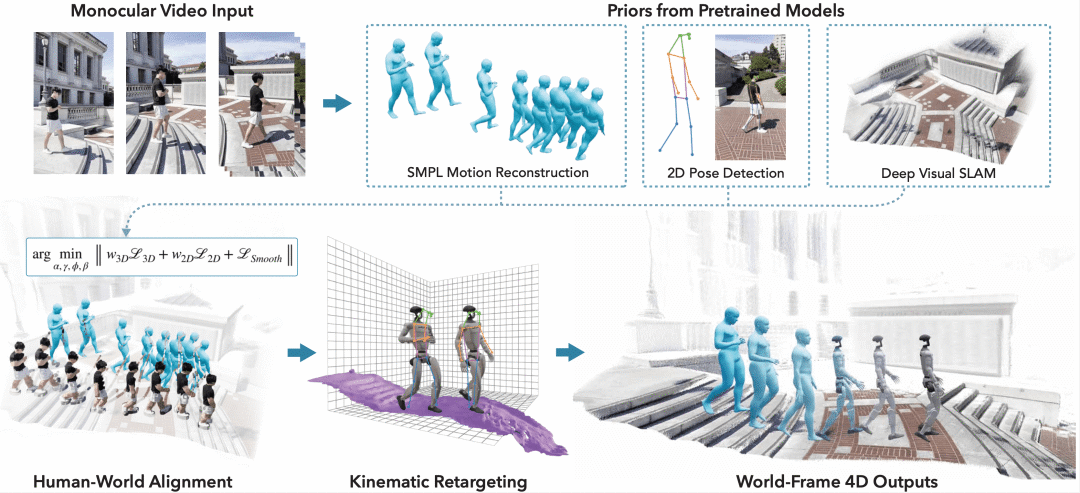
第一步,我们会把这个视频转成三维信息。这一步是基于我去年10月份做的一个工作,叫
MonST3R: A Simple Approach for Estimating Geometry in the Presence of Motion,是关于动态三维视觉(dynamic 3D vision)的。这个方法可以把任何视频,包括手机随手拍的、直播里的或者 YouTube 上的视频,都转换成一个三维点云(3D point cloud)。通过这个过程,我们能得到场景的三维点云,同时也能得到视频里人的三维运动点云。
第二步,我们会结合现有的一些三维人体运动估计的方法。它们主要是给定一张图片或一段视频,去估计出人体的姿态,但传统方法预测出来的人体动作是相对于相机坐标系的。如果相机在动,它的预测结果也不会跟着动。我们的方法结合了前面提到的动态场景重建,可以得到人在世界坐标系下的三维运动。也就是说,不管相机动不动,我们都能恢复出这个人在世界坐标系下的姿态和运动轨迹。
对于人体部分,我们就是把人体运动估计得到的结果和 MonST3R输出的动态三维人体点结合起来,得到在世界坐标系下的人体三维运动。
第三步,我们同时处理环境的三维重建。我们重建的点云里既有人的点云,也有环境的点云。我们会对环境部分做分割,去掉人体的点,把剩下的环境点聚合起来,然后生成一个网格模型。这一步是为了之后在仿真中使用,因为我们需要让环境和人体之间能够正确匹配接触,所以要先把环境 mesh 构建出来。
最后一步,我们会做一个重力方向的对齐(gravity alignment),让重建出来的人体和环境都在一个统一的重力坐标系下。这样我们之后就能直接把结果放进 simulator 里去运行。
整个流程下来,输入是一个随手拍的视频,输出是这个视频里环境的 mesh,以及人在世界坐标系下的三维运动。
关于视频数据
我们用的视频其实不是必须要为了这个工作特意去拍的,有些随便从互联网上找的视频也可以用。在论文里的real-to-sim部分的示例视频就是我们从网上随便扒下来的,一个人在做类似跑酷的动作,那段视频左下角有 Instagram 的标识。当然目前对于视频也有一定要求,比如人体不能被遮挡太多,以及环境要足够清晰。
我们整个系统用的是单目视频,就是普通的 2D 视频,不是双目视觉或者 RGB-D 数据。也就是说,只要是用手机拍的普通视频就行,不需要深度信息。我们强调这个,是因为很多以前的工作都是用双目摄像头或者 RGB-D 相机来采集,而我们的方法只需要一个 2D 视频输入。
在实现上,我们的方法分两步。第一步是从视频生成动态点云。这一步主要是通过MonST3R或者最近的MegaSaM来实现的。通过这一步,我们可以从视频得到动态的三维点云信息。
第二步是从点云往下分成两个分支去处理:一个分支得到人在世界坐标系下的三维运动,另一个分支得到环境的网格。人体的重建主要是用 HMR2(Human Mesh Recovery v2)来做的,环境的网格我们用的是 NKSR 来做 mesh reconstruction。
HMR2 能从 2D 图像 / 视频中恢复 3D 人体骨架 + 网格模型(SMPL 参数)。HMR2 是在早期 HMR(Kanazawa et al., CVPR 2018) 的基础上改进的版本。HMR 是第一个将端到端神经网络与SMPL人体参数模型结合,实现从图像直接回归人体3D网格的框架。
NKSR(Neural Kernel Surface Reconstruction)是一种基于神经核方法的3D 表面重建模型。它能从稀疏或噪声较大的点云中快速重建出高精度、连续的三维表面,具有高效、快速、精度高的特点,常用于机器人感知、3D 扫描和具身智能的环境建模。
SMPL 是 Skinned Multi-Person Linear model 的缩写,指一种常用的三维人体参数化模型。它通过少量参数就能表示人体的 姿态(pose) 和 形状(shape),可生成可动画的 3D 人体网格。
这些人体姿态估计的方法现在都比较成熟,但最关键的其实是第一步,就是从一个随手拍的动态视频中去重建出动态点云。这一步在去年年底才有比较大的突破。
MonST3R如何从普通视频重建出动态点云
从一个随意拍摄的视频中重建出动态点云,这个问题在计算机视觉领域有很长的研究历史。静态三维重建大概已经有四、五十年的发展,而动态重建至少也有二十多年。最早在 2022 年,有一篇名为Particle Structure from Motion 的工作已经能实现与MonST3R类似的效果,但这类方法的主要问题是基于优化(optimization-based),因此效率很低。比如一段一到两秒的视频,可能需要半小时才能处理完成,这样的方式无法用于大规模数据处理管线,实用性较差。
MonST3R的核心是基于 DUSt3R 这一方向进行的扩展。DUSt3R 属于静态几何估计(geometry estimation)领域中的开放性研究之一,它首次用数据驱动的方式在三维重建问题取得了非常好的效果。在这之前,绝大多数几何估计仍依赖传统的 Structure from Motion(SfM) 体系。MonST3R引入并完善了这一套数据驱动的范式,使得动态三维重建可以脱离纯优化的流程,用深度学习模型直接学习时空几何关系。这在方法上是一种突破,也开启了用大规模数据学习动态结构的可能。
DUSt3R(Dual-Stream 3D Reconstruction)是一种从多张图像中重建三维结构的模型。它通过双流神经网络提取图像特征,可直接恢复相机姿态、深度和点云,具备高精度、快速、泛化强等特点,常用于机器人视觉和 3D 场景重建。
之后,像MegaSaM 以及一些基于 VGGT 的方法,都在这个方向上进一步推进。例如 MegaSaM 结合了传统的 Bundle Adjustment(BA) 优化策略,与数据驱动的训练方式结合,进一步提升了重建性能。
MegaSaM 是一种从视频中重建三维结构和相机运动的视觉系统。它能在动态、复杂场景下高效恢复相机姿态和深度信息,比传统 SfM 或 SLAM 方法更快、更稳健。
VGGT(Visual Geometry Grounded Transformer)是一种基于 Transformer 的视觉模型,可从单张或多张图像直接预测相机姿态、深度图和三维结构。它无需传统特征匹配或 SfM流程,能端到端学习三维几何,用于机器人感知和场景重建。
SfM 是 Structure from Motion 的缩写,意为运动恢复结构。它是一种计算机视觉技术,用于从多张不同视角的二维图像中重建三维场景结构并估计相机运动轨迹。
MonST3R的主要贡献在于:相比两年前的优化式方法,它的重建质量更好,效率也有明显提升。过去一两秒的视频需要 30 分钟处理,而MonST3R可以在一到两分钟内完成。虽然仍不算特别快,但相比之前的速度提升了一个数量级,可以支持通过自动化的调度系统实现大规模数据生成,这在以往的优化方法中是做不到的。
关于视频到动态点云的突破,最关键的变化并不是算力或硬件的提升,而是研究范式的转变。过去很长一段时间里,三维重建(尤其是动态场景的 3D geometry estimation)主要依赖一些手工设计或基于优化 的方法,比如 COLMAP 以及 Structure from Motion 等。这些方法往往不够鲁棒,而且效率较低,难以应用在大规模数据上。
真正的突破来自研究者开始采用一种数据驱动的方式来解决这一问题。当大家从这种新的范式出发,用深度学习去建模和估计动态三维结构时,问题的可扩展性和泛化能力都得到了极大提升。这种方法让动态点云重建不再依赖繁琐的手工调参,而是通过大量数据学习出隐含的几何规律,从而让“随意拍的视频到动态三维重建”成为现实。
第二部分 Humanoid Motion训练
在我们前面的讨论中,其实只讲到人体运动(human motion)这一部分。但在得到人体运动数据之后,还需要一个 retargeting 的过程,把得到的人类动作转化为可以在仿真中由机器人执行的人形机器人运动(humanoid motion)。如果要让整个系统最终可用,我们必须先将human motion重定向为humanoid motion,然后再进入后续的训练阶段。
训练的第一步,我们会基于一些通过动捕采集的高质量人体运动数据进行预训练。虽然这类数据规模不大,但质量很高,所以我们先用这些“少而精”的数据去训练一个 base policy,让它具备较强的初始运动能力。
第二步,我们会针对自己的数据,也就是前面从视频中获得的 humanoid motion 和环境 mesh,进行 per-sequence 训练。这一步我们称为 environment-aware policy training。在这一阶段,我们同时利用人体动作和环境信息,从环境中采样观测。训练中使用的主要观测是 height map(高度图),当然也可以加入视觉反馈。在这个阶段,我们用强化学习让 policy 在不同环境下模仿已有的人体动作,这一点与 DeepMimic 类似,但不同之处在于我们额外加入了来自重建环境的高度图作为输入。
第三步是 蒸馏(distillation)。在第二阶段中,我们针对每条动作序列都训练出一个对应的 teacher policy,而在部署时我们并不希望维护多个模型。因此我们把这些针对具体动作的 teacher policy 蒸馏为一个统一的 student policy。蒸馏时我们不再用具体的关节姿态作为条件输入,而是只使用 root direction进行控制。
到这一步,模型就能够在同一个 policy 下实现多种技能。我们可以通过一个简单的手柄输入前、后、左、右方向控制,机器人会根据环境自动选择合适的动作。例如,当我输入“前进”时,如果前方是平地,它会走路;如果前方有楼梯,它会上楼梯或下楼梯;如果身后有凳子,我输入“后退”,它会识别到有椅子并自动坐下。
最后,我们在这一步的基础上又加了一次 RL 微调,主要基于之前的 root policy 做进一步强化训练,以提升最终的性能和稳定性。这一过程也属于整个 sim-to-real 的关键环节。
3. 关于动捕数据和视频数据使用
首先,关于 pre-training 阶段人体动捕数据(mocap data) 的使用,我们在这里用的其实只是几十条高质量的动捕数据。虽然数量不多,但这些数据非常精确、干净,能帮助我们在训练初期快速建立一个强大的 base model。这有点类似现在训练大模型时先做的 SFT——不是让模型从零开始学,而是先让它具备基本的动作理解和控制能力。通过这样一个小规模但高质量的预训练过程,模型就能形成对人类运动规律的基础认知,比如“如果我是一个人,我大概应该怎么动”。
第二个方面是动捕数据和视频数据的结合。动捕数据主要用于模型的“启动”和对齐,让模型先掌握规范的人体动作空间。而从视频中获得的数据,则包含了更丰富的姿态变化、环境交互和实际场景的信息。换句话说,动捕数据提供了高精度的人体动作模板,而视频数据则扩展了动作的多样性和泛化能力。我们在 pre-training 阶段先用动捕数据训练出基础 policy,随后在从视频得到的人体运动和环境 mesh 上进行进一步的训练与对齐,让模型能够在复杂环境中表现得更自然、更贴近现实。
我们的方法里虽然没有直接用到动捕数据,但是使用了本体厂商提供的一整套数据和仿真体系。当时 Unitree 在发布 G1 相关资源时,开放了一部分经过 retargeting 的动捕数据,也就是他们把人类动捕数据(主要来自 AMASS 数据集的一部分)映射到了自己的人形机器人模型上,生成了可以在仿真环境中直接使用的机器人动作序列。
我们拿到的就是他们release 后的结果数据,然后在这个基础上进行预训练policy。也就是说,Unitree 提供了底层的硬件模型 + 仿真模型+ retargeted human motion 数据,而我们在他们提供的这套体系上去做进一步的算法研究与训练。可以理解为,本体厂商完成了动捕数据到机器人动作的第一步转换(retargeting),我们接着在这套转换结果上构建和优化自己的 policy。
当时 Unitree 提供的其实只有一部分经过处理的数据,我们首先是用这些数据去训练一个 base model。有了这个 base model 之后,我们再训练一个 teacher policy。这个 teacher policy 就是基于这些 retargeting 数据进行的第一阶段预训练,也就是我们整个训练流程的起点。
在训练 teacher policy 的过程中,我们使用的条件或目标是 joint position,也就是每个关节的位置。因为在仿真或训练阶段,我们可以准确地知道每个关节的角度和位置,所以可以用这些精确的姿态信息去指导模型学习控制策略。
但在真正部署时,我们不可能实时知道机器人每个关节的具体位置。此时我们能提供的控制信号就比较粗糙,比如通过一个手柄给出“前进、后退、左转、右转”这样的方向输入,也就是更高层次的控制指令。
所以从 teacher policy 到最终部署的模型之间,我们加入了一个蒸馏过程。这个过程的目标是把原来依赖关节角信息的 policy 蒸馏成一个只依赖整体方向信息的 policy。换句话说,我们让模型从学习“如何精确控制每个关节”过渡到“根据整体方向自主生成合适的身体动作”。
4. 关于视频数据和动捕数据的金字塔
当前方法仍有改进空间;在调试中我引入了不同的 cost function,例如 contact 相关项以及 collison-free 之类的基础损失,用于稳定约束。该方向有一定研究历史,早期多在图形学/动画中做角色动画;近一两年 retargeting 仍在发展,预期 gap 会逐渐缩小,但不可能完全消失。
从 human video 转换而来的数据会给最终部署的 policy 带来一定噪声;即便 retargeting 的 gap 变小,也难以完美复刻人类动作,毕竟形体不同。优势在于可扩展性:从 YouTube 等获取视频即可转成训练数据;而动捕需要穿戴设备、受限于场地,难以覆盖真实世界中人会执行的全部任务,且不够自然。
我更倾向于一个数据层级:底层是规模巨大的但带噪的 human video;其上是常规人体动捕捕数据;顶部是极高质量的小规模人体动捕数据。训练策略是:先用大量但低精度的 video 数据让模型覆盖非常多的任务,再用小而精的高质量数据做后训练(例如 SFT 或 RLHF),兼顾广覆盖与高精度。这个趋势与语言模型类似:预训练阶段难以保证数据极其干净,但在后期的 SFT/RLHF中通过精心策划的数据提升推理与精度,机器人控制同理——先获得足够 generalize 的 locomotion policy,再通过高质量微调获得足够的 precision。
5. 利用人类视频的相关工作对比
在当前的研究中,人类视频数据在机器人领域的使用方式其实可以分成几种类型,不同任务对应的处理方法也不太一样。
我们之前在伯克利也做过一个项目,叫 ARM4R,同样是基于 dynamic 3D vision 的思路,用人类视频进行训练,不过是应用在操作任务上的。当时我们想探究的问题是:如果我们有一个 video-based 的 base model,那么在进行下游任务时,怎样的训练方式能让模型表现得更好。
最早在大概 2021 或 2022 年,伯克利的一些工作(例如 IFT 那个方向)提出了一种方法:通过 MAE(Masked Autoencoder) 的方式,用视频训练一个 pre-trained model。具体来说,就是把视频帧的一部分进行 mask,让模型去预测被遮挡的部分,从而学到通用的视觉与时空表征。这个 pre-trained model 之后可以用于下游的动作控制任务。
我们最近的工作也是沿着这个方向做的 video training,但有一些不同。我们的方法更接近 ATMEP1对话高阳、汶川:如何利用互联网人类视频训练机器人大模型(ATM—RSS 2024满分论文) 的思路,不过我们是在动态三维空间中进行的。我们会先对视频做预处理,得到它的 dynamic 3D trajectory。然后在预训练阶段,我们的模型是以 text 作为条件输入,去预测未来的三维运动轨迹。在 fine-tuning 阶段,我们让同一个模型输出的不是未来的三维点轨迹,而是机器人关节轨迹。
通过这种方式,我们可以让视频训练出来的模型在 domain gap上更小,fine-tuning 所需的调整更少,从而更高效地利用视频数据来进行 locomotion control。
不过,这样的做法也有一个明显的问题:这种预训练出来的模型无法直接拿来用,必须经过 fine-tuning 才能在具体任务中表现良好。而 fine-tuning 这一步通常需要额外的数据采集,比如通过模仿学习的方式,让机器人根据已有的轨迹去学习控制策略。
在操作类任务(如机械臂)中,这个过程相对容易,因为你可以手动遥操作机械臂,一晚上就能采集上百条轨迹数据。但在 whole-body control 的场景中,这就变得非常困难——让人形机器人模仿人体动作、采集对应数据的成本和难度都高很多。
因此,在 human control 领域,目前大多数方法仍以强化学习为主,而很少使用模仿学习。这主要是因为没有足够多的高质量轨迹数据来支撑模仿学习的训练。即便在 fine-tuning 阶段,数据采集仍是最大瓶颈。
所以整体来说,人类视频在机器人中的使用方式取决于任务类型。在操作任务中,由于能获得较多 action data,可以直接用 video pre-training + imitation learning 的方式;而在 whole-body control 中,数据稀缺使得我们更依赖 RL 来优化策略,这也是目前最大的区别。
6. 关于人类视频数据和动捕数据优劣对比
我觉得主要还是从可扩展性的角度来说。像 VideoMimic,它最大的优势就是数据来源的要求不是特别严格。我用手机拍一段视频,比穿动捕服去采一套数据要简单得多。比如说我现在想让机器人学跑酷,那我就在 YouTube 上搜跑酷视频,找到几个合适的,把这些视频转成我需要的数据,然后用 video 的方式去训练模型就可以了。
当然这样做的问题就是训练数据会更 noisy 一些。有些人看我们最后的 demo,说机器人走路的样子有点“醉醺醺”的,这其实就是因为训练数据不够干净,模型学到的动作不会像人一样那么完美,无论是走路还是上楼梯都会有一点偏差。
另一方面,像 PHC 和 MaskedMimic 这些方法,其实跟我们的方法有一些相似的地方,比如第一步 pre-training,还有第二步 teacher policy,我们其实用的也是类似 DeepMimic 的方式,后面也有一个 distillation 的阶段。这一类方法的数据质量非常高,但是数据来源比较难。高质量的数据能让模型在一些特定的任务上得到很高的精度,但问题是它不太容易扩展。如果你想做一个新的任务,就需要重新去采数据、重新训练。所以这就是一个取舍:你的 task-level scalability 和你的 deployed precision 之间会有矛盾。
References:
https://monst3r-project.github.io/