Human Data系列围绕人体数据展开,我们前四期分别采访了基于人体动捕和人体视频数据做人形机器人全身运控相关的四篇论文,人体动捕遥操Human Data EP01-MoCap:TWIST,全身运控系统Human Data EP02—MoCap:GMT和Human Data EP03—MoCap:Exbody2,基于视频的全身运控系统Human Data EP04—Video:VideoMimic。
Human Data第五期,我们采访了一篇非常有意思的工作——HuB: Learning Extreme Humanoid Balance,这篇工作探索了现有的人形机器人可以展示什么程度的极致平衡能力。与前面四期工作不同,HUB完全依托互联网人类视频数据来获取人体SMPL数据,以此来作为人形机器人运动控制训练的起点。
HUB的两位一作分别是张彤和郑博远。张彤目前在清华叉院读博,导师是高阳,本科毕业于清华大学电子系。他曾在加州大学伯克利分校(UC Berkeley)访问学者,师从 Koushil Sreenath 教授。郑博远目前在清华叉院读博士一年级,导师是高阳助理教授,本科毕业于同济大学计算机系。关于两位的导师高阳,我们之前也做过两期采访对话高阳:具身大模型框架ViLa+CoPa,EP1对话高阳、汶川:如何利用互联网人类视频训练机器人大模型(ATM—RSS 2024满分论文)
正如张彤和博远在访谈里提到:“整套范式的核心在于使用人类动作作为参考,让policy
去跟踪这个动作。一方面,这个参考动作是机器人的目标,另一方面,它也提供了一个强有力的先验。” Human Data系列正是展示如何通过利用大量且丰富的人体数据来扩充通用机器人训练需要的数据,来实现scaling。
查看原文目录
以下为本文目录
👇
1. HUB的核心特色
2. HUB方法介绍
第一部分:参考运动优化
第二部分:平衡感知策略学习
第三部分:Sim2Real
3. HUB对社区的贡献
1. HuB的核心特色
张彤:我们这项工作跟之前那些强调动态动作的研究有一定区别。首先,我们关注的是极致的平衡能力。比如我们设计了一个“单腿站立、另一条腿抬高并伸直、双手摆成 T 字形、躯干保持水平”的动作。我估计绝大多数人——可能超过 99% 的人——都无法做到这种动作。这种动作接近人类平衡能力的极限,甚至超过了一部分普通人的能力。
我们想在机器人上验证这种极致平衡的可行性。在做这个实验之前,我们也不确定当前人形机器人的硬件结构能否支撑这样高要求的动作。但事实证明,我们的硬件和算法能够完成这种动作,这说明现有的人形机器人硬件至少在一定程度上具备了达到人类运动水平的能力。
第二点,就是这种平衡动作与动态动作不同。动态动作可能要求短暂的动态平衡,比如跳跃或投篮,这种平衡持续时间很短,对全身控制能力的要求和我们追求的长时间极致平衡是不一样的。我们的动作不仅可以保持稳定的姿势,还能在外部扰动下保持平衡,比如我们测试过用球去撞击机器人,它依然能够维持平衡。这种长时间、高难度的平衡能力,是之前很多动态动作研究没有强调的,也是我们工作中特别想体现的。
总的来说,HuB解决的两个核心问题是:一是验证了当今的机器人硬件可以支撑极致平衡动作,二是提出方法实现了长时间高难度的平衡。
郑博远:从人的角度来看,保持平衡其实是一个非常复杂的系统问题。除了我们的肌肉和关节的参与外,还需要内耳的前庭器官、视觉系统的参与进行反馈调节。比如我们自己做实验时,单脚站立并闭上眼睛,就很容易摔倒,保持不了多久。
但对于机器人来说,这个项目中用于感知平衡的输入相对单一,只有一个 IMU 惯性传感器。这种单一输入增加了保持平衡的难度。同时,我们的动作设计偏向极端平衡状态,比如单脚站立或者类似李小龙那种高难度平衡动作,这在日常生活中不常见。
尽管如此,我觉得探究这种极致平衡很有意义。它可以帮助我们理解人形机器人到底能达到什么样的平衡能力。从实际应用角度来看,机器人在日常操作中也会遇到一些基础但不可缺少的平衡挑战。例如,当桌子上远处有一个物体时,机器人可能需要前倾身体甚至单脚支撑来够到,在蹲下拿东西时也需要保持平衡。在规划和执行这些任务时,平衡能力是必不可少的,所以对人形机器人平衡能力的研究是有价值的。
2. HuB方法介绍
从方法上来说,为了实现机器人的平衡,我们HuB 方法和其他一些工作的不同之处主要体现在三个部分。第一步是 reference motion refinement,这里我们特别强调如何去 refine 人类的参考动作。第二步是 balance-aware policy learning,这涉及到 policy learning 的设计。第三步是 sim-to-real robustness training,通过模拟现实中的传感器噪声等干扰因素,增强策略的稳定性。
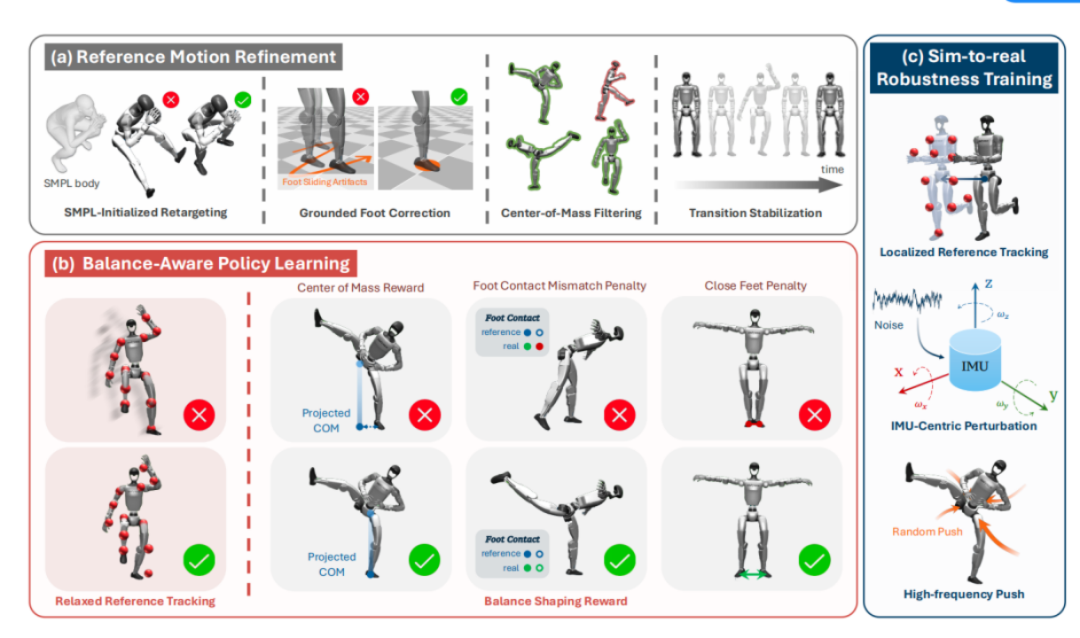
我们的方法框架整体上仍然沿用最早的DeepMimic思路:首先获取人类的参考动作,然后重定向(retarget)到人形机器人,再在仿真环境中训练 tracking policy。这个 pipeline 在现在很多人形机器人动作控制中已经非常常见,比如现在看到的大部分人形机器人跳舞动作都是利用这套方案实现的。但我们的重点区别在于上面提到的三个环节的改进,尤其是为了增强机器人在极致平衡动作下的稳定性。
第一部分:参考运动优化(Referece Motion Refinement)
第一部分(a)强调数据的重要性。对于普通任务(如走路、跑步),参考动作的准确性要求并不高,即使偏差一点,整体也能保持稳定。但对于极致平衡动作,数据质量要求非常高。我们提出了一些方法来优化数据采集流程,减少误差,使得数据不仅更准确,也更符合物理实际,这是第一层面的改进。
我们这里数据还用的不是动捕数据,当然是动捕数据也可以用,但我们觉得动捕数据还是有很多的局限性。动捕数据,首先你需要有动捕的设备,坦白说我们当时就没有那样的设备;另一方面,你必须在室内环境去自己人为采集。比如说我们想做99%的人都难以做到的平衡动作,周围也很难找到能做这些动作的普通人,可能要找武术专家才能通过动捕设备采集到。所以我们最终采用了视频数据。这些视频是从网络下载的体操运动员或者健身博主的视频,有些动作非常难。
参考动作误差来源有两方面,一是视频提取误差,二是retarget 过程本身收敛性没有保障,迭代的解存在有误差,并且没有时序连续性的保证。我们提出了四个模块。第一个是修改了之前 PHC 使用的retarget方法。PHC用梯度下降求解优化问题,优化目标是最小化机器人关键点位置和人关键点位置距离的差。我们发现直接做梯度下降迭代,对一些动作,尤其是下蹲,收敛性没有保障,误差非常大。我们修改了初始化方式,用人类动作对应的关节角作为初始化,让迭代从最优解附近开始,这样迭代速度更快,误差更小。第二是 Grounded Foot Correction,因为视频提取误差,有时候动作出现脚在地面滑动的现象,我们修正了这个误差。第三是基于重心的动作筛选,因为有些数据误差较大,重心远远偏离支撑脚,这样的数据要滤掉。最后一点是从现实部署角度考虑,发现直接部署 policy的瞬间会有较大抖动,我们在动作前增加站立时间,让机器人稳定再开始动作。
参考动作数据的一般来源是动捕数据和视频数据,我们采用的是后者。我们用了一些计算机视觉的算法,可以从视频里提取出人类的 SMPL,也就是人体动作的姿态表示。简单来说,AMASS等动捕数据集是直接用动捕设备获取人体姿态,而我们是从视频里提取人体动作,用算法把视频数据映射成 SMPL 表示。
SMPL(Skinned Multi-Person Linear Model) 是一种参数化的人体模型,由 Max Planck Institute for Intelligent Systems 的研究团队(由 Michael J. Black 等人)在 2015 年提出。它能通过少量参数(姿态和形状)来逼真地重建和表示三维人体的几何形状与姿势。SMPL 模型的输出是一个三维人体网格(3D mesh),具有固定拓扑结构。其参数分为两部分:形状参数(Shape parameters)和姿态参数(Pose parameters)。
至于视频是否能完全替代动捕数据,现在来看仍有一定挑战。视频数据提取的误差相比动捕设备还是略大。但从长远来看,视频数据有巨大潜力,因为网络上有海量人类动作视频可用,比如健身博主、体操运动员等,只要方法不断优化,可以做为传统动捕数据的补充。
HuB我们做的大多数动作偏静态,所以在网上找到的数据,很多是固定相机视角拍摄的、动作幅度不大的个体。目前基于视频的动捕算法,如果遇到移动相机或人物大范围运动时,精度就会下降,可能需要做额外修复,比如保证脚始终着地。我认为未来利用互联网海量人类视频数据是一个很好的方向,但目前存在一些权衡:自采集的数据质量高但耗时、动作种类有限,网上视频量大但精度有限。我们的工作重点是通过 reference motion refinement 尽量减小误差,使生成的动作能够被机器人学习,并顺利完成平衡动作。
在Retarget这块稍微展开一下我们的处理方法。目前也有一些方法,比如你提到的 PHC中的retarget。这个方法的核心是先定义一些位置对应关系,比如机器人手腕对应人的手腕、肩膀对应肩膀、脚对应脚、膝盖对应膝盖等。确定这些对应关系后,本质上就是一个优化求解问题,通过梯度下降去求最优解。
以前的方法通常是从零初始化,也就是说所有关节角都是零开始优化,这样在做像下蹲等动作时,可能会得到不合理的姿势,比如两个腿没有正确闭合。而我们的方法是在优化前先把人体模型(SMPL)中对应的关节角作为机器人关节角的初始化值,这样离最优解更近,优化起来就会更容易,也能得到更合理的动作。
另外,还有一种方法是直接复制人类关节角作为目标(HumanPlus),但这会存在问题:人的关节角和机器人的自由度不完全匹配,直接复制可能导致手部末端执行器位置偏差较大。我们做了结合:先用人体关节角做初始化,再通过梯度下降进行优化,从而得到较好的 retarget 结果。
第二部分:平衡感知策略学习(Balance-Aware Policy Learning)
张彤:在第二部分Balance-Aware Policy Learning,我们考虑的出发点是,人体和人形机器人虽然形态接近,但仍然存在差异,比如质量分布不同。这种差异在单腿极限平衡动作中尤为显著,因为这种姿势本身平衡区域很窄,很容易偏离可保持平衡的空间。
第一步,我们发现如果像以前一样严格做 motion tracking,机器人即使保持和人一样的姿势,也可能无法平衡。于是我们对 motion tracking 的松紧程度进行了放松,也就是所谓的 relaxed track。这样做相当于增大了误差的容忍范围,让 policy 可以在更大的空间里搜索,找到适合机器人自身的平衡姿势。
第二步,虽然探索空间变大,但强化学习容易出现 reward hacking,也就是机器人可能找到一些在 reward 上表现很好,但实际上并未真正学会目标动作的策略。举例来说,在单脚站立并抬起另一条腿的动作中,如果没有额外约束,机器人可能因为摔倒惩罚过大而“摆烂”,只做一些简单的、危险性低的动作。
为此,我们在 reward 设计中加入了 shaping reward,包括center of mass reward, foot contact mismatch penalty, close feet penalty 等。这可以防止机器人钻空子,确保它真正学习到符合任务要求、在现实中可行的动作。
郑博远:我补充一下 balance-aware policy learning 的做法。简单来说,我们对平衡类动作进行了专门设计,让机器人能更好地感知平衡差异。主要原因有两个:一方面数据本身存在误差,另一方面人和机器人在形态学上存在差异,比如重心分布不同。
如果严格按照人类动作去追踪,比如上图(b)部分左边红色图所示,严格跟踪会因为重心不合理而导致机器人容易摔倒。因此我们放宽了跟踪条件的约束。同时,我们设计了额外的奖励函数来规范行为。具体来说,一方面我们希望机器人完成目标动作,比如抬脚动作;另一方面我们希望它获得更稳的重心,通过重心奖励鼓励机器人平衡姿态更稳定,同时通过 close foot penalty 约束一些不合理姿势,避免自身碰撞。
整体上,在策略学习阶段我们通过放松跟踪约束和设计奖励函数,让机器人能更好地适应平衡类任务。
张彤:我解释一下我们的策略学习范围和可扩展性。目前我们做的主要是单个动作,每个动作对应一个独立的 policy。但我们的框架本身是兼容的,也就是说理论上可以训练一个通用 policy 来执行多种不同动作。不过,如果动作差异很大,如何把它们集成到同一个 unified policy 里,就是另一个研究问题。
我们目前的重点是探索平衡能力能达到什么水平,所以用单动作 policy 是最简单直接的方法。不过,框架是支持的——可以一次训练多种数据,然后集成到同一个 policy 中。我也简单尝试过这种多动作整合,通过 multi-teacher distill到 student 的方式,将多种动作融合到一个 policy,实际操作起来还是比较容易实现的。
目前每个动作对应一个独立 policy,这样最简单也最可靠。我们框架是可以扩展的,可以通过 multi-teacher 到 student 的方式,把多动作整合到一个 unified policy 中。
在 demo 展示方面,我们拍摄了大部分动作,唯一没做成的是类似“叶问蹲”那种单脚抬起、蹲下的复杂姿势。但问题不在于 policy 的训练能力,而是在数据层面——从互联网视频中提取这种有很多遮挡动作的 3D 姿势,目前无法生成准确的训练数据。除了这个例外,其他动作我们都成功实现了。
我们之所以没有做这个动作,并不是我们的 policy 做不到,而是我们从互联网视频里难以获取准确的数据。视觉动捕算法在这种高度遮挡的动作上能力有限。因此我们没拿到对应准确的数据。如果有更精准的MoCap设备或者 MoCap 数据,我们的方案其实可以很容易实现这个动作,并不困难。
第三部分:Sim2Real
Sim2real部分,我们也加入了常规的domain randomization,但我们重点强调了一些独特的设计。第一点是 localized reference tracking,对比OmniH2O,他们用视觉惯性里程计去获取绝对位移信息,比如用深度摄像机算你往前走了几米,但实际上人类自己也不会有那么精确的感知,而且现实中这种传感器噪声很大,有时候动作幅度大了,噪声又更大,形成一种恶性循环。我们考虑到机器人其实不需要这么精确的位移信息,所以去掉了里程计传感器信息。训练时,我们采用了 teacher-student 架构。teacher 在仿真环境里用强化学习训练,可以拿到各种精准信息,而student没有全局的位置信息,但可以通过 teacher 的监督信号隐式学到运动感知,就像人类大概能感知自己前进的距离一样。
第二点是 IMU 的噪声建模。以前的方法可能在 policy 观测上加独立均匀或高斯噪声,但 IMU 噪声是时序相关的,不是每个时刻独立的。我们加了IMU噪声,保持时序相关性,然后根据 IMU 信息计算 policy 的其他输入,比如重力在自身坐标系的投影、自身坐标系下的角速度等。如果独立加噪声,无法反映它们之间的耦合。我们把噪声加到 IMU 上,再由 IMU 推导出其他观测的噪声,这样 policy 感知到的输入更接近真实世界的噪声情况。
第三点是我们在仿真环境里做了高频 push,让机器人感受不稳的状态,学会在被推到不稳时快速恢复。这个本质上是一种 domain randomization,让 policy 在真实环境里遇到抖动时能自动调整,而不是把抖动放大。
3. HuB对社区的贡献
我们做这个动作的初心,其实是想探究平衡的极限。我们希望把某一个子领域做到极致,让机器人在这个阶段达到最极端的状态。我们做了这个实验,也证明了当下人形机器人在平衡方面的能力。坦白说,人形机器人的发展非常快,一年前和现在的能力已经完全不同了。我们的工作是在今年四、五月发布的,当时展示了人形机器人在平衡方面的极限能力,而后续又出现了更多新能力的展示。那时我们主要是验证了在平衡这一方面,人形机器人能达到的极限水平。
从更长远来看,我们一直在思考把人形机器人的运动能力和操作能力结合起来。现在很多人形机器人在稳定性上不如轮式机器人,但它们在通用性和全身控制(whole-body control)上有更大潜能。我们希望提升人形机器人的稳定性和平衡能力,让它不仅能站稳,还能执行更多复杂的动作,从而发挥其丰富的运动和操作潜力。
我觉得人形机器人迅速发展的推动力大概有几个方面。首先是来自 DeepMimic这种范式,它带来了很强的表现能力。只要有一个人类动作,人形机器人理论上就可以做类似的动作。另一方面,也来源机器人硬件的发展,本身比较稳健,运动能力比早期的机器人更好,sim2real gap更小,这为高难度动作提供了物理保障。
整套范式的核心在于使用人类动作作为参考,让 policy 去跟踪这个动作。一方面,这个参考动作是机器人的目标,另一方面,它也提供了一个强有力的先验。举个例子,以前让人形机器人走路,如果不用这套方式,就需要自己设计复杂的 reward:比如奖励向前走、抬脚、避免蹭地面等等。这类 reward 比较稀疏,机器人必须在很大的搜索空间内探索如何走路。
而基于参考动作的方法,你可以直接从人类动作中获取先验,初始化状态更合理。比如走路,你就知道先抬左脚再抬右脚交替前进,这不仅给了一个明确的目标,也相当于在 reward 里提供了结构化指导,让探索空间更小,更高效。