在2024年末,我们举办过一场关于RL和Control的线上Panel(播客:RL+Control 如何将机器人可靠性逼进99.9x%),关于RL的路线嘉宾提到了一个观点:“拿强化学习来说,我们得明确具体讨论的是哪种类型的强化学习。比如是“仿真到现实的无模型强化学习(Sim2Real Model - Free Reinforcement Learning)”呢,还是当下很热门的“学习世界模型(Learning word model)”、也就是基于模型的强化学习(Model-based reinforcement learning),亦或是在真实世界里开展的无模型强化学习呢?我觉得这些不同类型的强化学习其实差别挺大的。另外,还有离线强化学习(Offline reinforcement learning),有很多演示数据(Demonstration)的时候,不光能做模仿学习,还可以进行离线强化学习。强化学习之间的差别可能比强化学习和Control之间的差别还大。”
在这个观点的触动下,我就特别希望做一个关于强化学习+机器人的深度科普。其实RL+Robotics这个关键词也是石麻笔记自2023年6月开始一系列关于具身智能科普系列文章的开端。一年半之前,基于Covariant(Covariant:三个华人小伙创办的AI4Robot独角兽)的路线RL+Robotics延展,我在网络上搜集关于RL和机器人结合的各种学习资料,当时广为流传的图谱AI+Robotics华人图谱其实草稿里的名字就叫RL+Roboitcs华人图谱。时隔一年半,我也想好好了解一下目前纷繁复杂的RL各种算法和Robotics的结合。
今天这篇文章,我采访了两位在RL领域极具代表性的学者上海交通大学的张伟楠老师和苏黎世大学的宋运龙博士,并结合播客:RL+Control 如何将机器人可靠性逼进99.9x%里朱秋国、石冠亚、卢宗青、罗剑岚的观点整合了一篇RL+Robotics的深度科普。原本计划将所有的观点归纳整理成结论发布,但又不想因为我的二次加工将被访者的思考过程或者信息丢掉,所以还是按照老样子以访谈记录的形式公布。不同的嘉宾对某些问题的回答观点可能会有重复,也请读者见谅。
以下关于RL+Robotics的万字长文,希望对你有用。
查看原文目录
以下为本文目录
👇
第一部分:张伟楠访谈记录
1. Value-based RL vs Policy-based RL
2. Online/Offline RL vs On/Off-policy
3. Model based RL vs Model Free RL
4. Q-Learning
5. Sim2Real RL
6. 关于师生网络
7. RL+操作
第二部分:宋运龙访谈记录
8. RL的分类
9. Value-based RL vs policy-based RL
10. on/off-policy是policy-based的分支吗?
11. model-free RL vs model based RL
12. RL在无人机控制的特色
13. 无人机和操作任务中的感知问题
14. RL和MPC对无人机的控制
15. 无人机学术和应用的发展趋势?
16. 可微引擎 vs locomotion
第一部分:张伟楠访谈记录
张伟楠博士现任上海交通大学计算机系教授、博士生导师、副系主任,科研领域包括强化学习和数据科学,谷歌学术引用2万余次,于2011年获得上海交通大学计算机系ACM班学士学位,于2016年获得伦敦大学学院计算机系博士学位。张伟楠老师曾出版教材《动手学强化学习》和《动手学机器学习》。
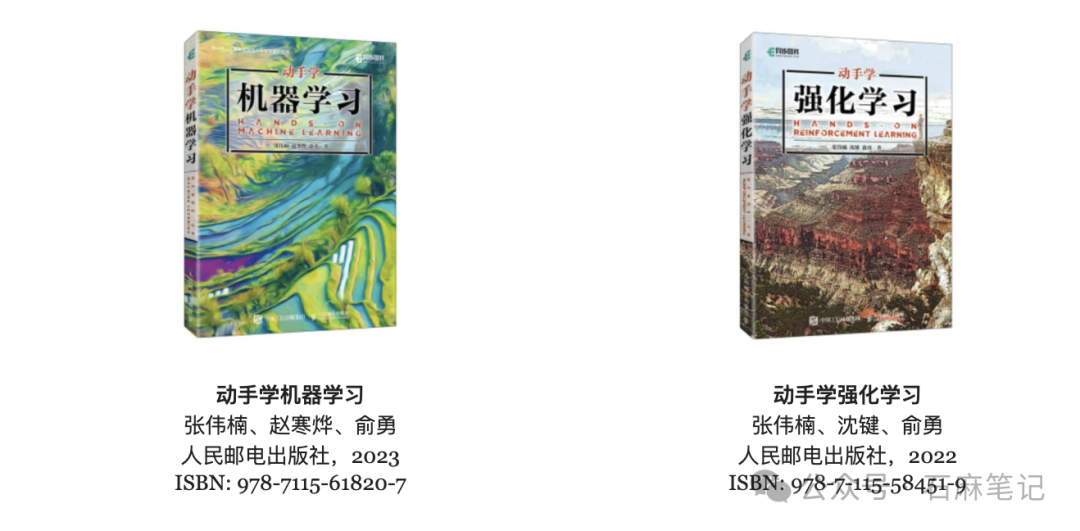
在访谈的过程中感受到张老师对强化学习的理解非常深入,而且可以将复杂的知识用很生动的方式讲解清楚。以下是我和张老师请教的关于RL分类的访谈记录:
关于强化学习的分类有很多种方法,大致我们可以将其分类成以下几类:基于价值函数的RL和基于策略的RL;Online RL和Offline RL;On-Policy和Off-Policy;Model-based RL和Model-free RL。
1. Value-based RL vs Policy-based RL
基于价值函数的RL(Value-based RL)方法是通过智能体与环境多次交互,累积回报(Return),并计算期望值,这个期望值就是价值(value)。Value-based RL 通过学习价值函数来评估状态和动作的优劣,智能体基于这些评估来选择动作。比如,Q-Learning,SARSA,DQN等就是基于价值函数的强化学习算法。
Value-based Reinforcement Learning (基于价值的强化学习) 是强化学习中的一种方法,主要通过学习一个价值函数来指导智能体的行为决策。该方法的核心思想是,通过评估每个状态或状态-动作对的价值(即“好坏”程度),来选择最优的行动策略。在这种框架下,智能体并不直接优化策略,而是通过学习一个价值函数来评估每个状态的“价值”或某个动作在特定状态下的“价值”,然后基于这些评估来选择行动。
价值函数(Value Function)估计的是从某个状态出发,智能体未来所能获得的累积奖励的期望值。通常有两种形式:第一种是状态价值函数,表示在某个状态下,智能体能够获得的预期回报。第二种是动作价值函数,表示在某个状态下执行某个动作,所能获得的预期回报。
基于策略的RL(Policy-based RL)不依赖于价值函数,它直接优化策略。纯策略方法较少见,常见的算法有策略梯度方法(Policy Gradient),例如REINFORCE。
Policy-based RL 直接优化智能体的策略,通过调整策略参数来最大化累积回报。与基于价值函数的强化学习方法不同,基于策略的方法不依赖于价值函数的估计,而是通过直接学习一个参数化的策略(通常是一个神经网络)来选择最优动作。策略(Policy)是智能体在某一状态下选择动作的规则,可以是确定性的(deterministic),也可以是随机的(stochastic)。
除此之外,还有结合价值函数和策略的算法,这类方法同时使用价值函数和策略来进行学习和优化。常见的结合算法包括A3C(Asynchronous Advantage Actor-Critic)、A2C、PPO(Proximal Policy Optimization)、TRPO(Trust Region Policy Optimization)、DDPG(Deep Deterministic Policy Gradient)等,这些算法都属于“Actor-Critic”框架。这些方法在处理高维状态和动作空间时表现尤为突出,适合一些需要高灵活性和连续动作空间的强化学习任务。
2. Online RL vs Offline RL vs On-policy vs Off-policy
Online和Offline,主要的区别在于智能体训练时是否实时与环境进行交互。Online RL 依赖于实时交互,而 Offline RL 则依赖于预先收集的数据。
On-policy 和Off-policy皆属于Online RL,主要的区别在于是否使用与当前策略相同的数据来进行学习。On-policy 仅使用当前策略产生的数据来更新策略,而 Off-policy 可以使用其他策略生成的数据来学习。
Online RL,On-policy和Off-policy 都属于在线学习的范畴,其中 On-policy 是完全的在线学习,是一种依赖环境交互的学习方式。Offline RL则是完全不同的概念,大约是在 2018 到 2020 年左右才出现的,它不需要和环境交互,而是基于已经收集到的数据进行学习,也就是脱离了环境的交互,速度相对较快。On-policy和Off-policy在学习时仍然需要和环境进行交互,唯一的区别是,On-policy 不使用数据缓存池,而 Off-policy 则会有一个数据缓存池。
为了方便理解,我经常用一个类比:on-policy就像是用自来水洗手,水从水管流出来经过你的手,这个水就是数据。这些水过了你的手之后会变脏,然后直接流掉,不再使用。如果水流太快,可能会浪费很多数据。
与此相对,off-policy 更像是有一个脸盆接水,你不是直接用自来水,而是通过脸盆把水接住,脸盆里的水可以继续循环使用。当脸盆里的水满了,最早期的水就会流出去。在off-policy 的方法中,数据被收集进缓存池中,可以在不同的时刻重复使用。
Offline 则更进一步,这个水压根就没有从水管里出来,就是一个脸盆,里面预先装好了水,你不断的在脸盆里洗手。就是根本不依赖于环境的实时交互,你不会从自来水管中直接取水,而是先收集好数据,之后在缓冲池里反复利用这些数据进行训练。
这种设定是环境或者说任务决定你可不可以使用 on-policy 或 off-policy,或者是否只能使用 offline RL。例如,在玩游戏的时候,游戏引擎可以随时让你玩,产生无限的数据,这时你就可以使用 on-policy,因为数据采集是没有限制的。但如果数据流得很快,导致很多数据被浪费,需要有个脸盆接住,这就是数据缓冲池,那么你可能会选择使用 off-policy 的在线学习方法。反之,如果数据采集很贵,哪怕一条浪费了都很宝贵,像在工厂车间里,每条数据都非常宝贵,那么就可能会选择 offline RL的方法进行学习。
总结来说,如果数据非常稀缺且难以获得,那么就用offline RL;如果数据相对容易获得,但也比较宝贵,那么可以用off-policy,用数据缓冲池先把数据收集起来,如果池子满了那么最老的数据还是会被丢掉;如果数据可以无限获得,那么就可以让它一直产生,就用on-policy。
3. Model based RL vs Model Free RL
最开始时,许多人选择使用基于模型(model-based)的方法,因为一旦建立了环境模型,智能体可以在这个模型中自由操作。建立好环境模型后,可以进行动态规划,或者在这个模拟环境中进行无限数据采样,这些都不会干扰到现实世界。基于模型的方法适用于环境能够完全建模并模拟的情况。很多经典的强化学习方法,如走迷宫、围棋游戏等,都是基于模型的。在强化学习中,所谓的“模型”一般都指的是环境的模型,即环境的动态模型,例如,Model Predictive Control(MPC)就是利用环境的动态模型进行规划。说到model,我们几乎不会说policy model,或者value function model,我们一般说的都是环境的model。
在强化学习中,环境模型通常包含两部分:一是状态转移(state transition)函数,二是奖励(reward)函数。更常见的是基于动态环境状态转移函数进行建模。建模完成后,相当于环境已经给你了,就可以利用环境模型进行动态规划,这种方法的核心在于,通过学习模型来进行决策和规划。
但是这种方法的问题就是通常对环境建模建的不准,结果可能并不理想。正因如此,像Rich Sutton和David Silver等人提出了model-free的方法,这个方法更依赖数据,通常不需要事先构建复杂的环境模型,而是直接从数据中学习。最典型的例子是Q-learning,的核心思想是学习价值函数(Q函数),它可以告诉智能体在每个状态下采取什么动作是最优的。Q-learning不需要知道环境的动态模型,只要能够收集到状态、动作和奖励的三元组数据,就可以进行学习。
这个过程其实可以通过一些具体的学习算法来实现,比如时序差分学习(temporal difference learning)方法。差分学习方法中有两种主要的方式,一种是on-policy方法,另一种是off-policy方法。
4. Q-Learning
Q-learning是一种“off-policy”方法,即它的训练不必依赖于当前策略生成的数据(与“on-policy”方法不同)。例如,在Q-learning中,智能体可以利用其他策略或者之前训练的策略生成的数据进行学习。这使得Q-learning具有更大的灵活性,可以使用来自不同策略的数据来加速学习,而无需局限于当前策略生成的数据。相比之下,“on-policy”方法则要求智能体只能使用当前策略生成的数据进行学习。
Q-learning的优势在于它去掉了传统强化学习中的“重要性采样纠偏”问题。传统的“off-policy”方法需要对使用他人策略生成的数据进行修正,而Q-learning通过一个简单的更新规则,能够在不用纠偏的情况下使用其他策略的数据。
在实际应用中,Q-learning方法的一个显著优势是它可以基于数据驱动进行学习,而不需要构建复杂的环境模型。智能体只需收集状态、动作和奖励信息,就能够直接学习Q函数,就可以得到最优的策略。这样,Q-learning方法不需要对环境的状态转移概率或奖励分布有明确的了解。
Q-learning 最初由 Chris Watkins 在 1989 年提出,它的主要优势在于无需环境模型,通过与环境的交互学习最优策略。1990 年代到 2000 年代初期,Richard Sutton 等学者帮助推动了 Q-learning 算法的普及。2013 年,DeepMind 的研究人员David Silver 提出了 Deep Q-Network (DQN),他是深度强化学习的早期推动者之一,他的最大贡献之一是将Q-learning与深度神经网络结合,提出了 Deep Q-Network (DQN),使 Q-learning 成为深度强化学习(Deep Reinforcement Learning, DRL)的核心算法之一。DQN 的出现使 Q-learning 不再局限于简单的状态空间,打破了强化学习在高维数据处理(如图像输入)上的瓶颈。
当时,David Silver 在 UCL(伦敦大学学院)工作时,他不断向伦敦的公司推销自己提出来的 Model-free 强化学习方法。然而,初期并没有得到太多关注。很多人不理解他的方法,认为如果不对环境进行建模,直接依赖数据学习是不可行的。大家习惯了通过建模来描述环境,尤其是在小数据时代,人们更倾向于通过建模环境并采用动态规划来解决问题。
但是,随着大数据时代 的到来,David Silver 的方法开始显得更为可行,因为数据量的增加使得基于数据驱动的学习变得更加可靠。尽管他在回到 UCL 后没有立即获得广泛的认可,他依然坚持自己的理念,不断推进 Model-free 方法的发展。
后来,随着深度学习的崛起,这种基于数据的深度强化学习算法也获得了巨大的突破。深度神经网络的强大表达能力使得 Q-learning 这样的算法能够处理更加复杂的任务。当 Q-function 被深度神经网络(如 CNN 或 AlexNet)所表示时,它能够自然地从大量数据中学习,从而进行更加精细的优化。
这种方法与传统的算法相比有着巨大的差异:以前的算法依赖于手动建模和有限的数据,而通过深度学习,Q-learning 能够自动从海量的数据中进行学习和改进,最终实现了Atari 游戏等复杂任务中的成功应用。这也标志着深度强化学习(Deep Reinforcement Learning)迈向了一个全新的高度,打破了过去的限制。
总之,基于模型的方法和无模型的方法各有优劣。基于模型的方法可以通过模拟和规划提前预见未来状态,而无模型的方法则更依赖于数据的积累和学习。随着深度学习的突破,Q-learning等“model-free”方法逐渐成为主流,特别是在处理复杂的、高维度的环境时,它们表现出了巨大的优势。
5. Sim2Real RL
以前,机器人并没有什么Sim2Real问题,就是因为现在它要学习了,才需要Sim2Real。对于强化学习而言,使用它来训练机器人进行运动或操作在以前是不奏效的,所以几乎无人尝试,原因主要有两点。
第一,强化学习需要大量数据。由于其试错性质,强化学习非常依赖智能体与环境的交互过程来获取有意义的数据。这与有监督或无监督学习不同:有监督学习可以直接利用预先标注的数据,无监督学习则可以从大量无标签数据中提取模式,但强化学习必须通过交互来获取可用于学习的高价值数据。
第二,机器人策略的部署需要考虑真实环境的本质。即便在模拟环境中策略看似有效,但如果交互数据量不足,策略就无法成功迁移到真实机器人上,尤其是在行走、跑跳等 locomotion 场景中。若缺乏充分训练,机器人可能频繁损坏设备,而在实际场景中摔坏十台甚至上百台机器人是不可接受的。因此,这类任务通常只能在模拟环境中进行训练。
然而,模拟器本身也存在局限性。它们通常基于预设的方程运行,难以完美模拟真实环境,尤其当涉及接触(如机器人腿接触地面)或碰撞时,这种模拟的准确度往往非常有限。这种模拟与现实之间的差距被称为 reality gap(现实差距)。
为了让强化学习策略在模拟环境中得到高效训练并能够成功跨越 reality gap,就产生了Sim2Real的技术,目前主要有两种解决方案。第一种领域随机化(Domain Randomization),在训练时,通过在多个维度上随机调整环境参数,使模拟环境涵盖尽可能大的变化范围。如果策略能在这些波动范围内保持有效,那么它在真实环境中的表现也会更加稳健。当前,大多数机器人(如四足机器人和工业机器人)都采用此方法;第二种领域自适应(Domain Adaptation or Policy Adaptation),这种方法结合真实环境的数据,使策略适应真实环境。具体来说,训练过程的大部分(约 95%)仍然在模拟环境中进行,只有约 5% 的训练数据来自真实环境,用于帮助策略适应真实环境。然而,在真实环境中收集数据依然面临很多挑战,比如噪声较大,以及数据质量问题可能导致策略完全失效。
为了应对这些挑战,有些领域自适应方法会在真实环境中收集数据后,调整模拟器中的参数,使模拟环境更接近真实环境。虽然这无法彻底解决所有问题,但相对可靠,且是目前被广泛采用的一种方案。
6. 关于Teach-Student Learning
做domain randomization,一个policy需要在很多环境里都work,举例来说,如果是机器狗(盲狗),它并不知道自己前面半米的地形具体是什么,只能“摸着”走。我们现在训练的盲狗就是摸着走:对它来说,地形是非稳态的,因为它不知道当前地形具体是什么,也不知道自己迈了腿之后会发生什么。它获得的观察(local observation)大多只来自四条腿的主体传感器,这些信息本身并不够全面。
但如果你的信息是带有“作弊”成分的——也就是说,在模拟环境里,你能看到周围一个一个格子里所有的地形,那么对你来说,环境就“白盒”了,你可以很快训练出一个策略。这时候我们就称这些“作弊信息”为特权信息(privilege information)。为什么这么叫?因为在模拟里,你能看到所有信息,等于开了全图,所以很容易就学到该怎么走。
这样做就可以先训练出一个 teacher(teacher policy),它打开了全局信息(全图),知道怎么走。接着,你要想办法把这个 teacher 蒸馏到只能用 local observation 的 student policy 里。也就是说,在实际中,学生并不知道为什么要在某个时候迈腿,但由于老师教了它此刻需要这么迈,它也就能做出正确的动作。老师之所以知道什么时候要迈腿,是因为它能看到前面其实有一块石头,所以应该往后迈一步——就是这么个道理。
一般来说,都是先让老师去学,学成之后,它就可以把自己看到全局信息的策略拿来指导学生。老师的策略会告诉学生:“这个时候往那边走”“那个时候怎么动”,通过一种回归的方式去教学生。
7. RL+操作
如果你的机器人任务就是一个路径规划任务——比如先做路径规划再做路径执行,那么它其实根本就不太需要RL。做 CV(计算机视觉)的同行喜欢先通过视觉把环境理解清楚,然后再做路径规划,接着就是路径执行,就结束了。这种情况下确实不太需要额外的复杂操作。
这里面一个关键点在于:当机器人和环境交互时,是否需要高频的、需要实时动态把握的事情。如果没有,那你就还是一个路径规划就够了,路径规划加执行就行。
举个例子,比如说“叠衣服”这个任务。如果你只是走路径规划的思路,在执行过程中,两个机械臂移动时,衣服只是自然地垂在上面,靠重力把衣服合拢,你的移动速度基本和叠衣服本身没有强关联——不管你是移得快还是慢,衣服都还会垂在下面。这就是“静态执行”。
但如果你有一些任务需要把衣服甩起来,做一个动态的动作(dynamic action),这种就得上RL。比如像机器狗走路,它本身就是动态的,不可能给每条腿做一个路径规划然后再执行,因为腿动得非常快。这种动态性是完全不同的路线,这也是为什么 locomotion(行走、奔跑等)很早就被研究并快速做出来,就是因为它很讲究动态控制。
我们再来看“操作”这个概念。如果只是简单地“夹一下”,可能需要关注的就比较少,变化速度不会那么快。那在这种情况下,你根本不在乎什么过程,你只要设置一个指令,比如 0 和 1,就是“放开”和“夹住”,这种就不太需要RL。现在很多操作都是 0 或 1 的简单动作,比如一个夹子“咔”一下就完事了,属于比较早期的场景,也不怎么需要玩儿太多花样。
但未来,如果是灵巧手的应用会越来越多,那手上的那些灵活动作就需要用RL,来做非常精细的把握。因为真正要做那些灵活细腻的操作,往往就需要很高频率的动态控制,远超出简单的 0/1 动作。
第二部分:宋运龙访谈记录
宋运龙博士是苏黎世大学信息学系机器人与感知小组、以及苏黎世大学与苏黎世联邦理工学院联合成立的神经信息学系,由Davide Scaramuzza教授指导的博士生。在攻读博士期间,他曾在麻省理工学院的仿生机器人实验室与Sangbae Kim教授合作研究。在攻读博士之前,他在达姆施塔特工业大学(TU Darmstadt)获得了硕士学位,其导师为Jan Peters教授。
(宋运龙博士学术生涯的几位指导老师都是大名鼎鼎,Davide Scaramuzza是RL+无人机领域的大牛,Sangbae Kim则是MIT Cheetah知名教授,Jan Peters和他的老师Stefan Schaal这一派学术传承是欧洲机器人学习最重要的分支,同时Jan Peters也是著名的论文Reinforcement Learning in Robotics: A Survey的通讯作者。)
在加入苏黎世大学之前,宋运龙做了相当多的理论研究,随后又进行了应用方面的探索,将强化学习应用到无人机控制领域。读博期间,他开始接触传统控制,尤其是基于优化的优化控制,发现这个方向非常有意思,便系统地进行了学习。博士期间,他的研究主要围绕优化控制和强化学习这两大理论基础展开,并在此基础上做了进一步的探索与应用。他开发了Flightmare仿真器,并设计了第一个能够推动超级敏捷无人机在物理世界中达到极限性能的强化学习策略。在进入关于机器人强化学习分类的科普访谈前,让我们先看一段宋运龙博士用强化学习做的无人机竞速。
8. RL的分类
在理论层面上,其实并没有太多真正全新的内容,更像是“新瓶装旧酒”。在深度学习出现之前,传统的强化学习已经探讨过如今常见的各种分类方法。具体如何分类,主要取决于你从哪个角度切入。
第一种分类是从最高层次来区分:可以将强化学习分为“深度强化学习”和“非深度强化学习”,两者的差别在于是否运用了深度学习技术。
第二种分类可以基于“value-based”和“policy-based”来划分。例如,AlphaGo 代表了一种典型的基于 value-based 的深度强化学习方法。而在机器人领域,目前较常见的则是基于 policy-based 的深度强化学习。当然,也有将 value 和 policy 相结合的混合(Hybrid)方法。
第三种分类与on-policy/off-policy相关。我不确定你所说的 online/offline 是否就是指 on-policy 和 off-policy,但这确实是另一种常见的分类方式。在强化学习中,常见的“online”概念指的是实时与环境交互并更新参数,但在实际应用中,这种完全在线的方式并不多见。更多讨论的则是 on-policy 与 off-policy 的区别。on-policy:用于更新策略(policy)的数据来自当前正在学习的这条策略本身就叫on-policy。off-policy:用于更新策略的数据来自其他策略或其他来源,而非当前策略,这种叫off-policy。
二者各有优缺点,on-policy 方法通常需要更多的样本(samples),因为每次只能使用当前策略采集到的数据;off-policy 方法可以重复利用历史数据或其他策略收集的数据,因此对样本的需求相对较小,也更具数据效率。
在前面提到的 value-based 和 policy-based 分类中,多数 value-based 方法(如 DQN)往往是 off-policy;多数 policy-based 方法(如 PPO)一般是 on-policy。这就是第三类分类方式:根据采样数据的来源划分为 on-policy 和 off-policy。
第四类分类被区分为 model-based 与 model-free。Model-free是无需显式学习环境模型,直接通过与环境交互来优化策略。Model-based是先学习(或构建)环境模型,然后基于该模型来采集数据或直接对策略进行优化。
除此之外,还可以再分出另一类:Reinforcement Learning (RL) 和 Inverse Reinforcement Learning (IRL)。后者主要关注如何从数据中学习出一个合理的奖励函数(reward function),以解决在 RL 中难以设计奖励函数的问题。
在机器人领域,我们通常会使用 PPO 这一类 on-policy 的算法,因为机器人控制信号多为连续空间,而离散动作空间(如棋类)常采用基于 value function 的方法。policy-based 方法在连续控制场景下更适用,因此也逐渐成为主流。
大约在 2019 年前后,随着 GPU 等硬件性能的提升和各类开源工具的涌现(如 OpenAI 提供的 Stable Baselines),PPO 的应用变得更加便利,只要数据量足够,就能取得良好效果。
因此,越来越多的机器人研究都采用了 PPO 等 policy-based 方法。而在此之前,各实验组往往根据自身条件或已有代码来决定使用何种算法。如今,PPO 几乎成为机器人强化学习的“标配”算法。但基于 Value-based 的方法,比如 SAC(Soft Actor-Critic)这类 off-policy 算法,它在理论上需要的数据量更少,但在实际使用中要想获得良好性能并不容易,虽然GPU可以给到它数据量,但它没有办法处理这么多的数据,会导致训练这类off-policy的方法训练速度更慢。换句话说,这类 off-policy 算法虽然数据需求相对更少,但训练周期往往会变长,也因此在实际使用中并没有想象中那么普及,使用者也相对较少。
9. Value-based RL vs policy-based RL
我的理解是,这主要取决于我们如何优化目标函数。在 Value-based 方法里,我们通常从底层推导出 Bellman 函数,最后要最小化 Bellman Error 或者 TD Error;通过最小化这个量,就能进行 Value-based 强化学习。
相比之下,Policy-based 方法则主要通过 Policy Gradient 来优化一个 Reward 函数,目标是最大化这个 Reward。也就是说,Value-based 方法是围绕最小化某种误差(例如 TD Error)来展开,而 Policy-based 方法则是直接最大化累积回报。从这个角度看,两者本质上是针对不同目标函数的优化过程。
其实并不是完全按照‘Value-based 适用于离散控制,Policy-based 适用于连续控制’这样来区分。就拿 SAC(Soft Actor-Critic)为例,它也能很好地解决连续控制问题,而 Policy Gradient 同样可以应用在离散动作空间。
只是从最初起源的角度来看,Policy-based 方法更多被用在连续动作领域,Value-based 方法更多应用于离散动作领域。但是随着神经网络的出现,我们可以用近似函数来解决各种不同的问题,所以这两种方法之间最初的分界线也变得越来越模糊了。
10. on-policy vs off-policy是policy-based的分支吗?
不是,在强化学习中,on-policy 和 off-policy 是一个整体的分类概念,并不单纯对应于 Value-based 或 Policy-based,value-based里面很多是on-policy。
on-policy指的是用来更新当前策略(policy)所使用的数据,全部都来自于当前策略本身的采样过程。也就是说,在 on-policy下,一旦使用完收集到的数据,通常就会抛弃,不再反复使用;因此这类方法往往数据需求更大。
off-policy则允许用任何方式收集到的数据来更新当前策略。这些数据可能来自人工示教、旧版本的 Q 函数采样,或者其他策略采样等。off-policy 算法的一个明显特征是使用了 Replay Buffer,可以反复地从中采样数据来更新策略,因而数据利用率更高,训练也更高效。
此外,Value-based 方法中确实常见 off-policy 算法,但不能简单地说“Value-based 就等于 off-policy;Policy-based 就等于 on-policy”。这两组概念在强化学习中是不同的维度。
11. model-free RL vs model based RL
Model-free 和 Model-based 之间的区别非常直观:是否在算法的优化过程中显式地使用了环境模型。如果使用了模型,就属于 Model-based;如果没有使用,就属于 Model-free。
不过,这里说的‘是否使用模型’也有一定的复杂性。例如,许多 Model-free 方法也会使用模拟器来采集数据,但只要该模拟器没有被直接用于策略梯度计算或策略优化中,就依然属于 Model-free。
比如 MPC(Model Predictive Control)算法会用到一个显式模型,通过它来计算梯度或进行预测,并把结果直接用于优化过程,因而是地地道道的 Model-based 方法。
另一方面,Model-based 与 MPC 之间也有细微差别,主要看‘模型’的来源和用法:在 MPC 中,通常假定模型是已知的或通过物理推导(First-Principle)得到的。而在一些其他 Model-based RL 方法中,模型可以通过数据来学习(例如用神经网络去逼近环境动力学)。
不同的 Model-based 方法也会基于不同的优化思路。比如,可以借鉴 MPC 的在线滚动优化方式,用模型进行采样或预测;也可以采用基于梯度或者非梯度的搜索方法。所有这些差异都体现在‘如何在策略优化的过程中具体使用环境模型’这一点上。
有些 Model-based方法并不仅仅学习一个环境动力学模型(Dynamics Model),它可能同时还学习一个奖励模型(Reward Model)以及一个价值函数(Value Function)。例如在一些论文(如 Dreamer、PlaNet)中,他们会把这些模型一并学习:先学到环境动力学、奖励模型和价值函数,然后再基于这些模型进行在线优化。
不过,仅靠学到的模型本身并不能直接告诉我们该采取什么动作,因此还需要一个方法来确定最优动作。通常的做法是采用类似在线 MPC(Model Predictive Control)的方式,直接在学到的模型上对一系列候选动作进行采样或预测,评估它们的长期回报并选取最优动作。这样就实现了在模型之上的规划与决策,这是当下较常见的一种方式。
如果我们只学习了一个 Value Function,而没有学习 Dynamics Model,那更像是做一个回归任务,和是否使用模型(Model-based 或 Model-free)关系并不大。只有在做在线优化、寻找最优动作时,才真正涉及到强化学习的部分,因为这时我们需要通过 RL 的方法来更新策略参数、决定具体动作。
现在的许多论文,作者可能并没有对这些概念(Model-based、Model-free、RL 优化等)进行严格区分,比如说某些工作号称是 ‘Model-based’,但实际上它依旧是 Model-free,或者它与真正的强化学习并不搭界,这种误用的例子并不少见,所以在阅读论文时也要多加留意,避免被误导。
在目前的 Locomotion(机器人运动)领域,至少有 80% 的效果较好成果都来自于 Model-free 方法。Model-based 方法的表现普遍不够理想,因为要精确学习环境模型(Dynamics Model)本身就很困难;即便得到了模型,还要在此模型基础上进一步优化策略或动作,这个过程同样不容易。
有些 Model-based 算法同时还要学习奖励函数(Reward Model)和价值函数(Value Function),它们各自都会带来一定的误差,这些误差叠加后往往导致性能不如直接采用 Model-free 方法稳定。尽管 Model-based 理论上能以更少的数据量完成学习,但实际的优化难度要更高,尤其是在如何利用学到的模型来计算最优动作这一环节上。
目前大家对Model-based RL有一种‘理想愿景’是,如果我们可以先从少量数据中学到一个环境模型(Model),那么就能,第一,减少真实环境与模拟环境的差距(Sim-to-Real Gap):因为我们直接用真实数据来训练模型,而不是人工手动编写模拟器;第二,降低样本需求:有了模型以后,在学习具体策略(Policy)时,或许只需要少量新数据就能完成优化;第三,复用性:同一个学到的模型不仅能应用于当前任务,还能在更改 Reward 函数或目标任务时再次使用,从而极大提高效率。
不过在现实中,这种优点往往并未完全体现出来。因为目前常见的方法还是通过手工编写的模拟器(Simulator)来生成数据,而这个模拟器和真实环境之间不可避免地存在差异。此外,把在模拟环境中学到的策略部署到真实环境时,也面临很多挑战。如何有效地桥接这两者,仍是一个亟待解决的问题。
12. RL在无人机、locomotion和操作里的应用有什么区别
我个人并没有在机器人操作(Manipulation)领域做过实际项目,所以只能提供一些主观看法。与无人机或机器人移动(Locomotion)相比,操作任务有着根本性区别:
首先,关注对象不同。在无人机或 Locomotion 领域,机器人最主要关注的是自身本体的状态,例如自身姿态、关节角等,环境因素(如地形)虽然也重要,但相对来说关注度较低。而在 Manipulation 中,环境起着至关重要的作用;不仅需要知道机械臂(或机器人手)自身的位置和姿态,还必须对环境中的各类物体有相当深入的理解。
其次,环境多样性。在 Manipulation 场景下,每新增或更换一种物体(如形状、重量、材质不同的杯子或工具),都可能显著影响抓取策略。换言之,为了在通用情形下实现抓取,机器人需要在感知层面具备对环境的“通用理解”,包括物体的几何形状、重量、物理特性等。因此,有人认为,如果能真正解决通用抓取(General-Purpose Manipulation),几乎就解决了“AGI”中的一个核心难题,因为这要求对环境中各种不同的未知物体有极强的感知和理解能力。
再次,核心挑战在于感知(Perception)。从机器人要“看见”并“理解”物体的形状、重量、材质,到根据这些信息规划抓取方案,感知与认知层面的难度远远超出简单的控制问题。比如,如果已经知道目标物体的重量、形状等信息,那么“抓起物体放到指定位置”这个控制环节本身并不复杂,甚至可能不需要强化学习或复杂的神经网络。
最后,对大模型的期望。当前有很多期待是:借助大模型来提供更高层次的环境理解,包括对物体特性的推理和场景认知等。一旦这部分环境理解得到有效解决,执行抓取动作本身就变得相对简单。
综上,对于机器人操作(Manipulation)而言,真正的难点并不完全在控制层面,而更多在于对环境(尤其是未知物体)进行准确感知与建模。正因为此,如果仅仅在模拟环境中进行训练,到了现实世界,仍会面临大量无法预测的环境变化与物体差异,这也是当前通用抓取任务尚未被完全攻克的重要原因。
在机器人操作(Manipulation)场景中,除了对环境物体进行感知与理解(Perception & Understanding)这一核心挑战外,还需要考虑到长时间序列的任务规划(Long-horizon Task Planning)。例如让机器人在厨房里完成做菜,或者让机器人自己系鞋带,都需要多个步骤的分解与先后顺序的安排。
这一类复杂任务很难像无人机从 A 点飞到 B 点那样,用相对简单的数学公式直接表达并设计奖励函数。要把‘如何做饭’或‘如何系鞋带’这样高度抽象的过程,转化成明确可量化的目标和子步骤,本身就十分困难。
因此,相较于传统的短时、可量化任务(如定点导航),在操作领域的长时规划和任务拆分需求,使得问题建模(Problem Formulation)与奖励设计(Reward Design)都变得相当棘手。这也解释了为什么在现实世界的 Manipulation 任务中,我们往往还需要更多关于感知、理解、规划等多方面的技术突破。
13. 无人机和操作任务中的感知问题
无人机竞速、机器人抓取(Manipulation)以及自动驾驶等任务,其感知需求和复杂度并不在同一个量级。以无人机竞速为例,需要感知的主要是当前位姿、环境障碍物等,而在抓取任务中,机器人不仅要感知物体在空间中的位置和形状,还要理解其物理属性,比如物体材质、重量等,因为抓取过程中需要与物体本身发生交互。
相比之下,自动驾驶所需的感知主要是识别道路、行人、其他车辆及交通标志等,这些目标大多处在‘已知’的类别中。即便出现少量未知物体,通常也可以简单归类为障碍物。而在机器人抓取中,每新增一个物体,系统都需要更深层次地理解和适应,从而带来更大的感知挑战。
因此,虽然上述任务都离不开感知,但抓取任务的感知难度要远高于导航、无人机竞速或自动驾驶等场景:它不仅要感知物体‘是什么’,还要理解‘它的物理属性和交互方式’,这就是为什么 Manipulation 的感知难度被普遍认为更高。
14. RL和MPC对无人机的控制
那篇论文显示强化学习在无人机竞速(或类似任务)中优于传统的 MPC(Model Predictive Control),但实际上,MPC 对于绝大多数‘可轻松规划轨迹’的任务仍然足够胜任。只有当任务无法容易地被分解为显式轨迹跟踪时(比如竞速任务没有轨迹可以跟踪),强化学习的优势才更明显。
一个典型例子是Locomotion任务。在强化学习出现之前,常见做法是先规划好轨迹,再让机器人按此轨迹执行。但强化学习方法可以让机器人根据实时情况灵活决策,而不必严格跟随固定轨迹。当机器狗踩到不规则石头时,它可以自发地调整身体姿态或腿部动作,而不是局限于预定的运动轨迹;这使得强化学习在一些未知或复杂环境下表现出更高的适应性与自主性。
另一方面,如果要让机器人执行诸如‘做菜’这类复杂任务,无法用简单的数学公式或可微分的代价函数直接描述。在这种情况下,强化学习可以根据更灵活的奖励信号来优化策略,而传统的 MPC 通常需要一个可微、可解析的目标函数,因而无能为力。
换言之,强化学习在长时序、难以规划或难以设计可微目标函数的任务中更具优势;而 MPC 在短时序、可轻松规划的任务中依旧具有高效、稳定的表现。
在无人机以及Locomotion这类任务中,为强化学习(RL)找到合适的应用场景往往更容易,因为问题本身通常可以被相对简单地建模,例如‘从 A 点到 B 点’。
不过,无人机竞速任务之所以更有挑战,在于除了从起点到终点外,还需要考虑速度最大化、避障(如穿越特定门框)、门框的通过顺序等要素。尽管如此,这些目标仍能较容易地转换成一个可明确定义的奖励函数,因而在强化学习的框架下也相对好建模。
15. 无人机目前已经很成熟,目前学术和应用的发展趋势是什么?
无人机未来的目标与自动驾驶类似:在给定一个高层任务后(如送货、巡检、灭火等),无人机能够完全自主地执行任务。技术上,目前虽未达成‘完全自主’(类似自动驾驶的 L5 级别),但已有企业(如美国的 Skydio)在做高水平的自主飞行,能实现相当程度的自主性。
目前的无人机行业在产品化与市场占有方面具有明显优势,但从其现有产品来看,在无人机自主飞行的核心算法上或许还没有达到最顶尖的水平。尤其是基于视觉(Camera)的自主飞行,仍存在较大的技术挑战与发展空间。相比之下,基于激光雷达(LiDAR)的感知在精度和算法设计上相对更容易,但视觉方案若能突破,则可在无人机应用领域带来更多可能性。
16. differentiable simulation vs locomotion
之所以选择做这个 Locomotion 任务,是因为当时在 MIT 交流时,那个团队正好在研究 MIT Mini Cheetah 等机器人。其实用常规强化学习来解决 Locomotion 已经相对成熟了,我当时的想法是尝试不同算法,对同一个问题进行多角度探索。
在这过程中,我们提出了一些新思路:如果有一个可微分(Differentiable)的模型,那么就能通过这个模型直接获取梯度,训练策略时效率可能提升十倍甚至上百倍。不过由于 Locomotion 任务的数据采集成本并不算特别高(从一两分钟缩短到十几秒可能并没有本质差异),因此实际中人们对这种‘额外的高效率’并不十分在意。
但我仍然觉得这个方向值得研究,尤其是当输入是高维度的视觉信息时,单纯依赖强化学习往往难以胜任。因此现在常见的一些做法,如‘Learning by Cheating’(先给一个拥有更完整或特权信息的 Teacher 策略,再做模仿学习),也是因为目前直接用端到端强化学习去处理视觉输入,难度依旧很大,仿真能力也有限。
第三部分:播客:RL+Control 如何将机器人可靠性逼进99.9x%
在24年12月末的博客里,也有大量关于机器人里RL的探讨。因为涉及引用的问题,我们仅提取一些观点,详细的内容可以参看之前的问题整理播客:RL+Control 如何将机器人可靠性逼进99.9x%。
“RL以及Control本身都算不上是一种方法,而应该是一个问题。RL和Control之间的的差别甚至比强化学习(RL)内部不同类型之间的差别还要大。强化学习的定义就是有一个马尔可夫决策过程(MDP),包含奖励(Reward)和系统动态特性(Dynamics),目标是优化奖励,找到策略用于控制,这和Control本质上是一回事。其定义就是面对动态系统去设计策略以满足一些限制,不能因为Richard Belleman提出“S、A、R、S”这套表述就说它们不同。
Richard Bellman 提出的“S, A, R, S”是强化学习中马尔可夫决策过程(MDP)的一种表述方式,其中:S (State):表示系统的状态,描述了环境或系统在某一时刻的情况。A(Action):表示代理(如机器人)在当前状态下可采取的动作。R(Reward):表示系统在某一状态下采取某一动作后获得的奖励,通常用来衡量行动的好坏。S'(Next State):表示采取某个动作后,系统转移到的下一个状态。这个框架是强化学习的核心,用于描述在不同状态下,代理通过采取行动获得奖励,并根据奖励调整行为,以达到优化某种目标的策略。
说到 Locomotion,目前在这方面最流行的RL方法就是仿真到现实强化学习(Sim2Real RL),就是先在虚拟仿真(Simulated)环境里,运用近端策略优化算法(PPO)或者其他类似的算法去训练出一个策略,之后再把这个策略部署到现实世界当中去。我认为 Sim2Real RL是一种基于模型(Model-based RL)的方法。你想想它的操作流程就能明白,首先得有一个你比较信赖的模型,比如仿真器(Simulator),然后在这个仿真器里训练出一个策略(Policy),之后再把这个策略部署到现实(Real world)当中。
Sim2Real RL优势一是比MBC有更强的离线计算能力,Sim2Real RL优势二是可以绕开状态估计问题。拿目前在 Locomotion方面最成功、最流行的逻辑来说,师生网络学习(Teacher Student Learning)。自2020年Science Robotics发布论文“Learning quadrupedal locomotion over challenging terrain”之后,大概有几千篇文章都遵循这个逻辑,一直到现在,差不多5年时间把师生网络学习推到了顶峰。就是因为有这种师生学习框架,所以绕开了状态估计(State estimation)这个问题。
无模型强化学习(Model free RL)和Control解决的其实是相同的问题,面临的数学问题也是一样的,只不过解法不同罢了。”
References:
张伟楠主页
宋运龙主页
无人机竞速论文:
Reaching the Limit in Autonomous Racing: Optimal Control versus Reinforcement Learning
https://yun-long.github.io/publication/song-2023-science/
四足狗的可微分引擎:
Learning Quadruped Locomotion Using Differentiable Simulation
https://yun-long.github.io/publication/song-2024-rss/