世界模型系列,我们会采访一系列世界模型相关的工作,以期在喧闹的“世界中”,冷静的看待世界模型这个概念。继第一期世界模型EP01:对话高深远——DreamZero&DreamDojo 世界模型与机器人智能的新范式,基于2D视觉的世界模型工作后,我们在第二期访谈了一篇近期非常有特色的基于2D视觉的可交互的世界模型工作——Interactive World Simulator for Robot Policy Training and Evaluation,一个支持稳定长时序交互的基于动作的世界模型。
我们这期采访了Interactive World Simulator这个工作的一作汪怡暄,他现在是哥伦比亚大学第五年的博士生,导师是李昀烛老师,目前也在英伟达做研究科学家。他的主要研究是怎么把现有的一些基座模型,比如SAM、DINO,更好地用在机器人上;以及从机器人任务里去学习一些世界模型或者预测模型。从更长期来看,他也比较关注能不能做出更通用、更基础的world model。我们之前对昀烛老师和怡暄都做过采访,可以参考对话李昀烛:通用操作新解法——基于学习的动力学模型和GenDP:3D动态语义对Diffusion Policy泛化性的提升
查看原文目录
以下为本文目录
👇
第一部分:关于Interactive World Simulator
1. 核心思想
2. 方法介绍
3. 关于数据
怎么平衡高质量和脏数据
训练过程是否需要大量数据?
4. 为什么叫World Simulator?
5. 关于这个工作的一些问题
和Genesis这类仿真器的区别呢?
尝试了多少个任务?
交互准确性和真实世界比较
泛化性如何?
这个工作业界怎么用?
在交互过程中也会出现不符合物理的现象?
未来基于这个工作优化的方向?
这个工作的新路历程
超出预期的难度
第二部分 关于世界模型的概念和分类
6. 世界模型实质性的进展?
怎么理解用世界模型做机器人策略评估?
7. World Model和Dynamics Model有什么区别?
8. 世界模型有哪些主要分类?
3D世界模型
2D世界模型
World Labs和AMI可以归为哪一类?
9. 怎么看Video-Action Model这类世界模型?
和现有的视频生成模型对比?
10. 关于世界模型的一些问题
世界模型是不是一个更加吃资源的方法?
具身需要单独的世界模型吗?
怎么理解上面提到的闭环?
world model本质上是不是一个自回归模型?
第一部分:关于Interactive World Simulator
1. Interactive World Simulator的核心思想
我们这个工作的核心其实有三个点。第一个是物理真实性,我们的模型预测的物理和视觉都足够真实,让人在交互的时候足够沉浸。第二个是速度,这个模型必须足够快,才能支持实时交互。第三个是稳定性,我们在实验中让人和模型连续交互超过10分钟,大概相当于9000步左右的预测,整个过程是非常稳定的,而且预测结果始终保持比较真实。
论文主页的演示
比如在一些演示中,人通过一个控制设备去和这个视频模型交互,画面中看到的其实完全是模型生成的,并不是真实摄像头拍摄的场景。但很多人在第一次看到的时候,很难分辨这到底是真实的还是生成的,这说明生成效果已经非常接近真实。
石麻笔记作者Play论文主页的Simulator的演示(网络有点卡顿)
我们的模型可以理解真实的物理。第一个例子是绳子放进卡扣的任务,当我们的机器人将绳子放入卡扣的时候,我们的模型可以准确预测卡扣和绳子的交互:
但是当绳子只是在卡扣外面晃悠的时候,视觉上看起来很像,但是物理上完全不同,我们的模型还是可以准确预测未来:
第二个例子就是杯子的抓取,我们的模型可以准确预测这个杯子在手中滑出去的动作:
还有类似这种把手被推开的动作也可以准确预测:
另外,机械臂的运动也可以很好地跟随输入指令,这些都说明这个world model在动态建模上是比较可靠的。我们在做现场demo时,很多人第一反应都是怀疑是不是有隐藏摄像头,需要一段时间才能确认这是生成的。
在应用上,这个模型构建好之后,第一个重要用途就是数据生成。比如刚才提到的,我们可以完全不依赖额外的真实数据,仅用模型生成的数据,就能训练出一个比较鲁棒的策略。
第二个比较重要的应用就是策略的评估。之前大家训练好模型之后,只能在现实世界评估,这既麻烦,又不可复现。我们用我们的world model来评估训练好的模型,我们也做了定量分析。一个策略如果在真实世界中表现好,在这个world model中表现也会好;如果在真实世界中表现差,在模型中表现也同样较差。也就是说,这个模型在一定程度上可以反映真实环境中的策略表现。
2. 方法介绍
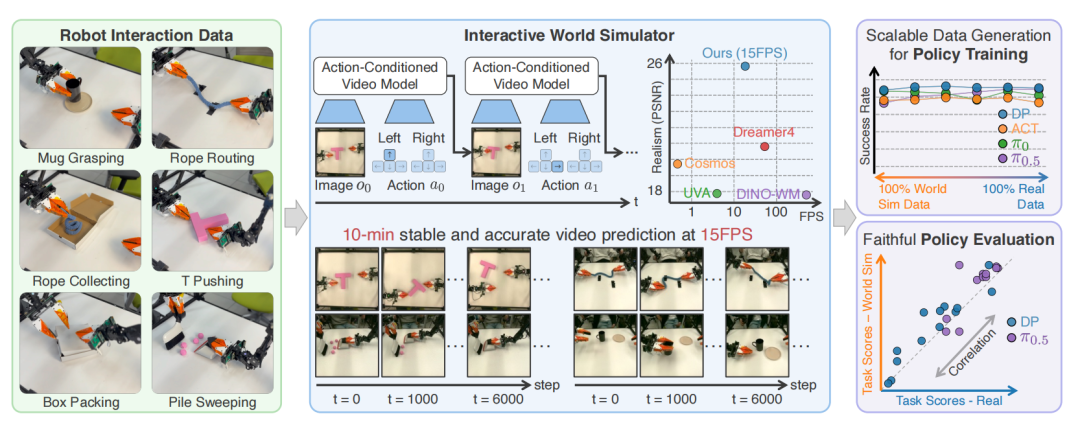
在方法上,我们其实有几个比较关键的点。
第一个是数据。数据在这个工作里是非常重要的。我们用的全部都是自己采集的数据,而没有使用像OpenX或者其他大规模现有数据集。主要原因是,这些数据大多是为训练policy(比如diffusion policy)准备的,它们的action分布通常比较窄,更偏向“正确操作”。
但如果要训练world model,我们希望模型见过更丰富的动作分布,包括成功的、失败的、快的、慢的,各种不同风格的交互。这样模型才能真正学到更完整的动力学。因此,我们选择自己去收集数据。
另外一个相关的点是,我们收集的是“play data”,而不是传统模仿学习里的专家数据。模仿学习通常强调数据要干净、顺滑、成功率高,但我们反而希望数据“更脏”、更随机一些,这样可以覆盖更广的分布,从而提升模型的泛化能力。
第二个是模型设计,大致可以分为两部分。
第一部分是表征学习。我们自己训练了一个encoder,把图像映射到一个表征空间,然后在这个表征空间中进行预测,再生成回图像。这样做的好处是可以对表征空间进行一定的约束,比如避免长时间预测时出现发散的问题。
第二部分是加速预测。我们引入了一种叫consistency model的方法。相比diffusion model需要多步迭代预测,consistency model可以用更少的步数完成预测,从而大幅提升速度,这对交互式系统是很关键的。
整体来看,我们是在表征空间中进行预测,而具体的模型设计其实有很多细节。
一个比较重要的经验是:核心思路本身并不复杂,也没有特别“花哨”的新技术,但需要把很多细节都调好,比如模型结构、参数设置等,这些对最终效果影响很大。这一点其实和diffusion policy等工作是比较类似的。
3. 关于数据
这里“数据质量好”具体是怎么定义的?另外你也提到,希望数据是“有点脏”的,也就是包含比较丰富、多样的行为。那这里面“质量好”和“有一定随机性或噪声”之间,怎么去平衡?
我觉得这是一个非常好的问题。其实这里没有一个特别统一、或者可以量化的“数据质量”定义,更偏经验性的判断。
但有一个比较核心的原则,就是数据需要足够多样。比如在“把绳子放进卡扣”这个任务里,你会希望数据里包含各种不同情况:有成功放进去的,有失败的;有只是把绳子晃来晃去的;有动作比较慢的,也有动作比较快的。也就是说,数据不应该只覆盖“最优解”,而是要覆盖整个行为分布。
另外,不同任务的数据采集方式也不太一样,需要根据任务本身去设计,所以很难有一个统一的标准。
但最终可以总结为一点:数据必须足够多样。如果数据分布太单一,比如全是成功的操作,那模型就学不到失败或者中间过程,也就没办法去预测更一般的情况。这一点其实是最关键的。
其实我们也不是完全“随意发挥”。相反,在采数据的时候是比较systematic的。
具体来说,对于每一个任务,我都会设计一个简单的interface,用来规范每个episode的数据采集。例如会明确规定:物体初始放在哪里,这一段交互要完成什么动作,比如把绳子放到卡扣里,或者把绳子放在中间,再放到两个卡扣里等。
通过这种方式,我们可以确保数据在不同情形下有比较均匀的分布,同时也能覆盖足够多的情况。
所以数据采集本身其实是非常关键的一步。比如李昀烛老师在外面做报告的时候,也有人反馈说,在我们提供的数据上可以复现结果,但换成他们自己的数据就不行了。这其实说明,数据本身的设计对最终模型效果影响非常大。
训练过程是否需要大量数据?
其实也不算特别多。我们每个任务大概用了6个小时的数据,因为在学校里也很难获取特别大规模的数据,这些数据基本都是我自己采集的。
所以从规模上来说,一个任务6个小时的数据是可以接受的。不过你说的方向是对的,本质上还是需要足够的数据,让模型见过足够多的交互过程,才能学到比较好的预测能力。
4. 为什么叫World Simulator?
其实我们在起这个名字的时候想了很久,一开始也考虑过要不要叫interactive world model。
但有两个原因让我们最后选择了“simulator”。第一是,现在大家对world model的理解其实差别很大,不同人想到的东西可能完全不一样,所以“世界模型”这个名字本身有一定的歧义,所以我们最终没有选择叫World Model,而是选择叫World Simulator。
第二个原因是,我们这个方法本质上确实是把模型当作一个“模拟器”来用的。你可以类比传统的模拟器,比如MuJoCo、Isaac这些,它们的形式都是:输入一个动作,输出下一步的状态或者图像。我们这个模型在形式上和它们其实是很接近的。
另外,在使用方式上也类似。传统模拟器主要用来生成数据、训练策略、以及评估策略。而我们的模型是从真实世界的交互数据中学出来的,但一旦学出来之后,也可以像一个模拟器一样被使用,比如用来生成数据、测试策略等。
所以从功能和用法上来说,它更像一个learned simulator,而不只是一个预测模型。
还有一个比较实际的原因是,“interactive world simulator”这个名字也能和其他工作稍微区分开来一点。
5. 关于这个工作的一些问题
和Genesis这类仿真器的区别?
它们其实更接近于传统意义上的仿真器,只不过底层使用的物理引擎或者建模方式可能有所不同。
我们这边是比较纯粹的2D设定,可以归类为和Dreamer、DreamDojo这一类比较接近。具体来说,就是输入当前的一张图像和一个动作,然后预测下一帧图像。
尝试了多少个任务?
我们最终展示的是6个任务。从设计上,我们尽量覆盖了不同类型的场景。例如包括可变形物体的任务,比如绳子被卡进夹子里;也有刚体交互,比如推动“T”形物体;还有像把小球扫进簸箕这种,多物体堆叠(object pile)的情况。
另外也包含了一些具有结构约束的物体,比如盒子的开关这类articulated object。整体来说,我们希望通过这些任务,覆盖不同类型的物理交互场景。
交互准确性和真实世界比较
首先,这里面有一个点是,在视频环境里进行操作的数据,其实也是我自己采的。所以从我个人的体验来看,这种交互是非常接近真实环境的。当然,一开始还是需要一个适应过程,因为你不像在真实世界中那样直接看着桌子操作,而是通过视频来完成控制。
但整体来说,这个模型的预测已经足够真实,可以支持采集到非常高质量的数据。
另外,我们也做了一些更系统的验证。例如,我们直接在这个视频模型中采集数据,然后用这些数据去训练一个模仿学习的策略。以“把绳子放进卡扣”这个任务为例,我们完全只用这些“模拟出来”的数据训练出来的策略,可以直接部署到真实机器人上,而且表现非常好。比如我们把绳子打乱,它依然能够成功地把绳子重新放回去。这说明生成数据的质量是非常高的。
我们还做了一个对比实验:把模型生成的数据和真实数据混在一起,用来训练策略。结果发现,模型的成功率基本没有变化,是一条比较平的曲线。也就是说,从下游学习的角度来看,这两种数据几乎是“不可区分”的。
这其实是一个很强的结果,说明生成数据在质量上已经可以接近真实数据。
泛化性如何?
首先从我们这个工作的角度来说,一个比较重要的点是,之前很多world model的工作,其实很少能在哪怕一个任务上做到非常接近完美的效果。所以我们这篇工作的一个目标是,先在单个任务上把模型做到足够好,让人和它交互的时候,基本感觉不到和真实环境有明显差距。在这个基础上,我们再去讨论泛化。
目前我们能做到的泛化主要有两类。一类是动作上的泛化,比如不同方式的推、拉,机械臂的一些变化,这些是可以覆盖的。另一类是同一任务里的状态变化,比如绳子放在上面、中间、下面,这些不同初始条件下也可以泛化。
但更强的泛化目前还做不到,比如完全新的环境、不同的机器人、或者新的任务,这些现在是不行的。
不过我们觉得这不算一个根本问题。因为现在一个任务大概只需要四到六个小时的数据,就可以训练出一个比较好的模型。如果未来数据规模上来,比如到几万小时,其实能做的事情会多很多。
所以我们的思路更像是,先把单任务做到接近完美,再去考虑大规模泛化。泛化本身还是一个更依赖数据、算力和资源的问题。从这个角度看,这个工作有点类似diffusion policy早期的路径:先在单任务上做到很好,然后再逐步往更广的泛化能力去扩展。
我们现在这个工作,更像是展示了这个方向在scaling上的最初一小段。后面如果要继续往上走,本质上还是需要更多的数据,以及更多的人力和工程投入来进一步验证和推进。
这个工作如果大家想用的话,应该怎么用?
代码这边我们已经完全开源了,目前也已经有人可以复现我们的结果。
另外,我们还提供了一个在线的demo。你可以直接打开网页,连接到我们部署在云端的模型,直接上手体验,不需要本地部署。
当然,如果你想做更深入的使用,比如在本地部署模型,或者接入更高级的交互设备,用来和模型进行更复杂的交互和数据采集,这些也是完全可以支持的。总体来说,这套系统我们是完全开放的,大家可以很方便地去尝试和使用。
而且我们现在已经把多个任务都部署在这个平台上,大概有四个任务,大家可以随时去体验。
我自己的感受是,这个系统的使用门槛其实挺低的。比如国内也可以直接访问,不需要额外的网络设置。我甚至把这个网站发给我爸妈,他们完全没有机器人背景,我简单教了一下怎么连接、怎么操作,他们也可以直接上手玩。
所以这个云端服务是我们特意做的,希望大家可以随时通过网页访问和体验,不需要复杂的配置,就能直接用起来。
在交互过程中也会出现不符合物理的现象?
对,其实可以这样理解:如果你给模型一些不合理的动作,它本身没有见过这样的数据,就很难做出合理的预测。因为这个模型本质上还是从数据中学出来的,并不是“理解一切”的。
就像自动驾驶里的world model,如果你在正常道路上开,它可以做出比较合理的预测;但如果你把车开进一栋楼里,这种情况它从来没见过,那它也很难给出合理的结果。
目前一个比较大的限制是缺乏力反馈。这主要是因为我们当前使用的机器人平台本身没有提供这部分信息。但这个问题在未来是可以解决的。比如下一步,我们也在考虑引入力相关的反馈,让模型能够更好地理解接触和约束关系。这样的话,当出现一些不合理的动作时,模型就能意识到“这个是做不到的”,而不是继续产生穿透之类的不合理预测。
现在我们做的更多还是第一步,主要是视觉这部分。后面其实也在考虑把更多模态加进来,比如力反馈、触觉信息等,让模型对交互的理解更完整。这也是我们下一步想做的方向。
未来基于这个工作优化的方向?
我觉得在第一个方向上,我们其实还有很多可以做的后续工作。
一方面是模型本身的优化,比如让模型更稳定、更准确;另一方面是在下游应用上的探索,比如刚才提到的control和planning,这些其实都有很多可以继续深入的空间。
另外一个我觉得很重要的点是数据本身。现在我们对“什么是好数据”的理解,其实还是比较经验性的。比如目前更多是我自己根据经验,用world model的表现去判断数据好不好。
但未来可能需要更系统、更严格地去研究:到底什么样的数据是好的,什么样的数据是无效甚至有害的。
所以从模型到应用,再到数据,这个方向其实还有很多值得继续深入的研究问题。
这个工作的心路历程
我觉得这个工作,对我来说还挺特别的。其实在很早之前,上一次跟你聊的时候,我们就已经在想,要不要去做一个“尽可能完美”的world model。但当时其实没有预想到它会这么难。
这个工作我们大概做了一年半。我来哥大没多久就开始做了,所以整个过程投入了非常多的时间和精力。
一方面来说,我们对最后的效果和impact还是比较满意的。但另一方面,回头看,一年多前大家其实对这个问题的难度是低估了的。很多人一开始会觉得,world model这种东西可能会有很多hallucination,很难真正work。
但我们后来发现,其实在动作比较合理的情况下,模型并不会出现那么多严重的幻觉,反而是可以比较稳定地工作的。这一点我觉得还是挺有意思的,也是这个工作一个比较重要的发现。
超出预期的难度
我觉得这个过程里,一个很难的点在于,你需要同时找到模型和数据两边的“recipe”,而这两件事情都不容易。
尤其是数据这块,其实是最难的。你很难一开始就知道什么样的数据是“好”的,而且数据采集本身也不容易,更重要的是,它很难被量化地去分析。相比之下,模型还相对好一些,因为模型是有参数、有代码的,你可以比较系统地去调。
但数据更多是经验驱动的,你往往是凭感觉觉得这种数据可能是有用的,然后去尝试。
所以整个过程其实是模型和数据两边同时在不断迭代。
另外一个现实问题是训练周期很长。一次训练可能要几天时间,你才能看到结果,验证你的直觉对不对。这就导致整个迭代过程比较慢。
中间还需要不断去尝试不同的方法、结合不同的技术,把它们整合成一个比较合理的系统。这过程中其实踩了很多坑。
最后是当你把这些细节都一点点理顺之后,还需要跑大量实验去验证整体效果。所以整体来说,这个工作确实花了很长时间。
当时觉得会做不出来吗?
当然是有风险的。但另一方面,我当时其实已经接近毕业了,所以导师也鼓励我可以更大胆一点。
我现在回头看,会觉得这种策略是比较合理的。就是在博士前几年,可以多做一些相对低风险的项目,有点像在“搭一个投资组合”。这个想法其实是我两三年前在MIT实习时听到的,当时和Leslie、Thomas两位教授聊天,他们提到做研究也应该像做portfolio一样。
就是说,你要同时有一些低风险项目,保证你能毕业、能有稳定产出、能找到工作;同时也要有一些高风险项目,这些项目可能带来更大的impact。当然,如果失败了,也不会影响整体。
所以我会把这个工作看作是我portfolio里比较高风险的一个项目。但很幸运的是,最后我们确实把它做出来了,这一点我还是挺开心的。
第二部分 关于世界模型的概念和分类
6. 世界模型最近有什么实质性的进展或者突破?
这是一个非常好的问题。首先,从更长的历史来看,世界模型其实并不是一个新概念。早在机器人之前,比如航空航天领域,就已经在使用类似的模型了。虽然当时不叫“世界模型”,更多叫动力学模型(Dynamics Model)。本质上就是:给定当前状态和动作,预测未来状态。有了这样的模型,就可以用于控制,比如决定怎样操作,才能让飞机或火箭到达目标位置。
在机器人领域也是类似的。在robot learning兴起之前,很多方法就是手工建模动力学,再用这些模型去做控制,例如经典的Model Predictive Control。这些其实都可以看作是世界模型的早期形式。之所以最近世界模型又变得很火,主要是因为基于学习的方法和多模态模型的发展。
从Robot Learning的角度来看,我个人会把当前的世界模型大致分成两类:第一类是3D世界模型,比如基于点云的模型,可以直接在三维空间中预测环境变化。第二类是偏2D/视频的世界模型,比如视频预测模型以及一些交互式的世界仿真器。这两个方向近期都有不少工作出现。
更广义一点说,只要能预测未来的模型,有些人都会把它叫做世界模型,比如Sora这类视频生成模型。但在机器人领域,一般会要求模型不仅能预测,还要有action作为输入,也就是“我做了什么动作,世界会怎么变”,这样才更符合机器人里的世界模型定义。
再说到“世界模型在机器人中的应用进展”,我觉得可以从三个方向来看:
第一是策略评估。机器人策略的评估一直是个难题,因为没有统一环境,也难以复现。世界模型提供了一种思路:把策略放到模型中“跑一遍”,用来评估好坏。
第二是数据生成。过去世界模型很少用于生成数据,一个重要原因是速度太慢,无法交互。而现在一些工作开始能做到更快、更接近实时的预测,这就使得用world model来生成训练数据变得可行。
第三是control和planning。也就是直接用world model来做决策,比如通过模型进行规划,或者辅助学习控制策略。这方面也有不少工作在推进。
总体来看,我觉得当前世界模型确实有一些重要进展,特别是在表达能力和多模态建模上。但如果说“真正解决机器人问题”,还在比较早期阶段。不同类型的world model,其实适用于不同的应用场景,现在整体还处在一个探索阶段。
怎么理解用世界模型做机器人策略评估?
当我们训练好一个机器人策略之后,一个核心问题是:这个策略到底是好还是坏?相比之下,视觉领域有统一的benchmark,大家可以在同一个数据集上测试模型效果。但在机器人领域,这件事情就困难得多。
因为机器人存在很多不一致性:不同实验室的硬件不一样,环境不一样;即使是同一个环境,在不同时间测试,结果也可能不同。因此,很难对策略进行标准化、可复现的评估。
而世界模型的一个重要优势在于,它可以作为一个“评估引擎”。通过世界模型,我们可以在一个可控、可复现的环境中反复测试策略。例如可以快速跑大量实验,而不需要每次都在真实环境中重新布置场景、重复操作。
相比之下,在真实世界中评估策略,不仅成本高,而且耗时,需要人工干预,比如每次都要把物体摆回相同的位置。因此,使用世界模型进行策略评估,可以显著提高评估的效率和可复现性,这也是大家开始把世界模型作为评估工具的重要原因。
7. World Model和Dynamics Model有什么区别?
两者之间还是有一个比较大的区别。像在航空航天里,大家更多关注的是系统本身的动力学,比如飞机或者火箭的运动,这些动力学很多时候是可以通过数值方法去建模,甚至可以通过物理推导得到的。
但在机器人领域,大家现在说的世界模型,更多关注的是机器人和外界的交互。例如推一个水杯、抓一个物体,这些都涉及到与环境的互动。
而这种交互的复杂性在于:不同场景、不同物体的情况差异很大,很难用一个统一的解析模型或者数值方法来准确描述。因此,通常需要依赖大量数据,通过学习的方式来得到这样的世界模型。
8. 世界模型有哪些主要分类?分类区别在于表征吗?不同类型适合用在什么场景?
3D世界模型
第一类是particle-based的world model,比如李昀烛老师早期的一些工作,包括我博士期间的第一篇工作。这类方法是把世界抽象成少量的点,比如一个物体用几个点表示,一根绳子用若干关键点表示。它的优点是状态空间非常小,因此模型可以做得很轻量,预测速度非常快。
这样一个重要好处是可以很好地用于MPC。因为MPC需要反复调用模型去评估大量候选动作,如果模型足够快,就可以支持高频、并行的计算。但缺点也很明显,就是这种表示会丢失很多细节信息。
第二类是基于point cloud的world model,比如最近的Point World。这类方法的表示更密集,一个场景里可能有几千甚至几十万、上百万个点,因此表达能力更强,但建模和预测的难度也更大。最近一些工作通过更好的模型结构和更大规模的数据,使这类方法变得可行。
它们的应用和前一类类似,主要也是用于MPC和planning,但由于表示更丰富,可以处理更复杂、更广泛的任务。
2D世界模型
2D世界模型的分类,可以从输入输出形式来划分。
第一类是既输出动作也输出图像的模型,也可以叫video-action model。比如一些工作中,模型输入是图像、动作甚至文本,输出既包括未来的图像,也包括对应的动作。这类方法和diffusion policy比较接近,但相比只输出动作,它多了一层对未来视觉结果的建模,更符合“先想象再行动”的思路。
Video-action model:Input:S、A;Output:S、A
第二类是只输出图像的模型,更接近视频生成模型,比如Sora这类。它们通常用于高层规划:给定当前状态和任务,预测未来场景会如何演化,然后再由底层控制模型去执行。这类方法更像是high-level planner。
Video-generation model:Input:S、Text;Output:S;
第三类是输入为当前图像和动作,输出下一帧图像的模型,这一类更接近经典的world model,也就是动力学模型。它直接建模“做了一个动作之后,世界会如何变化”,因此更适合用于控制相关的任务。
Video-generation model:Input:S、A;Output:S;
总体来说,不同类型的world model主要区别在于state的表征方式,以及输入输出的设计。这些差异也决定了它们更适合的应用方向,比如有的更适合planning,有的更适合control,有的更偏向数据生成或仿真。
World Labs和AMI可以归为哪一类?
我对他们内部正在做什么也不太知道,但是根据已经公开的work和我自己的理解,像李飞飞他们这一类工作,其实可以归在3D世界模型这一类,但和机器人里的world model还是有点不一样。
比如他们之前做的那些工作,是生成一个场景,然后你可以在里面移动摄像头,从不同视角去看这个世界会怎么变化。所以本质上,它是在建模“视角变化下的世界变化”,底层确实是3D的表征。
但它的“动作”其实是摄像头的运动,而不是机器人对环境的操作。也就是说,它不会去改变环境本身,比如推物体、抓物体这种交互是没有的。所以更像是建模“看”的变化,而不是“动”的变化。从这个角度来说,它可以算3D world model,但更偏视觉和空间理解。
然后像AMI这一类,其实更接近2D或者说隐空间里的world model。它的特点是不会直接在像素空间里做预测,而是先把图像变成一个feature,比如用类似DINO这种模型提取特征,然后在这个特征空间里去预测未来。
这里面一个关键点是表征本身。你用什么样的表征,会直接影响预测效果。比如表征越复杂,信息可能更多,但预测也更难;有些表征更适合做视觉任务,但不一定适合做预测;有些表征更适合做预测,但可能信息没那么全。
所以他们更多是在研究,到底什么样的表征更适合做这种“预测未来”的任务。
另外我感觉他们的出发点也和机器人不太一样,他们不一定是特别关注怎么拿这个模型去做控制,而是更偏从视觉或者表征学习的角度,去理解这个问题。总体来说,大家是在做类似的事情,但切入点不太一样。
9. 怎么看Video-Action Model这类世界模型?
Video-Action Model也就是同时去预测动作和对应的视觉变化。在这种设定下,它的训练方式其实已经和扩散模型、或者扩散策略这类方法比较接近了,而不再是传统那种纯粹的动力学建模方式。
但像这类方法,其实不太适合直接用来做MPC。一个主要原因是,它们的输入通常并不是condition在action上的,也就是说模型本身并没有显式地把动作作为输入条件。
相反,它们往往是把动作作为输出的一部分来预测。因此,在这种设定下,很难像传统world model那样,用来做基于动作的规划或者控制。
从这个角度来看,这类方法其实更接近于diffusion policy这一类方法,而不是传统意义上的model-based方法。也就是说,它们离“用模型做控制”这件事情会稍微远一点,这是我的理解。
但有意思的是,这些方法也都被称为world model?
所以这里就有一个挺有意思的点:现在在机器人领域,包括具身智能,大家开始说,不一定要用VLM作为backbone,也可以用video generation model作为backbone。从这个角度看,相当于是把刚才说的那一类2D、基于图像的世界模型,真正开始用到机器人系统里面来了。
我觉得一个重要原因是,大家发现这些video model本身已经隐含了很多对世界的理解。
比如像一些视频生成模型,在使用过程中可以观察到,它们其实已经能够一定程度上理解物体之间的交互关系,以及三维空间中的视角变化。这说明模型内部已经学习到了不少“隐性的世界知识”。
所以现在大家在探索的是,如何把这些video model引入到机器人中,利用它们已经学到的能力,比如对物体交互的理解、对三维世界结构的理解。这是一个比较高层的思路,具体实现上,不同工作的方法会有很大差异。
和现有的视频生成模型对比?
现有的闭源视频生成模型目前还是存在一些问题。首先是物理上的“幻觉”,也就是生成结果不符合真实物理规律。这一方面是可以理解的:一是它们的训练数据里,和机器人相关的数据其实并不多;二是它们主要的应用目标,还是偏向于视频生成,比如更像电影效果,而不是为了真实交互和控制。
不过我觉得这也是一个未来的方向:如何从这些已经很强的模型中,进一步训练或适配出可以直接用于机器人的模型。
另外一个现实问题是速度。这类大模型在推理速度上还是比较慢的,也限制了它们在交互式机器人任务中的应用。这也是为什么我们在这个工作里,没有直接使用这些现成模型,而是选择自己从头训练一个更轻量、更可控的模型。
但从长远来看,随着算力提升和数据变多,也许可以直接基于这些已有模型进行微调,得到适用于机器人的版本。我觉得这是一个很有潜力的方向。
不过在当前这个工作里,可以看到的是,这些闭源大模型在我们这个任务上的表现,还是不如我们自己训练的小模型。
10. 关于世界模型的一些问题
世界模型是不是一个更加吃资源的方法?
我觉得这个问题可以从几个角度来看。
首先,从数据角度来说,world model相比模仿学习,确实需要更多的数据。因为模仿学习只需要输出动作,而world model不仅要输出动作对应的结果,还要预测整个图像或者状态变化,所以约束更多,数据需求也更大。
但我觉得这是一个更正确的方向。因为从人的角度来看,人本身其实也是有“世界模型”的。比如心理学的一些研究表明,人会在脑子里预测:我做一个动作之后会发生什么。比如我去抓一个物体,我会预期它会跟着我的手一起动。
这也带来一个好处,就是系统更可解释。当机器人做一个动作时,我们可以理解它的“意图”:比如它这样抓,是因为它知道这样可以把物体拿起来;它这样推,是因为它预期物体会往某个方向移动。
另外,从数据的角度来说,world model其实更有潜力做规模化。模仿学习往往依赖高质量的专家数据,对数据要求比较严格,比如动作要平滑、成功率高等,这在实际中是比较难大规模获取的。
但world model可以容忍更“脏”的数据,甚至更偏好多样化的数据,包括失败、随机探索等。这反而让数据更容易获取,也更有助于模型学习到更全面的行为,比如如何避免失败。
所以从这个角度来看,我觉得world model是一条更有扩展性的路线。
当然,这条路线目前做起来也不容易。它需要更多的数据、更大的模型,同时在一些场景下还要满足实时性的要求,这些都是实际的挑战。
但整体来说,我对这个方向还是比较有信心的,未来还有很多值得探索的问题。
具身需要单独的世界模型吗?还是可以用通用世界模型?
我觉得具身还是有必要专用的world model。
第一个原因是,即使现在一些基座级的world model已经做得很好,它们的训练数据往往还是受限的。比如有些是在特定机器人平台上训练的,或者像一些视频生成模型,甚至完全没有用过机器人数据。所以如果你希望这个model真正适用于自己的机器人平台,还是需要在自己的数据上去训练,或者至少做适配。
第二个是,从方法上来看,现在大家还在探索如何把world model和policy learning形成一个闭环。也就是说,如何从world model出发,最终得到一个真正好用的control policy。这件事情目前还没有一个特别有说服力的结果。
因为从现实角度看,很多时候模仿学习已经可以直接得到一个不错的policy,所以大家会问:world model是不是“非用不可”?这个问题目前还没有被完全回答。
但我自己的一个判断是,world model是有潜力带来更高上限的。比如现在的模仿学习策略,成功率往往还达不到特别高。我会倾向于相信,如果world model这条路线走通,有可能可以学出接近100%成功率、更加稳定的策略。当然,这个闭环目前还没有完全实现。
我觉得接下来一两年,应该会有更多工作去把这个闭环打通。
所以从产业角度来看,我会建议公司至少要提前布局这个方向,而不是等它已经被验证非常有效之后再去做,那可能就晚了。
更实际一点说,可能需要“两条腿走路”:一方面继续用好现有的模仿学习体系,另一方面也要开始搭建world model的能力。
虽然现在world model的很多应用还是在支持模仿学习的开发,比如生成数据、做评估,本质上还是在服务于模仿学习,但我觉得这是一个过渡阶段。未来它很可能会成为policy学习中一个非常核心的组成部分。这是我个人的判断。
怎么理解上面提到的闭环?
我觉得这个闭环的实现路径,其实不止一种。
我自己目前有两个比较主要的判断。第一个是更接近你刚才说的那种思路,也就是类似MPC这种路线:基于world model去做planning,通过预测未来状态,再反推出当前的最优动作。
第二个是把world model当作一个“环境”,在里面直接训练强化学习的policy。也就是说,用这个模型去生成数据,然后在这个环境里不断优化策略。
我觉得我们这个工作,其实让这两条路线都变得更可行了一些。不管是做planning,还是做强化学习,都有可能基于这样的world model来实现。
当然,这只是我目前的判断,未来也可能会出现其他方式。但我觉得至少这两条路径里面,很有可能会有一条是能够真正走通的。
那其实从形式上看,world model本质上是不是一个自回归模型?
至少我们现在构建的这类模型,是自回归的。也就是说,在预测时不断用当前预测的结果作为下一步的输入,去生成更远的未来。
从这个角度来看,大多数world model其实都会带有一定的自回归结构。因为在推理阶段,你需要不断往前预测,而未来是一个无限展开的过程,所以必须一步一步往前rollout。
Reference:
汪怡暄主页:https://www.yixuanwang.me/
Interactive World Simulator:
https://www.yixuanwang.me/interactive_world_sim/
石麻好物推荐
看具身智能方向的投资人、创业者可能最近一段时间都异常忙碌。很多项目需要判断,很多人还要聊,出差忙碌一周之后,非常需要周末带着家人孩子,去海边chill一下。推荐一个很解压,并且适合大人小孩一起玩的产品,5分钟上手,自己弹奏出喜欢的旋律和歌曲,适合一家人聚会或者户外休息的时候,一边演奏一边发呆。我自己是上手即上头,也推荐给石麻笔记的读者。