有人说解决机器人通用操作的问题,无疑等同于解决了AGI,通用操作是AI发展的终极难度。但如果解决了机器人的通用操作问题,无疑会引起新一轮生产力的变革,它大到足以颠覆我们的生存体验,纵使再难,也值得被解决。沿着这个思路,石麻笔记一直更关注解决操作任务的学术工作。我们之前做过灵巧操作的综述(将机器人的手牵向人类的手:灵巧操作华人论文综述),写过模仿学习+DP(Diffusion Policy—基于扩散模型的机器人动作生成策略),写过强化学习+真机(对话罗剑岚:强化学习+真机操作可以很Work),也写过可微仿真+仿真(EP8对话淦创、周衔:RoboGen如何通过生成模型和可微分模拟大规模合成机器人示教数据(附可微分物理引擎论文综述))。
而如今,在北美明星初创公司PI的影响下,国内具身智能创业公司清一色的端到端模仿学习路线,是否过于有共识?在一个完全黑盒的学习框架下学习出来的机器人策略真的可以用于人们的生活中吗?从落地的角度,我们是否更应该关注那些相对可解释、更模块化,或者用更流行的说法更加“分层”的方式来解决机器人通用操作的问题?
今天我非常隆重的和大家介绍一条在国内没那么多人关注,但非常值得更多人关注的路线,通过基于学习的动力学模型来解决机器人操作问题(Learning-Based Dynamics Models)。
我知道大多数人看到Learning Dynamics+MPC和我第一次听到这个概念一样懵。但这种懵的状态非常好,它就是好奇心和学习的动力来源。为了进一步了解Learning Dynamics+MPC,我非常荣幸的邀请到了这条路线上做的最好华人教授李昀烛老师做了一起专访,同时也非常感谢李昀烛老师组里的博士生汪怡暄(可以参看Yixuan之前两个工作的采访GenDP:3D动态语义对Diffusion Policy泛化性的提升)向我第一次科普这个概念。
李昀烛现为哥伦比亚大学计算机科学系的助理教授,在加入哥伦比亚大学之前,他曾在伊利诺伊大学香槟分校(UIUC)计算机科学系担任助理教授。他还曾在斯坦福大学视觉与学习实验室(SVL)做博士后,与李飞飞和吴佳俊合作。他在麻省理工学院(MIT)的计算机科学与人工智能实验室(CSAIL)获得博士学位,导师是Antonio Torralba和Russ Tedrake,并在北京大学获得本科学位。
以下这篇文章,希望你和我一样,在通用操作技术路线路径的认知上,增加一条非常有潜力的路径:Learning Dynamics+MPC。
查看原文目录
以下为本文目录
👇
1. 什么是基于学习的动力学模型
与人的学习过程对比
与其他领域的交叉
2. Learning Dynamics的核心—预测模型
3. 基于学习的动力学模型的状态表示
4. 对可形变物体的建模—基于粒子的表示
什么样的模型结构处理粒子是最好的?
5. 与可微物理引擎有什么区别?
6. 与Transformer这种模型结构的结合
7. Leaning Dynamics和RL怎么结合?
8. Leaning Dynamics和VLA?
9. 这个模型适用于仿真还是真实世界?
10. 与目前模仿学习如何对比?
1. 什么是基于学习的动力学模型(Learning-Based Dynamics Models)
这个大的方向其实是非常直观的,它就是基于intuitive physics,也就是直觉的物理学。你可以这样理解:人类对环境有非常强的直觉性预测能力,我们能够预测自己的行为会对环境造成什么样的影响。比如,当你去捏一个面团时,面团可能会发生形变;或者当你推一堆颗粒状的物体,比如咖啡豆时,这些咖啡豆会移动或散开。
人类对周围物理世界有着强烈的直觉理解,我们通过多种感官模态,如视觉、触觉和听觉,与环境互动并观察场景的变化。在这些互动过程中,我们的大脑处理感官数据,构建世界的心理模型,并预测如果我们施加特定的动作,环境会如何变化。这种物理学的直觉理解并不依赖于显式的物理学公式,并且能够应用于各种材质的物体(即刚体、可变形物体和流体)。
这种预测能力其实非常具有普适性(generalizable)。我们能够预测自己的行为对刚性物体(rigid objects)、可变形物体(deformable objects)、颗粒物体(granular objects)、甚至柔性物体(如绳索)会造成什么样的影响。这种能力无时无刻都存在于我们的脑海中。当我们人类做决策时,往往就是基于这样的预测能力来规划自己的行为。
比如说,当我们希望把手机从一个点推到另一个点时,我们大概可以预测推的动作会对手机在桌子上的状态造成什么样的影响,比如它会怎么移动,或者会如何旋转。正是这样的预测能力帮助我们规划自己的推动作,从而使手机达到目标状态。
在这里,你可以完全理解这种预测能力,其实就是基于当前状态和行为,来预测这个世界未来会发生什么样的变化。这种能力可以被抽象为一个模型,而这个模型有很多不同的名字。你可以认为它是一个模拟器(simulator),也可以称它为基于直觉的物理模型(intuitive physics),或者叫做世界模型(world model)。它的本质是预测世界的状态如何随着行为而变化。
因此,开发能够让机器人理解自身行为对环境影响的预测模型,将极大地帮助其实现通用操作。这类似于人类的直觉,使其能够根据预测的结果制定有效计划以完成预定任务目标。基于物理的模型(physics-based models)虽然在泛化能力上强大,但通常需要完整的环境状态信息——这在复杂的操作任务中往往难以实现或不可能实现。基于学习的动力学模型则提供了一种替代方法,它通过直接从原始感官观测(observation)中学习预测模型,能够捕捉那些在分析模拟中难以建模的因素。
Learning Dynamics与人的学习过程对比
我们的目标是直接从真实世界中学习,这与人类的学习过程非常相似:人类通过与环境的真实交互来学习并构建自己的模型。这种学习方式可以称为“直觉物理学”(intuitive physics),因为它模拟了人类在日常生活中通过经验积累和与世界的互动,逐步建立对物理现象的理解和预测能力。
“直觉物理学”指的是我们对物理世界的直觉理解,这种理解通常是基于经验和感知,而不是通过明确的计算或数学推导。例如,我们知道如何抓住掉落的物体,或者预测一个球弹跳的轨迹,这些都是通过与环境的互动获得的知识。这种学习方式具有极强的可扩展性,并随着与环境交互的增多,使我们的预测能力不断增强。
Learning Dynamics与其他领域的交叉
与计算机视觉:基于这个预测模型,它会与很多领域产生交叉。例如,它可能与计算机视觉领域相关。视觉的本质是一种感知(perception)的过程,主要是将高维度的输入(比如视觉或触觉信号)映射为对环境的状态表示。比如,它可以捕捉物体的六个自由度姿态变化,或者像DPI-Net那样,将物体的状态建模为粒子之间的变化。这种能力使得视觉模型可以很好地与预测模型结合,从而描述环境状态。
DPI-Net (ICLR 2019)
与图形学:同时,这种预测模型还可能与图形学产生结合。它与一些基于物理的模拟器或可微分模拟器(differentiable simulators)相关。在训练这种模型时,我们通常基于神经网络,这种模型本质上是可微分的,因此可以通过提取梯度(gradients)来优化模型的性能。
与控制与优化:此外,它还与控制与优化领域有很强的交叉关系。理论上,这种预测模型本质上是一个前向模型(forward model),即从当前状态和行为预测未来会发生什么。而这里还有一个有趣的对比是逆向模型(inverse model),它的作用是基于当前状态和目标状态推导出需要采取的行为。前向模型和逆向模型的区别在于:前向模型是从当前状态和行为预测未来状态;逆向模型是从当前状态和目标状态推导出需要采取的行为。
通过这些不同的结合和交叉,预测模型可以帮助我们理解并控制复杂的环境,提供强有力的工具来优化决策和行为规划。
2. Learning Dynamics的核心——预测模型
对于强化学习,它本质上是一个策略学习,即学习一个策略函数(policy function)。这个策略函数将当前的状态和你想要的目标状态作为输入,输出的是你想要的行为。而预测模型与之相反,它是根据当前的状态和你执行的行为,去预测未来的状态是什么。
换句话说,尽管强化学习和预测模型都基于当前的状态,它们的目标和方法是不同的。预测模型关注的是你的行为会如何影响当前状态,而强化学习中的策略学习则关注的是“我要到达目标状态,需要采取什么样的行为”。
因此,本质上,强化学习和预测模型可以视为一体两面的过程:预测模型是一个前向模型(forward model),而策略学习则是一个逆向模型(inverse model)。
我们通过学习这个模型,并基于它来进行机器人的行为规划。这与我最开始提到的,我们人类的直觉类似:从小到大,我们通过与环境的无数互动,逐渐学会预测自己的行为会对环境产生什么样的影响。人类具备这种能力,并且这种能力正是通过我们与环境的交互来获得的。我们希望机器人也能拥有类似的能力,且希望这种能力同样能通过机器人与环境的交互来学习。
所以,正如我之前提到的,人的预测模型能够很好地适应各种材质的物体,比如刚性物体、可变形物体、流体、颗粒物体、绳子、衣物等。我们过去的许多工作也都是围绕着如何通过机器人与环境的交互,收集数据并基于这些数据学习前向预测模型。比如,我们曾经的工作就涉及到绳子、布料,甚至面团。
RoboCook (CoRL 2023)
比如RoboCook,这个工作可以看作是DPI-Net(Particle Network)的一个后续进展,只是具体任务更加复杂,但本质上仍然是基于粒子作为一个对环境的描述来学习向前的预测模型。我们的目标是预测不同工具对面团形状的影响,比如在执行某种特定操作时,面团的形状会发生怎样的变化。这个过程本质上就是一个预测模型。
而这个预测模型不仅可以用于前向预测,还能用于解逆向问题。比如,学习策略函数(policy learning),进行轨迹规划(trajectory optimization)等,都可以通过这个预测模型来解决。我们过去一系列的工作,主要集中在如何学习不同物体的预测模型,包括基于绳子的预测模型、基于衣物的预测模型、基于面团的预测模型,以及如何建立针对颗粒物体(如一堆咖啡豆、一堆方糖、胡萝卜丁等)的预测模型。我们的目标是利用这些预测模型,通过对环境的描述来预测物体在特定操作下的变化,并进一步应用于机器人的行为规划。
3. 基于学习的动力学模型的状态表示及模型选择
预测模型的核心任务是基于当前的状态和输入的行为来预测下一个状态。那么,关键问题是:这个“状态”应如何定义?它是一个图像,还是潜在空间的向量(latent vector)?它是否介于两者之间,包含3D信息,或是否包含一些语义信息?如何定义状态在很大程度上决定了模型的学习难易度、设计方式以及最终应用于planning和control时的能力。
我们之前开展了很多研究,探索了不同状态描述(state representation)的优势与劣势,并分析了它们的能力。例如,对于刚体(rigid object)——即不可形变的固体——通常使用六自由度(6-DoF pose)描述,即物体的位置和旋转角度。然而,这种六自由度的描述方法在处理像绳子或布料这样的可形变物体时并不适用,必须使用其他描述方式。
在处理像绳子和布料这样的物体时,我们发现使用粒子(particles)作为环境的描述非常有效。粒子可以直接从三维视觉信息中获取,用来描述物体的形状;也可以描述物体内部的交互作用,例如绳子是否能弯折、是否能被拉伸;同样,布料的粒子也能描述它们之间的相互作用。这种粒子表示方式不仅能描述物体的形态,还可以用于物体间的相互作用,例如刚体和布料之间的相互作用。因此,粒子作为环境的描述既通用(universal),又灵活(flexible)。
GS-Dynamics (CoRL 2024)
总的来说,世界状态的描述对学习预测模型至关重要。状态描述有多种选择,如刚体(object)描述、粒子(particles)表示、像素(pixel)表示或将环境映射到潜在空间的向量(latent vector)。这些都是有效的表示方式,甚至更稀疏的粒子,如关键点(key points),也可以作为状态的描述。因此,选择适当的世界状态表示方式对于构建基于学习的预测模型是一个重要决策。
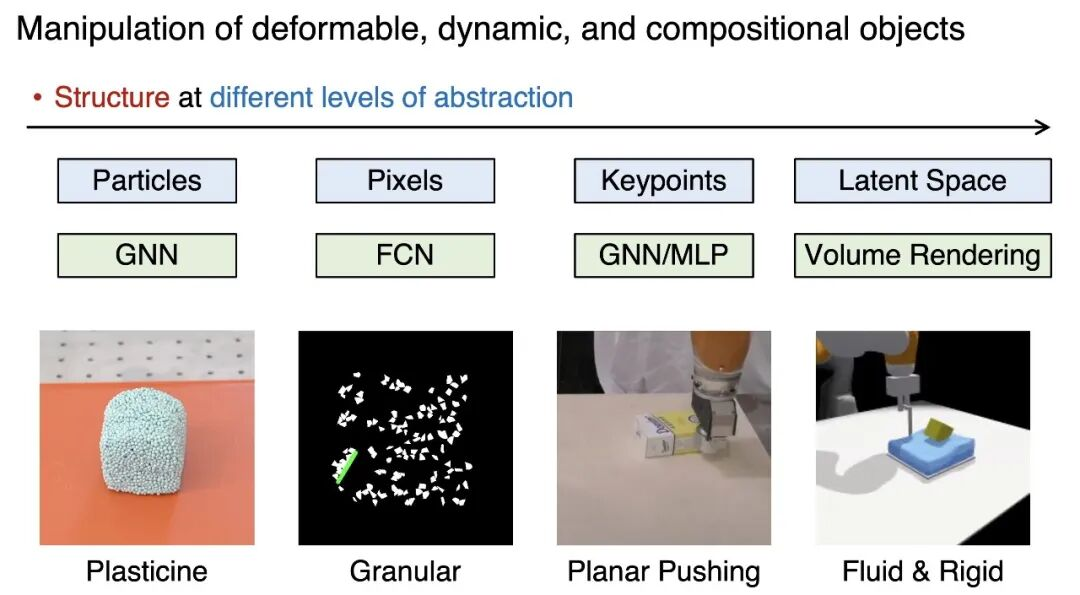
一旦确定了状态描述,接下来就需要定义模型的结构。虽然模型本质上都是神经网络,但根据状态描述的不同,模型的形式可能也有所不同。如果输入是图片(二维图像),模型通常是卷积神经网络(CNN)。而如果输入是粒子集合,那么模型可能需要能够灵活处理这些粒子的模型,如图神经网络(Graph Neural Networks,GNN)、Transformer模型,或像PointNet这样的灵活结构。如果输入是Latent Vector,由于缺乏显式的物体、空间或时间的概念,通常采用多层感知器(MLP)进行处理。
换句话说,状态描述的选择直接影响后续模型的选择,并决定了如何基于学到的模型来做出规划和控制等决策。
4. 对可形变物体的建模——基于粒子的表示
粒子表示通过使用离散点来表示刚体和可变形物体的表面和体积,能够准确建模三维几何结构。这种方法使得交互建模更加精确,而明确的结构先验则提高了样本效率(sample efficiency)和泛化能力(generalization ability)。
传统上,粒子广泛用于基于物理的仿真技术,如基于位置的动力学(Position-Based Dynamics, PBD)、材料点方法(Material Point Method, MPM)等。这些技术为近年来的基于物理的仿真器提供了动力。然而,这些技术依赖于近似建模,可能会导致Sim2Real Gap,需要复杂的系统识别(system identification)来弥合。作为一种自然的替代方案,基于学习的粒子动力学模型直接从真实世界数据中学习预测动态行为,极大地减少了Sim2Real Gap。
什么样的模型结构处理粒子是最好的?
我们目前发现,图神经网络(GNN)是处理粒子结构的最佳神经网络结构之一。图作为一种数据结构,在许多应用中都非常有效,尤其是在描述物体和物体之间的关系时。图结构相对来说是一种普遍且直观的描述方式,世界上许多事物都可以被转化为图结构,例如社交网络中的人和人之间的关系。
DynRes (RSS 2023)
在图神经网络中,每个节点可以存储关于物体的丰富信息,包括材质、语义以及几何信息,而节点之间的边则能够描述物体与物体之间的相互作用。例如,在基于物理的动力学模型(physics-based simulation)中,往往需要手动定义每种物体间的交互规则,这个过程十分繁琐且复杂——例如,定义刀和牛排之间的相互作用、物体和物体之间的交互等等。如果你将环境描述为图结构,那么图中节点之间的交互关系就可以通过边来表示。这些边不仅仅是连接节点,它们能够编码各种各样的交互信息,涵盖物体与物体之间的不同类型的相互作用。这种方式使得图神经网络能够灵活地处理复杂的交互关系,而无需手动定义每一种交互。
5. Learning Dynamics与可微物理引擎有什么区别?
这个问题非常好,它本质上是对比基于学习的预测模型和基于物理的模拟器(聊一聊“Sim”(上)——一览机器人模拟器生态)的核心区别。实际上,这两者在本质上是相似的,都是在学习一个预测函数,即基于当前状态和行为,预测下一个时刻的状态。可微分的物理模拟器(EP8对话淦创、周衔:RoboGen如何通过生成模型和可微分模拟大规模合成机器人示教数据(附可微分物理引擎论文综述))实际上也在进行同样的模拟计算任务。
不同之处在于,它们的模型结构是不同的。基于物理的可微分模拟器的模型通常由物理公式构成。而基于学习的预测模型则使用神经网络来代替这些物理公式。换句话说,物理规律在学习模型中被神经网络所替代,这是它们的本质区别。
两者各有优势。基于物理的模型具有较好的泛化能力,只要物理公式是正确的,它在多种情况下都能得到有效的预测,而且其可调参数相对较少,通常只有如物体刚度(stiffness)、粘度(viscosity)等具有明确物理意义的参数。而基于学习的预测模型,由于完全依赖神经网络,它们有更多的参数,参数量远大于基于物理的模型,理论上泛化能力也会稍逊一筹。
基于学习的方案有许多优势,其中最核心的一个优势是它不需要知道环境的所有信息,就能学习到一个足够有效的预测模型。举个例子,系纽扣,如果你使用可微分模拟器(differentiable simulator)来模拟系纽扣的过程,你需要知道衣物的所有信息,包括衣物的材质、衣物与人体的接触情况,甚至纽扣与衣物之间的局部连接等细节。如果你不知道你模拟的世界中所有的状态信息的话,你是没有办法做这样一个基于物理的预测的。
然而,人类是不需要知道环境中所有的物理信息或交互公式。通过与环境的无数次交互,我们能够在脑海中构建出一种直觉式的物理引擎。我们不需要详细了解每个物体的物理特性,只需要通过经验和观察,就能对物体如何响应我们的行为做出合理的预测。这种能力是通过大量的数据—即我们与世界的互动—不断积累和学习的,这也是基于学习的模拟器(learning-based simulation, intuitive physics, world models)希望达到的目标。
6. Transformer这种模型结构是否也适合基于学习的动力学模型?
目前我们发现,在相对较小规模的场景中,图神经网络(GNN)表现得非常有效,尽管我们还没有将其规模化,下一步计划是将其拓展至更大的数据规模。就目前来看,在较为局限的复杂场景中,比如包饺子任务(这类任务通常涉及桌面上的操作过程),我们发现图神经网络比 Transformer 更为有效。
实际上,之前有研究指出,Transformer 与图神经网络有很多相似之处,主要区别在于是否显式编码边上的信息。图神经网络主动编码边的信息,而 Transformer 并不会。因此,图神经网络在某些应用中可能比 Transformer 更有优势,尤其是在对边信息有需求的情况下。
接下来,我们计划将图神经网络规模化,考虑两个主要方向。第一个方向是通过大规模数据学习,是否能够构建一个通用的基于学习的模拟器,能够模拟不同材质和交互的多样性。目前,我们通过一组数据训练得到一个特定模型,且在该数据分布下表现良好,但对于不同的数据集或场景,可能需要重新训练不同的模型。因此,下一步目标是研究是否能够构建一个可以建模各种不同交互的通用模型。第二个方向是将其在空间和时间层面上进行大规模扩展,即从目前局限于桌面场景的应用,扩展到房间级别,探索如何将图神经网络与例如 SLAM等机器人模型结合,进行大规模环境建模。这些都是未来扩展的研究方向,仍有大量的探索空间。此外,GNN模型是一个非常容易扩展的结构,扩展方式仅仅是通过添加节点和边而已。
7. Leaning Dynamics和RL怎么结合?
这两者之间并不矛盾,反而是一个互相促进的过程。简单来说,我们最初提出的模型是一个前向预测模型,而无论是模仿学习还是强化学习,它们本质上都是在学习一个逆向的函数——即给定当前状态,我们的动作是什么?它们并不直接预测未来的结果,而是直接预测动作。
这可以看作是硬币的两面,互为补充。我们目前的方向实际上可以归结为模型学习(model learning),模仿学习和强化学习可以成为模型学习基础上的延伸。比如基于模型的强化学习(model-based reinforcement learning),它通过学习一个模型(model),再基于该模型学习策略(policy)。很多强化学习的实现是从物理仿真模拟器中学习策略,而我们完全可以将物理仿真器替换为一个基于学习的预测模型仿真器。这种方法已经被应用到我们的机器人做饺子的项目中,机器人通过这种基于学习的仿真器来学习策略。
可以举个例子,这与自动驾驶中的一些方案非常相似。自动驾驶系统通常会使用预测模型,来预测其他车辆在你的车行为的影响下它们的行驶轨迹会如何变化。通过这样的预测模型,就可以进行轨迹规划,这就是所谓的模型预测控制(MPC)。基于一个能够进行预测的模型来进行轨迹规划的技术就是Model Predictive Control。
8. Leaning Dynamics和VLA?
我们学到的模型和模仿学习也有一个容易的结合点,即通过这个模型和模型预测控制(MPC)相结合。你可以基于这个模型,使用MPC方法优化出一个轨迹,而这个轨迹可以作为模仿学习的ground truth,用于训练模仿学习的策略。它既可以是强化学习的模拟器,又可以是模仿学习的数据生成器。It can be the simulator for reinforcement learning. It can also be the data generator for imitation learning.
现在的VLA(视觉语言预训练模型),本质上就是一个大型的模仿学习模型,输入是视觉和语言数据,输出是动作。目前,很多VLA方案都是通过模仿学习来实现的。如果你有一个高效的世界模型,它就可以作为数据生成器来帮助训练VLA模型。
除了可以做data generator,这些学到的模型从另一方面讲也可以作为一个evaluator。例如,在训练一个大型的策略时,你可能需要评估它的效果。通过在真实环境中进行评估,往往会非常昂贵且噪声较大。举个例子,你早上和晚上进行同样的测试,结果可能会因为光线的区别有较大的差异。我们可以利用学到的模型,作为现实世界的代理(proxy),虽然它不能完全替代真实世界,但相比之下,它更高效、成本更低。通过在学到的模型上进行测试,可以提前筛选出一些表现不佳的策略,从而极大程度上减少在真实环境中所需要做的测试量。简而言之,我们学到的这个模型,不仅可以作为模仿学习的大型VLA的训练数据生成器,也可以作为其评估工具。
9. 这个模型适用于仿真还是真实世界?
这个模型的训练数据来源可以是仿真数据,也可以是来自真实世界的数据。理想情况下,如果你希望模型更贴合真实世界,最好是在真实世界中直接学习模型。当然,另一种方法是先在仿真环境中学习模型,再用真实世界的数据进行调整或精细化(finetune)。这样,尽管生成的数据本身不是来自真实世界,它仍然有很大的可能性与真实世界的数据非常接近,因为模型本身会在真实世界的数据基础上进行学习和优化的。
通过这种方式,尽管生成的“数据”是模拟出来的,但它能够更好地反映真实世界的特征,从而提高模型在实际应用中的表现。
10. Learning Dynamics+MPC与目前端到端模仿学习如何对比?
通过学习模型,你可以更清楚地理解当机器人在真实世界中出现问题时,问题出在哪里。具体来说,当机器人无法正常工作时,你可以分析是因为感知不够准确,导致世界状态估计有误;还是因为重建物体的几何形状不够精准,影响了机器人对物体的理解;或者是因为预测模型本身不够准确,导致失败;又或者是优化过程中的问题,比如MPC未能有效地规划轨迹。通过这种模块化的系统设计,你可以更容易地定位问题的根源。
这种模块化的系统在真实世界应用中具有很大的优势,尤其是当机器人需要在复杂环境中进行大规模部署时。安全性和可调试性(debuggability)变得尤为重要。通过这种方法,你能更清楚地知道每个模块(感知、预测、规划)可能出现的故障,并且能够有效地进行修复。在自动驾驶领域,也正是这种模块化的系统,使得机器人能够在面对现实世界的挑战时,更容易进行测试和调试。
相比之下,如果采用端到端模仿学习(imitation learning)的方法,当机器人出现失误时,很难追溯问题的根源。模仿学习更多依赖于数据驱动的方式,但如果没有良好的模型和模块化结构,一旦系统失败,就很难有效地进行分析和修复。
References:
李昀烛主页
RoboCook
https://hshi74.github.io/robocook/
DPI-Net
DynRes
https://robopil.github.io/dyn-res-pile-manip/
GS-Dynamics
https://gs-dynamics.github.io/