对近三年置身“具身智能”赛道的创业者和投资人,何其有幸,在逐渐吹起的泡沫里,经历着不知道是真的还是假的繁荣和盛况,这个阶段也许是一个巨大技术变革的起点,也许不是,但无论如何,从未来二三十年的职业生涯来看,这几年都是非常珍贵的经历。
作为关注这个赛道的投资人,2026年的上半年都会经历着“又晚了”“还有额度么”的焦虑,不管我们多么努力,总有那么多还没来得及cover就close了前两轮的deal,总有那么多还没来得及见就可能不一定能再见的founder。在巨大的FOMO情绪push下我也不得不频繁出差,石麻笔记更像是一片喧嚣里的安静自留地。出差一段时间,可以窝在岛上,静静地思考这些对话。
两个月前,我和文龙(之前采访记录:VoxPoser & ReKep:从任务表征的角度探究机器人的零样本任务泛化)再一次交流,他娓娓道来的技术洞见,让我在整理这期文字的时候,会沉迷在一段段文字里,思考很久。
在世界模型的众多分类里,有一个分类是3D世界模型,我借着PointWorld这个工作,和文龙聊了很多话题。基于PointWorld的采访,我也进一步采访了对话温伯文:FoundationStereo如何变革双目视觉 和下一期再公布的关于3D重建非常有影响力的工作。期望通过这三篇关于3D基础模型的相关工作,来让我们把注意力带到3D近期突破上。
以下万字长文,适合花上一个小时,慢慢读。
查看原文目录
以下为本文目录
👇
1. 自我介绍
第一部分 关于PointWorld
2. PointWorld的核心思想
3. 怎么理解state和action的模态统一
4. 可以用来统一表征action和state的模态是什么
5. 和人做事情的action和state space都在视觉的3D空间里很类似?
6. 位姿以外的关节力的信息怎么体现在action space
7. 关于2D和3D对相机数量的处理的问题
8. 2D-3D重建的问题
9. 现在3D模型上有什么进展推进了Pointworld这个工作
10. 关于数据的处理
11. 单目+tof可以代替双目吗
12. 为什么StereoFoundation的深度估计效果这么好?
13. PointWorld的模型架构
14. PointWorld的应用
第二部分 关于3D世界模型
15. 为什么要3D世界模型?2D不足够吗?
16. 怎么看现在egocentric数据
17. 3D最大的特点在于可控性
18. 我们有机会获得和人所在的3D世界类似的3D世界模型吗?
19. 我们是不是真的需要世界模型
20. 我们是不是需要先有足够多的机器人数据才会有这样的世界模型?
1. 自我介绍
我目前是在Stanford读PhD,现在是第四年,导师是李飞飞教授。我的研究方向主要是AI+robotics。过去几年,我主要做两个方向的工作。
第一个方向是foundation model for robotics。其实我从2021年左右就开始接触这个方向了,当时还在Berkeley读本科,主要在探索大语言模型能否用于任务理解和任务拆解。后来也围绕这个方向做了一系列工作,包括和Google的一些合作,以及在Stanford期间在李飞飞的实验室继续推进相关研究,比如Code as Policies、SayCan、PALM-E,VoxPoserVoxPoser & ReKep:从任务表征的角度探究机器人的零样本任务泛化。
第二个方向是world model,这个方向是我在2024年暑假开始重点投入的。一方面是觉得这个方向本身很有意思,另一方面也是因为它和我之前的工作形成了很好的互补。之前的foundation model更多是在做任务理解和抽象层面的prior建模,但在fine-grained层面,比如具体执行动作以及counterfactual prediction(例如“执行某个动作后世界会如何变化”),能力是比较有限的。而world model正好可以补上这一点。如果同时具备任务理解能力和对未来状态变化的建模能力,那么机器人就可以基于这两者来更好地生成和决策action。所以目前我主要聚焦在这两个方向上。
第一部分 关于PointWorld
2. PointWorld的核心思想
这个工作的核心是在探究:是否可以训练一个通用的3D world model。
首先,world model这个概念本身其实比较“泛化”,不同人有不同定义。在我看来,从robotics角度,我更习惯把它看作dynamics model:有一个state representation(状态表征)和action representation(动作表征),输入是当前state和action,输出是下一个state。
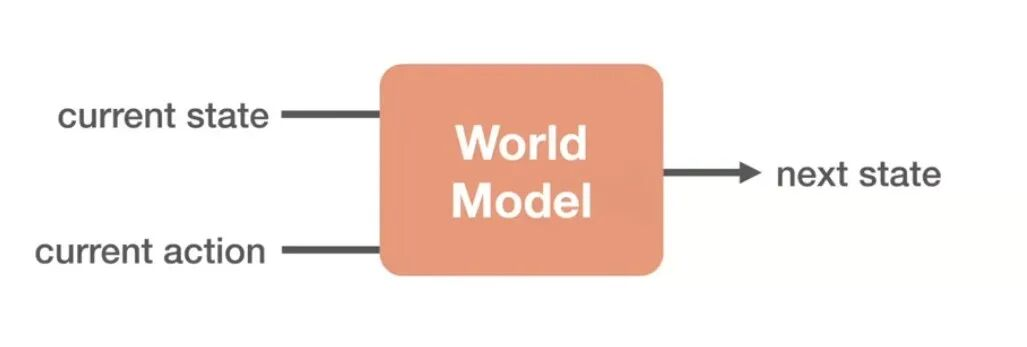
不同world model之间的差异,本质上在于state representation和action representation的定义不同。比如像video-based的world model(例如Genie这类),它的state representation是2D像素序列(video frames),action可能是navigational action(前后左右),输出是下一帧图像。
而我们在PointWorld中,主要探索的是3D的state representation和3D的action representation。这里有一个更偏哲学性的问题:在robotics中,不同机器人、不同任务对应的action representation是高度不统一的。有的是task space(比如末端执行器的3D位姿),有的是joint space(关节空间),不同机器人(比如四足、人形、单臂、多臂)之间差异也很大。
所以我们的一个核心想法是:能否找到一种统一的模态,既可以作为state representation,也可以作为action representation,不仅能轻易从机器人的相机中获取,也可以统一不同的机器人。
PointWorld主要探究的是用3D point flow作为这种统一表示。具体来说,输入是一个static frame的point cloud,这个point cloud可以从机器人onboard的相机获得,比如RGB和depth,通过这些信息可以得到点云表示,而且这个点云不需要是完整的,可以是部分的,只是一个相机也可以。
在这个基础上,我们考虑的是action-conditioned的world model,所以action是已知的。我们可以把机器人对应的3D点流作为输入的一部分。而输出则是:对于输入的环境point cloud中的每一个点,在这个机器人action作用下,也就是环境中的每一个点在执行这个action之后会发生怎样的变化。
从formulation上看,其实是比较简单直观的:环境和机器人均为3D点流,world modeling就被简化为了“预测点和点之间如何相互作用”这个统一的建模问题。这个工作的目标,是在方法上尽量简化,同时探索:这种3D表示是否可以scale up,从而支持训练一个general-purpose的3D world model。
在实践中,这个工作整体用了一年半的时间,我们花了很多时间在数据处理上。当前3D的一个主要瓶颈还是数据处理和质量。不过我们也发现,最近的3D模型已经逐渐成熟,可以支持这种3D world model的训练,尤其是在数据标注方面(例如预测深度, 相机位姿, 点追踪)。
整体来说,这个工作的贡献主要有两点:一是探索如何scale up 3D world model;二是提供了一套相对稳定的pipeline,用于构建3D交互数据和标注。
另外,我们也做了一些初步探索:如果有了这样一个模型,它在机器人操作中具体能带来什么价值,这一部分可以后面再展开。
3. 怎么理解state和action的模态统一
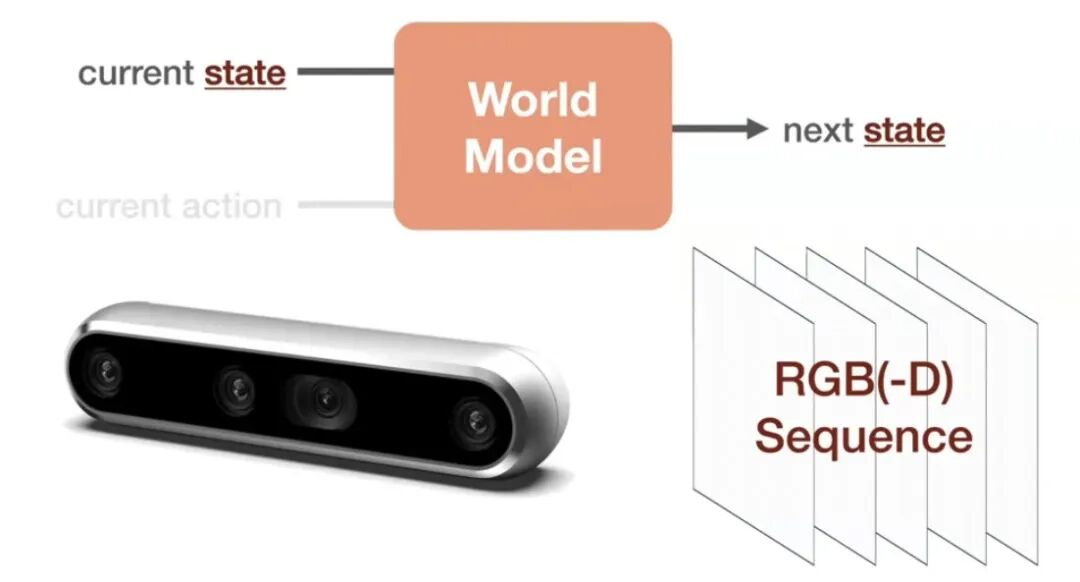
在state representation上,其实分歧不大。因为机器人在真实环境中操作,主要依赖的是机载相机,所以最常见的是RGB视频流。同时,很多机器人也配备了深度相机,可以获取depth信息(RGB-D),因此也可以表示为一个partial point cloud(partial的原因是我们并不能观测到物体背后的点)。这也是我们工作使用的state representation。
但在action上,分歧就比较大。常见的主要有两种:一种是end-effector的task space(比如3D位姿变化),另一种是joint space(关节空间)。
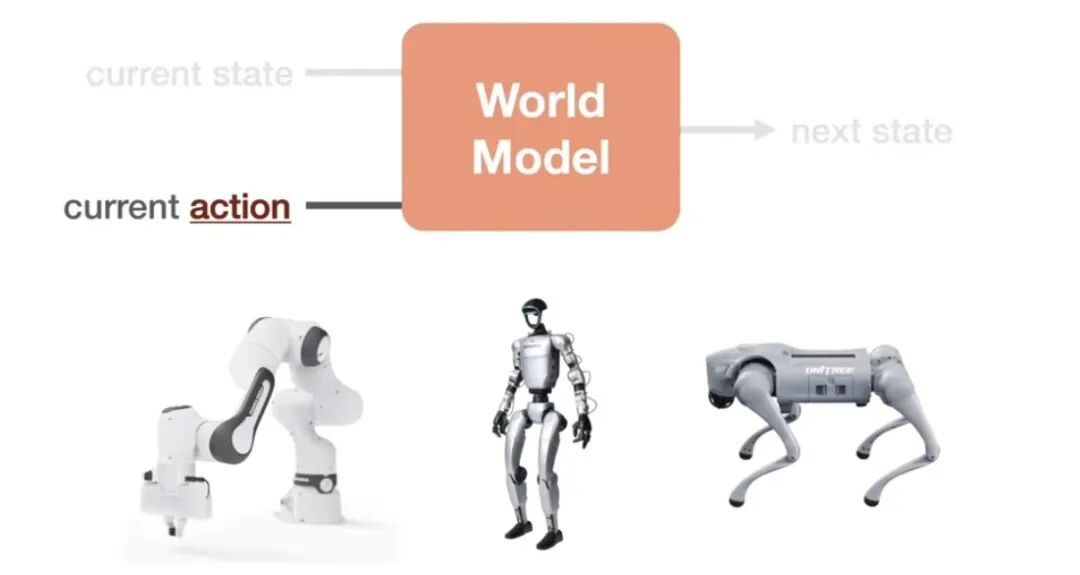
这两种表示方式都有类似的问题,就是在cross-embodiment场景下不统一。不同机器人结构差异很大,比如一个humanoid可能有几十个关节,对应几十维的action;单臂机器人可能是7个关节,加上gripper可能是8维;双臂就是16维;如果是三臂甚至更多,就会进一步增加维度。并且机器人的末端执行器可能是夹爪,也可以是拥有不同手指数量的灵巧手,甚至也可以是一个安装在机器人上的某种特殊工具(例如吸盘或者杆子)。
这个问题带来的直接影响是,如果想训练一个模型(无论是world model还是policy),并希望它能够在不同机器人之间迁移,就会变得非常困难。
4. 可以用来统一表征action和state的模态是什么
刚刚提到,大部分工作使用的是末端位姿或者关节空间的action表示。而我们这个工作的目标,是用同一种模态去统一这些不同的action表示。
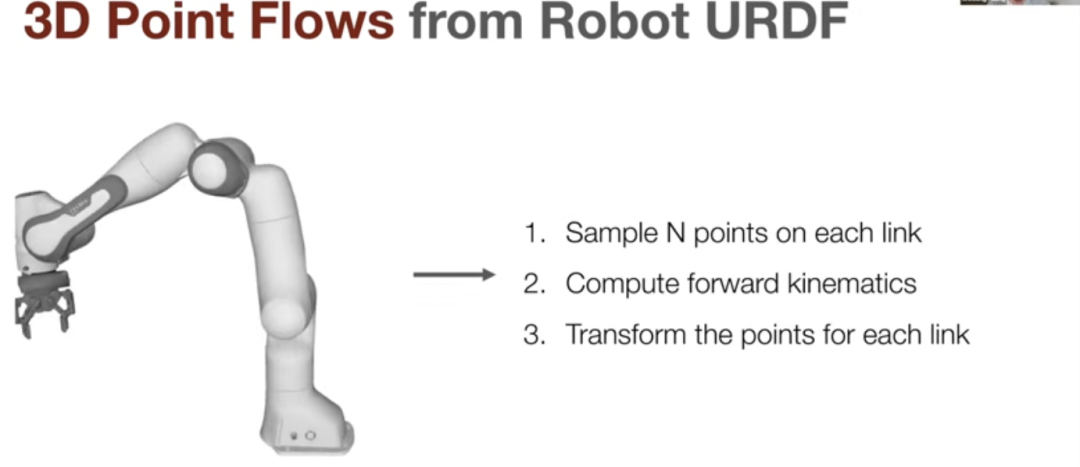
具体来说,我们假设已知机器人的URDF。简单理解,URDF就是机器人的“蓝图”或“结构描述文件”,包含了机器人有哪些关节、每个关节的运动范围,以及对应的mesh结构。
在这个前提下,如果我们知道joint space的action,就可以通过URDF去计算对应的3D点云变化,也就是把关节空间的动作映射为3D point flow。换句话说,URDF提供了一个从关节动作到几何变化的桥梁,使我们可以把不同机器人的action统一转换到同一种3D表示上。
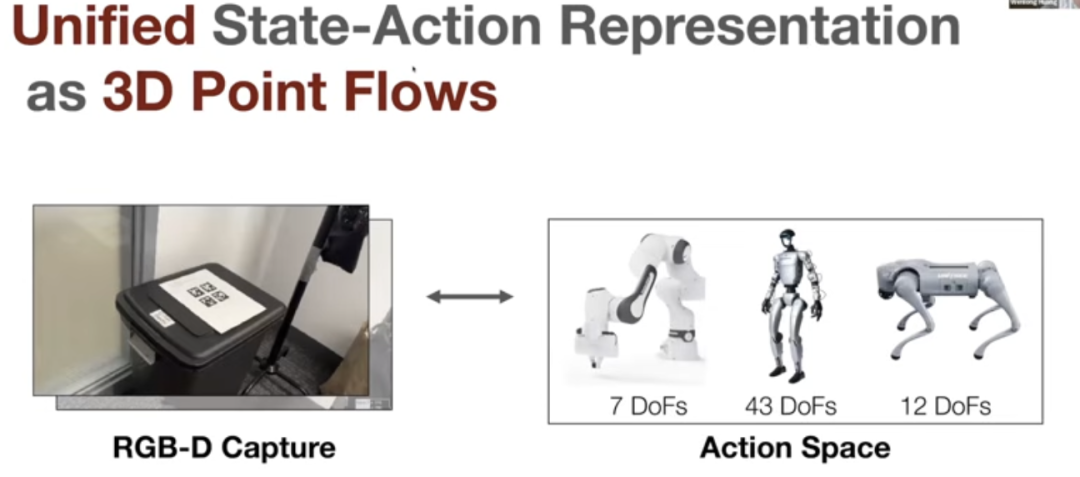
可以这样理解:通过URDF,我们可以把机器人的动作空间,转换成一种3D点云的表示。一个更直观的理解是,从人的角度来看,我们在执行任务时,其实不是在“关节空间”里思考的。比如搬一个大箱子,我们不会去想“每个关节要转多少度”,而是会直接在3D空间里思考:手应该怎么移动,放到哪里,然后把箱子抬起来。
同样地,如果去遥操一个新的机器人,我们也不会先去想它的joint space是多少维、每一维是多少数值,而是更自然地去思考:这个机器人实体(甚至细微到每根手指的表面)在3D空间中应该如何运动才能实现对环境想要的影响。所以用3D point flow来表示action,本质上是在对齐这种更直观的、基于空间运动的表达方式。
5. 和人做事情的action和state都在视觉的3D空间里很类似?
是的,这就是我们的核心philosophy。如果用一串数字来表示action,不仅存在关节数量不同的问题,还忽略了geometry上的差异。比如夹爪,大多数情况下可能只用一个数值表示开合程度,但不同机器人的夹爪在形状、尺寸、结构上差异是很大的;再比如灵巧手,即使自由度相同,不同手之间在大小、粗细等几何属性上也有明显区别。这些几何信息,其实对action本身是很重要的。但如果用低维的控制信号去表示,就会把这些信息压缩掉,从而丢失一部分关键信息。
我们的想法是,希望action的表示方式更接近observation space。也就是说,不是在一个低维的control dimension里去描述action,而是在“感知空间”里去表达它。可以理解为,我们是在用一种类似“观察”的方式去表示action,而不是用抽象的控制信号去表示。
6. 位姿以外的关节力的信息怎么体现在action space
这是一个很好的问题。我们目前其实没有显式去处理“力”这一部分。但从方法上来说,是有比较直接的扩展方式的。例如当前的模型输入是未来的机器人的姿态,我们如果在乎力的输入可以将输入改成joint torque,然后利用URDF里的机器人的动力学信息去计算机器人上的每个点上一个加速度或力的表示,这样就可以把这部分信息纳入建模。
不过在当前工作中,我们主要关注的任务相对简单,更侧重于对环境物理的直觉理解以及泛化性,而不是对精细力控制的建模。也就是说,目前的侧重点在于预测物体在空间中如何运动,还没有拓展到在相同空间轨迹下施加不同的力。
7. 关于2D和3D对相机数量的处理的问题
关于相机的问题,我们的模型在训练完成后,是可以适配任意数量的相机的。这也是3D表示的一个优势。在2D中,不同视角(一个、两个、多个相机)会带来建模复杂度的提升;但在3D中,无论多少视角,本质上都可以统一为点云表示,也就是一组点,因此处理上更简单、更统一。
关于深度信息,在这个工作中我们是默认需要深度信息的。因为3D建模通常需要两个关键要素:一是深度信息,二是相机与机器人之间的外参(也就是它们之间的空间变换关系)。后者其实就是robotics中常说的手眼标定问题,即需要知道相机观测到的内容,在机器人坐标系中的位置关系。
从modality的角度来看,2D模型如果是multi-view,也可以理解成是implicit的3D模型。而在PointWorld的3D表示中,是把这些信息统一到机器人本体的点云空间里,相当于把多视角的观测以及手眼协调统一到同一个空间。
但从信息角度来说,RGB-D多视角信息(加上对应的相机参数)和对应的3D表示其实是等价的。也就是说,从这种方式得到的点云并不比直接用多视角RGB-D提供更多信息,在这个工作里更大的用处是让模型可以在同一个观测空间中处理action。
实际上,即使只有一个相机,PointWorld也可以正常工作,因为我们也可以从单个视角获取点云。
8. PointWorld是否需要3D重建
“重建”这个词本身有不同的定义。在我们的场景里,重建更多是指利用已有的深度信息和观测,得到点云表示,而不是追求mesh级别的高精度重建。
计算机视觉中做3D的目标也不完全一致,有些工作更关注mesh,有些关注3DGS或点云。而我们更偏向于点云层面的表示。
另外一个区别是,我们引入了“机器人本体”的概念。在很多计算机视觉任务中,点云重建通常是把多个view对齐;而在我们的场景中,更重要的是把所有观测统一到机器人本体的坐标系下,而不是简单地对齐不同视角,这样机器人就会知道在观测的空间中哪部分是自己的手以及这部分的“手”是如何跟环境互相交互的。
9. 现在3D模型上有什么进展推进了Pointworld这个工作
这个工作其实很大程度上是依赖了最近一些3D模型的发展。
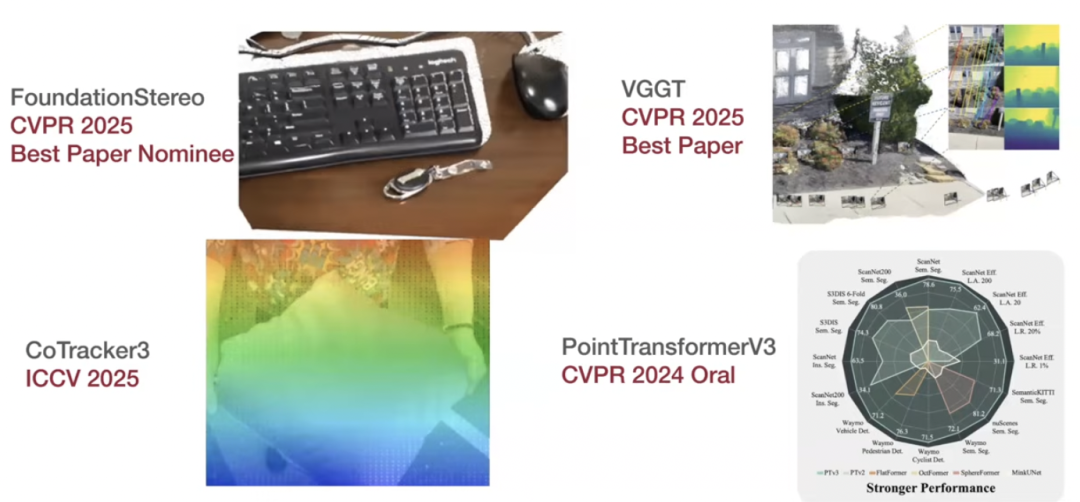
比如我们用了VGGT,它是一个做3D重建的模型,在计算机视觉里算是比较成熟、大家也比较熟悉的一个工作。
还有一个是FoundationStereo对话温伯文:FoundationStereo如何变革双目视觉,它是从双目图像去估计深度的模型,可以直接得到深度图。
另外还有Co-Tracker3,这是一个point tracking模型,它的作用是给定一段视频,可以去跟踪每一个pixel在时间上的运动轨迹。我们主要是用它来做supervision,也就是在data labeling阶段,用它来生成训练信号。
所以在数据标注这一块,主要是用到了这三个模型。
然后在模型训练阶段,我们还用了PointTransformer V3,这是一个基于transformer的点云模型,用来处理point cloud数据。
整体来说,这个工作其实是结合了很多3D视觉领域比较新的模型进展,某种程度上也是因为这些模型已经发展到一定阶段,我们才有可能把这些东西组合起来,去训练一个3D world model。
10. 关于训练数据
我们这个工作主要用了两个数据集,一个是DROID,一个是BEHAVIOR。
DROID是一个真实世界的操作数据集,是open-world的场景,大概有几百个小时的数据,主要是在真实环境里做一些相对比较简单的机器人操作任务。BEHAVIOR是一个仿真的数据集,规模更大一点,大概有1000多个小时。
在仿真里面,相对比较简单,因为所有3D的信息都是有ground truth的,可以直接拿来用。但真正的难点是在real-world的数据,也就是DROID上,我们需要自己去构建3D的labels。
具体做法是这样的。首先因为DROID上的数据很多是用双目摄像头采集的,我们用FoundationStereo去从stereo image里面预测深度信息。我们发现这个模型预测出来的深度信息质量是非常好的,甚至比一些双目相机本身预测的深度信息质量还要更好,这一点对我们来说非常关键。
有了深度信息之后,下一步是要知道每个相机相对于robot base的位姿。我们一开始用VGGT去做一个initial estimation,它可以给一个大概的位姿,但是误差还是有,大概在10到20厘米左右。
这个误差其实已经是当时比较好的结果了,但对我们来说还是不够精确。所以我们利用一个先验:我们知道场景里是有机器人的,而且机器人的mesh是已知的。基于这个,我们做了一个优化,对相机的位姿进行微调,这样可以把误差进一步降下来。
有了深度信息和相机位姿之后,下一步就是做point tracking。我们用Co-Tracker3去跟踪视频中每一个pixel的运动轨迹,也就是看每一个点在时间上的变化。
基本上就是这三步:先用FoundationStereo拿深度信息,然后用VGGT+优化拿更准确的相机位姿,最后用CoTracker做point tracking。通过这几步,就可以在real-world数据上构建出3D的point-level label。
在仿真里面的话,其实流程是类似的,但不需要这些模型,因为3D信息本身就是直接给出来的,所以可以直接用。
11. 单目+tof可以代替双目吗
在我们这个工作里,其实对不同深度获取方式的处理是没有区别的,因为我们最终需要的是点云这种统一的表征。如果是ToF这种深度相机,本身也可以直接得到点云,所以也是可以用的。
但我个人关于深度信息的获取有一个很大转变,在FoundationStereo对话温伯文:FoundationStereo如何变革双目视觉这类模型出来之后,我们发现学习式的depth estimation效果已经明显超过了传统硬件。这个模型的输入是双目的RGB,输出是depth。虽然它是一个预测模型,但实际效果比很多市面上的深度相机都要好。
比如传统的深度相机(很多是基于发射光线、测回波时间来估计深度),在一些场景下会有明显问题,比如反光物体、不锈钢表面、或者一些材质复杂、容易产生反射的物体。
但我们发现,FoundationStereo在这些场景下反而表现非常稳定,对反光物体、复杂材质都没有明显问题。这一点对我们来说是很重要的,因为它让real-world数据里的3D信息质量有了一个明显提升。
12. 为什么FoundationStereo的深度估计效果这么好?
我觉得之前其实不是没有相关工作,这个方向一直都有很多研究,但更多的问题在于没有被真正“做好”。从某种角度来说,这类模型如果放在很多年前,其实也是可以做出来的,只是大家没有把它打磨到现在这个程度。
它之所以能做得这么好,一个很重要的原因是:它解决的是一个更加well-defined的问题。具体来说,它是一个双目深度估计问题,而不是单目深度估计。深度估计这个领域本身有很多工作,但单目深度估计通常依赖大量先验,比如我们知道一个苹果大概多大,再结合它在图像中的位置、光影等信息去做一个预测,本质上是带有“猜测”的成分。
但双目就不一样了。双目设定中,有两个相机作为输入,并且这两个相机之间的距离是已知的,这一点和人类视觉是类似的。人有两只眼睛,而且两只眼睛之间的距离是固定的,我们一直在用这种方式观察世界。尤其是对于fine-grained manipulation来说,类似于像穿针引线这种任务,双目视觉至为关键,因为在距离比较近的时候,纯靠先验的精度是不够的。
在这种情况下,一旦双目之间的几何关系是已知的,深度估计就变成了一个feature matching的问题。只要能够在两个视角之间提取到好的feature并建立对应关系,就可以得到比较准确的深度估计。
这也意味着,即使模型从来没有见过某个具体物体,也不影响它做出正确的估计,因为它依赖的是几何关系,而不是语义先验。
在训练上,这类模型通常是在simulation中进行大规模训练,并结合充分的randomization,使模型学到一种比较通用的匹配能力。因此可以形成一个类似foundation model for depth estimation的模型,在各种场景下都有很好的效果。
13. PointWorld的模型架构
模型架构我们其实是尽量从简。核心就是选一个好的modality,让它可以同时unify state和action。在这个基础上,我们不太想自己去设计新的模型架构。
所以我们直接用了一个在point cloud领域比较SOTA的模型——Point Transformer V3。本质上它就是一个transformer结构,和其他模型在形式上没有特别大的区别。
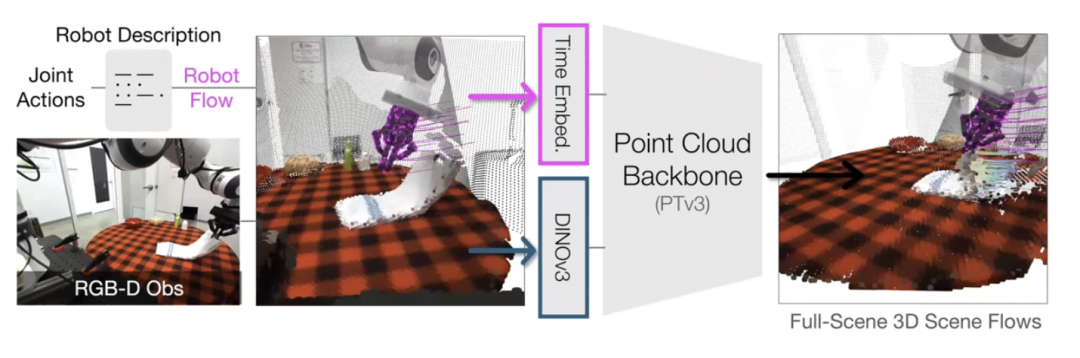
我们做的事情更多是把这个模型拿过来,然后去scale up。背后的philosophy是,我们不想在架构上做太多改动,而是想看:在一个尽量简单的setup下,如果数据规模上来了,模型的效果可以做到什么程度。
因为之前3D这块一直受限于数据,很难有大规模、高质量的数据去训练模型。但现在随着这些3D模型的发展,我们第一次有机会拿到比较大规模的3D数据。
所以我们更关心的是,在这种条件下,简单的模型+大规模数据,能带来什么样的效果。不过在实验过程中我们发现了一些针对3D世界模型训练的一些独有的挑战,但大多数属于训练细节的调整,对整体transformer架构并没有改动。
14. PointWorld的应用
世界模型是个在robotics领域很成熟的概念,也有很多已知的应用。在这个工作里,我们主要关注的还是3D world model本身,重点是在于:如何第一次把它做到general-purpose。
因为在之前的robotics工作里,大多数world model都是针对某一个具体环境单独训练的,而不是一个可以在不同场景泛化的模型。所以我们的重点还是放在3D world model本身的训练和scale up上。
在机器人应用层面,我们其实只选了一个最基础的应用场景。这个应用的设定是:在没有任何先验、也没有demonstration的情况下,给定一个新的任务,这个模型能不能直接工作。
这里的核心是利用world model的counterfactual prediction能力。也就是说,给定一个action,模型可以预测环境会发生什么变化;反过来,我们也可以问:如果我希望环境达到某种变化,能不能反推出需要执行什么action。
这个问题本质上就是一个planning问题。在传统机器人领域,这类问题通常是用人工设计的模型,或者用physics simulator来解决。
而我们这里做的,是用一个learned world model来替代这些传统方法。
我觉得从效果上来说,因为world model本身不是一个policy,它解决的问题和VLA或者policy是不一样的,所以评价角度也应该不一样。我们更关心的是它的counterfactual prediction能力,也就是它能不能正确地预测“如果做了某个动作,环境会发生什么变化”。
现在很多人会把VLA和world model放在一起比较,但我觉得这个对比其实不太恰当,因为它们本质上是互补关系,而不是同一类东西。world model更侧重于对环境的建模,本身并不直接做decision making;而VLA或者policy,是用来做决策的。
有了world model之后,它可以在很多层面上帮助决策。比如在没有当前任务的决策数据(expert demonstrations)的情况下,可以在world model里通过RL或者planning来作为policy;或者已经有policy的情况下,可以用world model去做policy improvement;也可以把world model当成一个替代真实环境的工具,在里面评估policy,而不用每次都在真实机器人上跑。
这些应用本质上都是依赖world model的counterfactual能力,其中最直接的应用就是看从随机初始化的action开始,模型能不能逐步调整action,最终完成任务,这通常也叫planning。
另外一个角度是,如果最开始不是随机初始化的action,而是已有一个policy,那我们可以让模型来逐步调整policy,这也叫policy improvement;还有一个角度是,在world model中评估出来的policy效果,是否和真实环境中的表现一致。这些其实都是在从不同角度测试这个world model的counterfactual能力。
第二部分 关于3D世界模型
15. 为什么要3D世界模型?
这个问题其实也是我在反复思考的点,我觉得可以分成两个部分来看,一方面是状态表征(state representation),一方面是动作表征(action representation)。
关于state representation,首先我们先要区分一下observation space以及state space。observation常常指的是机器人的相机以及其他传感器,可以有多个相机,但通常都是2D的,有时也会带depth信息或者stereo。而state space是无法观测到的,因此我们需要通过observation以及过往的交互去得到一个表征(state representation)。比如我刚刚关上一个抽屉,我之前看过里面有什么东西,那么模型在之后应该还能“记住”这些内容。但无论是2D还是3D的当前观测,其实都看不到抽屉里面的状态。所以真正的state,不只是当前的2D或3D观测,而是需要包含这些隐含信息。
因此我觉得最好的state应该是一个latent state,而不是人为去规定是2D还是3D。也就是说,让模型自己去学习最合适的表征,而不是hard code成某一种形式。
石麻:关于世界模型里的观测(observation)和状态(state),我一直很困惑,文龙上面一段解释非常清晰。我不知道读者是否和我一样,对这两个概念有同样的困惑,但我还是想表达一下让我理解这两个概念的一个角度。前段时间我自己看了一些量子相关的书籍,我想用薛定谔的猫来再进一步解释一下观测和状态的区别,一个猫在一个有放射物质的密闭盒子里,在我们观测之前,猫的状态可能是活着也可能是挂掉;在我们观测的时候,它的状态坍缩为一种结果。猫的状态和我们对猫的观测是两件事情,在我们观测猫之前我们真的可以预测到猫在哪一种确定的状态吗?
而action representation是我们对3D最感兴趣的点,因为如果是从robotics的“终局”角度出发,其实我目前也没有想到一个比3D更好的表达方式。在这样一个“终局”里,我们也许希望可以控制任意一台没见过的机器人去完成任意任务的能力(类似于人可以轻松遥操各种机器人),这个机器人可能有未知的关节和形状,那我们就需要去从观测空间建模“不同机器人的动作对世界的影响”。
在这一点上,我不觉得2D是足够的,因为我们总是需要去判断:1)观测的图片中哪部分是自己/遥操机器人的手,2)机器人在被遮挡的地方大概会是什么几何形状的。这总是会需要一个(显式或隐式)3D手眼标定的过程,也对应着(显式或隐式)的3D表达方式。
比如我去遥操作一个机器人搬箱子,我先会去判断眼前哪部分是我在遥操的机器人的手,并且在我的双目观测空间中针对我的动作和被操控的机器人进行“建模”。当机器手伸到箱子后面的时候,我也许在双目视觉中看不到机器手的具体接触情况,但我知道手的大概长度,也知道箱子的大小。即使视觉上看不到,我也能推断出它大概在什么位置、如何接触,所以这个过程本质上是发生在3D空间中的,也意味着我们需要对3D进行(显式或者隐式)的建模。
但从数据角度,我是同意2D在数据规模上有非常大的优势,如果要scale up,确实需要更多数据来源,而这方面2D是明显占优的。
3D数据目前基本局限在机器人数据里,因为只有机器人采集时才会用到depth或者stereo camera以及对应的手眼协调的数据,而互联网视频大多是2D,也没有对应的action数据。所以这里其实存在一个潜在的冲突:一边是3D在表达action上的优势,另一边是2D在数据规模上的优势。
我觉得一个可能的方向是,用2D数据去训练一个backbone,然后再用3D的action数据去做fine-tune或者对齐。
对我来说,这个工作的出发点,是先找到一个让我比较满意的action的表征,而后续的工作,其实是在考虑如何把这个表示和更大规模的数据结合起来。
16. 怎么看现在egocentric数据
其实很多egocentric的人类数据,本质上也是一种“2D+3D”的模式,而不是纯2D。虽然采集方式上通常是一个camera(比如戴在头上的相机),输入是2D的RGB stream,但实际上还会额外采集手部的pose信息。而这个hand pose,一般都是3D的,而不是2D的。
所以在这种设置下,action也还是3D的,而我们这个工作,是用一种更expressive的方式去表示action,也就是用手表面的点流,这样更接近于where contact happens,也可以表示其他的任意embodiment。但从本质上讲,这两种方式是比较接近的,都是在表达3D的action。
而且这种情况不只是egocentric数据,像UMI这种手持device的数据也是类似的。它们虽然输入是2D图像,但action也是通过SLAM等方法恢复出来的3D表达。
我个人还是觉得这个方向是很promising的。比如如果能结合这类数据去训练3D world model,其实是一个很自然的延伸。
17. 我们有机会获得和人所在的3D世界类似的3D世界模型吗?
我觉得是很可能的,因为这是一个目前最scalable的objective,所有的现实世界数据都可以用来训练它,包括互联网视频、human data、robot data,甚至是遍布世界的摄像头。
在这种目标下,3D是必然的,但是是否使用显式或隐式的3D表征可能并不重要,重要的反而是这个世界模型需要能在各种交互下都能有很强的counterfactual prediction的能力,并且能够把这种能力用作决策(decision-making)。
现在很多人讨论world model,其实关注点还是在video generation或者prediction上,也就是生成的pixels效果好不好。但我觉得,如果有足够多机器人数据,模型应该更偏向于去建模交互(interaction)本身,而不是只是生成一个看起来好的video。
因此,如果从更长期、甚至“终局”的角度来看,我觉得最理想的情况是:当我们拥有足够多的robot data之后,可以训练出一种更加“robot native”的world model。
目前的问题在于,我们没有那么多机器人数据,所以只能大量依赖internet video。这些数据一方面是2D的,另一方面它本身有很强的bias。比如人什么时候会拿出手机拍视频?通常是有“interesting”的事情发生的时候才会拍,这些视频的视角、分布,和机器人实际看到的世界是很不一样的。但机器人面对的很多interaction,其实是很“无聊”的、重复的,这些在互联网数据中是比较少的,只有机器人的数据或者是egocentric视角下的操作才会被捕捉到的更多。
所以在短期或中期,一个比较现实的路径是:利用可以scale的数据源,比如internet video,用2D去训练一个backbone;然后在相对更少但更贴近机器人的数据(包括3D或带action的数据)上去做fine-tune,从而引入controllability。
但从更长期来看,如果真的有足够多的robot data,我觉得是值得“推倒重来”,重新训练一个完全以robot为中心、专注interaction的world model。
18. 我们是不是真的需要世界模型
我觉得一个很有意思的问题是:我们是不是真的需要world model。我觉得这个点很重要也很有意思,并且是我比较关心的。
当下在机器人领域大家对world model感兴趣,很多时候其实是把它当作一个更好的backbone在用,或者是把从生成的视频里提取action,但是往往还是需要用task-specific demonstration做finetuning,因此目前在范式上还没有很大的改变。
但我觉得world model真正重要的一点,是它的counterfactual prediction能力。我觉得这一点是用来做planning、做novel behavior、novel strategy的关键能力。
举一个例子,我最近看到一个Physical Intelligence的demo,是用夹爪机器人把袜子翻过来。比如我们平时叠袜子的时候,袜子可能是反的,我们会把它翻出来。但人类是用多指手,可以用大拇指和食指抓住边缘,然后用剩下的手指把它翻出来。
但夹爪机器人是做不到这个的,因为它没有多指的自由度。于是,一个适合夹爪机器人的策略是:先把袜子套在一个夹爪上,慢慢把袜子往上推,然后被套着的夹爪可以从里面把它夹住翻出来。
这个过程其实很难,因为涉及deformable object,而且操作上也非常fine-grained和contact-rich。他们最后是训练了一个autonomous policy,效果很好,在这个层面是非常impressive的。
但对我来说,更有意思的一点是:这个策略其实是人在遥操的时候想出来的,是数据采集的人先想出了这个方法,然后把这个策略通过数据教给机器人。
因为这些是过去机器人做不到的任务,所以这个范式也许已经会有巨大的经济价值,但从“终局”的角度来看,我更关心的问题是:在数据量上去后,机器人能不能在test time自己想出这样的策略?
也就是说,给一个新的任务和一个新的情况,在没有人类demonstration的情况下,机器人能不能自己去构造一个解决方案?比如说我用的是不同粗细的夹爪,或者是不同数量手指的灵巧手,针对不同任务的不同constraints,我该怎么做?
更深来看,这也许是一个更为长期的scientific pursuit,因为它的目标不局限于distilling humans,而是实现human-level physical intelligence,即使distilling humans很可能是重要的手段之一。
在这种问题设定下,我的猜想是world model就变得非常重要。因为它提供了一种“想象”的能力,并且可以用这种能力用来决策,类似于LLM的reasoning。
就像人类一样,我们可能从来没有做过某个操作,但我们可以在脑中去模拟不同的可能性,并且通过交互去不断地完善更好的想法。比如我如果是一个机器人,有一个夹爪而不是灵巧手,我该怎么做才能达到某个目标?这种其实就是counterfactual prediction。
它不是一个我们日常会直接执行的行为,而是通过推演不同可能性得到的。
所以在我看来,在机器人领域里,world model的重要性也许不是说它只是一个更好的backbone,或者只是提供更好的prior、更多数据,而是它提供了一种更长期的能力:去支持这种counterfactual的推理、novel strategy的生成、以及把这些推理反哺/内化到predictive policy的能力。
19. 我们是不是需要先有足够多的机器人数据才会有这样的世界模型?
可以确定的是有机器人的数据我们才能会有更好的世界模型,但是我最近的一个想法是,我不再觉得这样的世界模型最开始一定需要海量的机器人数据。这也是在做了PointWorld这个工作之后的一些感触。
当我们把action看成是observation space的一部分时,其实意味着,我们可以在很多非机器人数据里学习“世界是如何运作的”,这里既包括了世界的物理规律,也包括了人、物体、动物以及各种agent/entity的行为。
比如在互联网视频或者遍布世界的摄像头中,我们可以看到各种agent在和这个物理世界交互。这个action不一定是“我的action”,比如我看到一只猫在玩一个玩具,我并没有控制这只猫,也没有它的本体信息,但我可以学习到这个玩具的物理性质以及属于猫的行为特质。
当然,这个更加类似于pre-training,只能提供一个行为和物理的先验(prior)。就如LLM的pre-training一样,它可以从各种数据中学习,但后续还需要post-training才能用作agentic system。这里针对机器人的post-training很可能是通过counterfactual reasoning去完成的,但同时也需要切实跟真实环境交互,就像LLM不能纯靠reasoning来提升自己一样,同时也需要真实环境的reward。
这里有一个我很喜欢的philosophical观点,是Stanford的Dan Yamins教授提到的:
“No one observer is the only true agent in the environment.”
也就是说,没有任何一个观测主体是唯一的agent,环境中存在很多不同的agent。
比如猫是一个agent,其他人也都是agent,我们都可以通过观察这些agent的行为,去学习世界的规律和行为的规律。
Reference:
黄文龙主页:https://wenlonghuang.com/
PointWorld:https://point-world.github.io/
论文讲解:https://www.youtube.com/watch?v=0vfgm8LshmY
FoundationStereo:https://nvlabs.github.io/FoundationStereo/
cotracker3:https://cotracker3.github.io/