石麻笔记在2024年用了10期和机器人数据相关的论文访谈来科普各类具身数据 EP10 Robot Data第一季访谈总结,在2025年又用了10期和人类数据相关的论文访谈来科普机器人训练会用到的人类数据总结篇:Human Data—The “Key” to Robot Data,我一直认为数据是观察具身智能发展的一个哨点,对数据理解的深度,决定了一个具身模型公司的上限。
但遗憾的是,国内大多数具身模型公司,真正能够对数据有原生思考的并不多。所以,我们非常需要一个比模型公司更懂数据的数据公司,因为它可以极大地提升行业的整体水平。
ModalityNet(https://modalitynet.com)是我认为可以加速整个具身智能行业发展,推动整个行业向前进步的一个数据工作;它是一个致力于构建全球最大的、以人为中心的具身智能全模态数据集。
我们带着一系列关于数据的问题,邀请了创造出ModalityNet的诺亦腾机器人的创始人戴若犁博士进行了一期线下访谈,我和到场的100多个朋友非常有幸的听到了戴博对ModalityNet的现场解读。而以下文章,是我认为应该让全行业看到的关于具身数据的“真”思考。以下关于我十分推荐的数据集—ModalityNet的访谈记录,适合一小时安静阅读。
查看原文目录
以下为本文目录
👇
1. 关于ModalityNet
MobilityNet的数据规模
2. MOV——高精度人体大空间交互数据集
MOV数据的采集方式
MOV的数据模态(和AMASS、LaFAN对比)
MOV的数据规模(和AMASS、LaFAN对比)
3.OM——高精度人类手部精细操作数据集
OM数据的采集方式
OM的数据规模
OM这么高精度的手部数据集可以做什么?
4. MOV和OM这两类数据的关系
5. ITW——非可控环境下人类主观视角的操作数据集
ITW数据采集方式
6. 现在具身数据的需求是什么量级?
7. 数据公司怎么应对数据范式的迭代
8. 真正重要的数据是重建出人类感知世界的Input?
9. 关于World Compiler
10. 如何提高数据的可学习性?
11. 如何验证数据可学习性的提高?
1. 关于ModalityNet
我们在选择哪些数据应该由我们来采集,或者说应该由像我们这样相对纯粹、中立的第三方数据公司来提供的时候,其实我最看重一件事情就是数据的跨本体可迁移性。
跨本体可迁移性决定了这个数据能不能在不同的机器人公司,以及不同机器人公司的不同机器人型号之间复用。从成本的角度来说,这是一件非常划算的事情。如果有某一类数据,能够作为整个行业机器人模型训练的素材,并且可以跨本体复用,那么这一类数据就是一个行业共享的数据基础设施,它的价值不在于服务某一家机器人公司,而在于能够被整个行业反复复用。
大家可以想一想,如果有一份数据,30家机器人公司都可以使用。假设它的生产成本是10块钱,作为数据生产方,我并不需要靠一家客户收回全部成本,而是可以通过服务20家、30家公司来覆盖数据采集、标注、质量控制、持续迭代等成本,并支撑后续研发投入。
这意味着,随着越来越多企业使用同一类数据,数据的边际成本不断下降,而整个行业都能以更低的成本获得高质量训练数据。这正是跨本体数据最大的价值——它能够通过规模化复用,实现全行业的数据成本摊薄。
所以,我认为一个第三方数据供应商最应该做的,就是提供跨本体可用的数据;那些不能跨本体使用的数据,本来就应该由甲方自己去做。比如,使用某种特定本体的甲方,应该负责采集那些只有自家机器人才能使用的数据。比如真机遥操作(Teleoperation)数据,比如绑定了特定夹爪能力的UMI数据,这些数据天然只能服务于某一种机器人本体(或者夹爪),因此应该由机器人本体(或者夹爪)厂商自己完成,而不是由第三方来做。
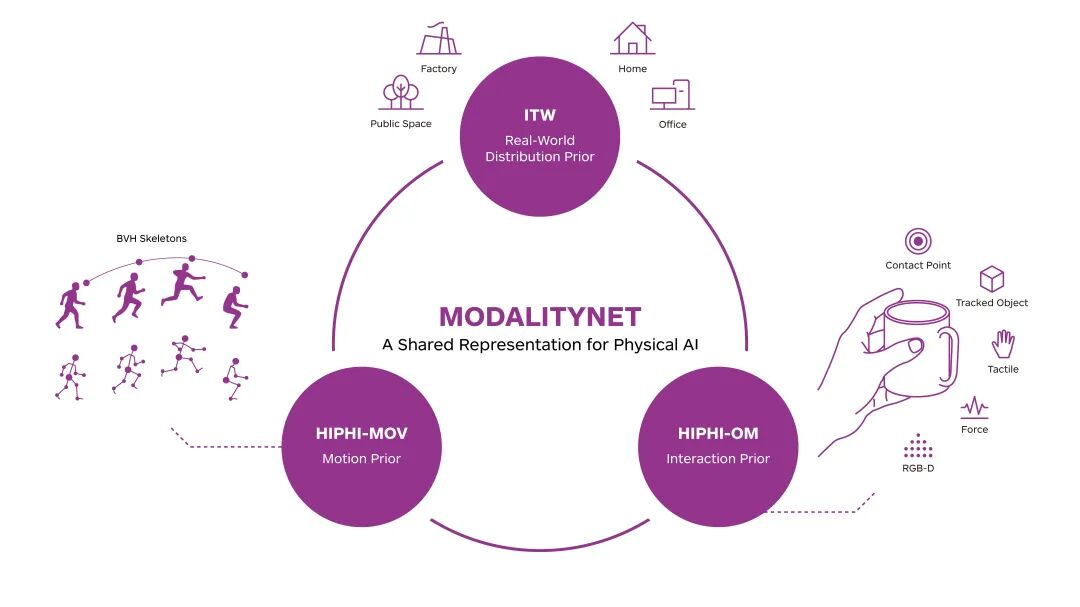
ModalityNet是我们刚刚上线的数据集(它的网址就是modalitynet.com,直接输入这个域名就可以访问)。目前这个网站上有三类数据,这三类数据都是可以跨本体使用的数据。这三类数据集分别是:MOV——多模态大空间交互数据集、OM——多模态灵巧操作数据集、ITW——多模态野采主观视觉数据集。ModalityNet就是我们发布的一个包含上述三种类型数据的公开数据集。
MobilityNet的数据规模
目前公开的数据规模,大约始终保持在我实际持有数据量的1/20左右。也就是说,当我拥有20万小时的数据时,公开出来的大约有1万小时。未来如果没有特别大的变化,这个比例也会一直保持。剩下的19/20,是我的商业模式,是我要出售的数据;而公开的1/20,我会一直保持开源。
现在ModalityNet 上大概有几千小时的数据,其中能够直接在网页上预览的约有几千条。另外还有几千小时的数据属于Upon Request,只要和我们建立合作,或者简单走一下申请流程,就可以获取。
其实现在我们和学术界合作非常多,比如港科大、港大、清华、南科大、中科大、港科广、港中深,还有UC Berkeley、Stanford、UC San Diego、南加州大学等很多高校。
我们和很多优秀的Researcher都有合作。大家线下沟通之后,在数据层面我们都会提供支持。比如,一些规模较大的研究组会有十几位博士生与我们开展研究合作,并直接向我们申请大量数据。有时候,我们甚至还会提供一些很稀缺的数据定制化支持。
我们基于对算法需求的理解建立了这个数据集,并将三类数据分别对应到:全身运控或动作基模需求(MOV)、桌面级精细灵巧操作模型需求(OM),以及视觉泛化与预训练需求(ITW)。这个数据集的诞生既是主动的,也是被动的:主动的一面来自我们对模型训练的理解,被动的一面来自客户的“倒逼”。
2. MOV——多模态大空间交互数据集
第一类数据面向的是Whole Body Control,也就是全身运控,以及Loco-Manipulation。这类数据本质上是以人的动作姿态、物体轨迹以及第三人称视觉作为主干。如果涉及操作任务,还会包含手部位姿。我们把这一类数据叫做MOV。MOV是Motion、Object和Vision三个词的缩写。
因此,这本身就是一个多模态数据集,里面包括Human Pose、Object Trajectory、Object Mesh,也就是物体的几何信息和轨迹,还包括Vision,包括第三人称视觉、第一人称视觉等各种视觉信息。这一类数据,在训练很多机器人模型的时候,其实都是可以跨本体使用的。
比如,NVIDIA最近发布的两个模型,SONIC专访罗正宜:关于SONIC全身控制框架的访谈和Kimodo这两个模型里面都大量使用了这类数据。包括GAEHuman Data EP06—Mocap+Video:GAE以及Figure AI的Helix全身运控系列的工作,也同样大量使用了MOV类型的数据。
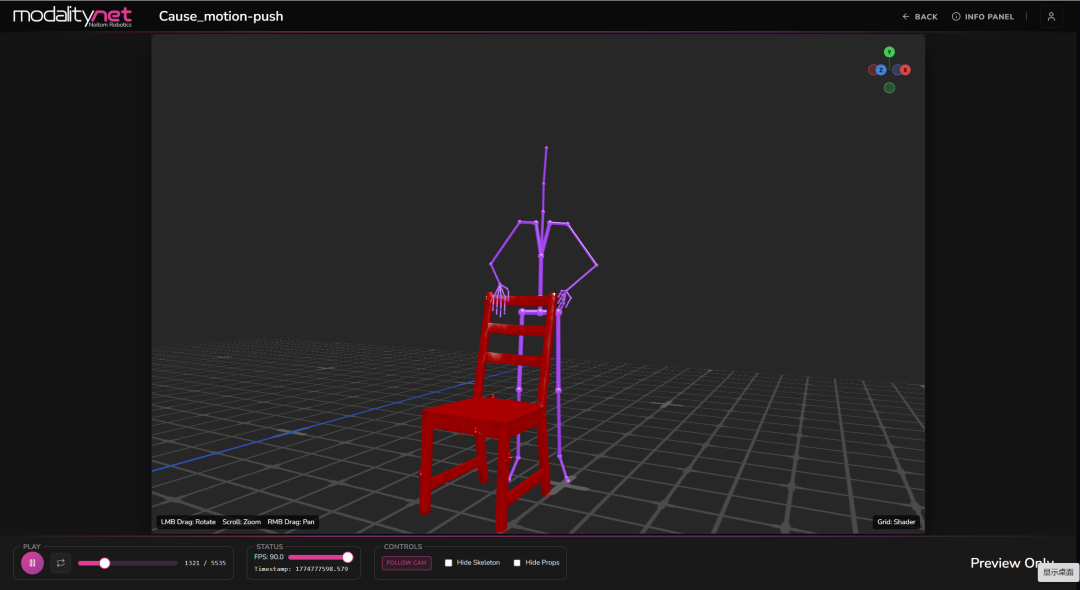
HiPHI-MOV数据示例
MOV数据的采集方式
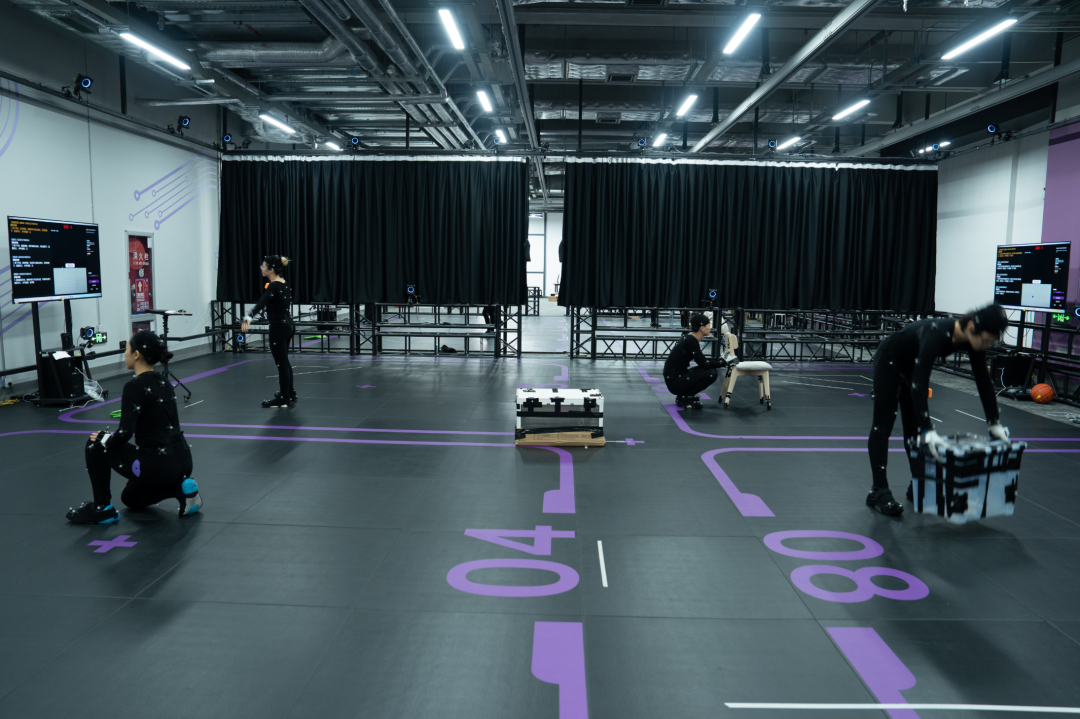
MOV的数据采集空间非常大。我们在深圳龙华有一个接近一万平方米的数据采集基地,里面有很多MOV这样的采集空间。
人在里面可以自由跑动,可以多人协同完成任务。比如四个人一起抬一张桌子,我想训练四个机器人协同,或者两个机器人和两个人协同,甚至一个人带着三个机器人,把一张很大的圆桌从这里搬到另外一个房间,中间还要经过旋转门,还要把桌子竖起来。在这样的过程中,需要大量策略,也需要复杂的协同。
这种数据应该怎么采?首先,它一定需要一个很大的空间;其次,需要多人能够同时进行Interaction;对于桌子这样的Object,需要持续Tracking,需要Mesh;对于人类精度要求相对较低的操作行为,包括粗颗粒度的Hand Pose,也都需要完整捕捉,同时还要有视觉信息进行补充。所以MOV本质上对应的是一个大空间的数据采集。
MOV数据采集方式示例
MOV的数据模态(和AMASS、LaFAN对比)
第一类:它本质上就是以动作数据为主干,面向Whole Body Control的全身运控数据。
不过我要强调一点,像LaFAN、AMASS,包括Bones Studio最近帮NVIDIA GEAR Lab做的数据集,它们本质上都是单模态数据集,里面只有身体位姿。而我们在采集身体位姿的时候,同时把环境视觉、物体轨迹等信息全部都采集下来了。
MOV数据使用示例
MOV的数据规模(和AMASS、LaFAN对比)
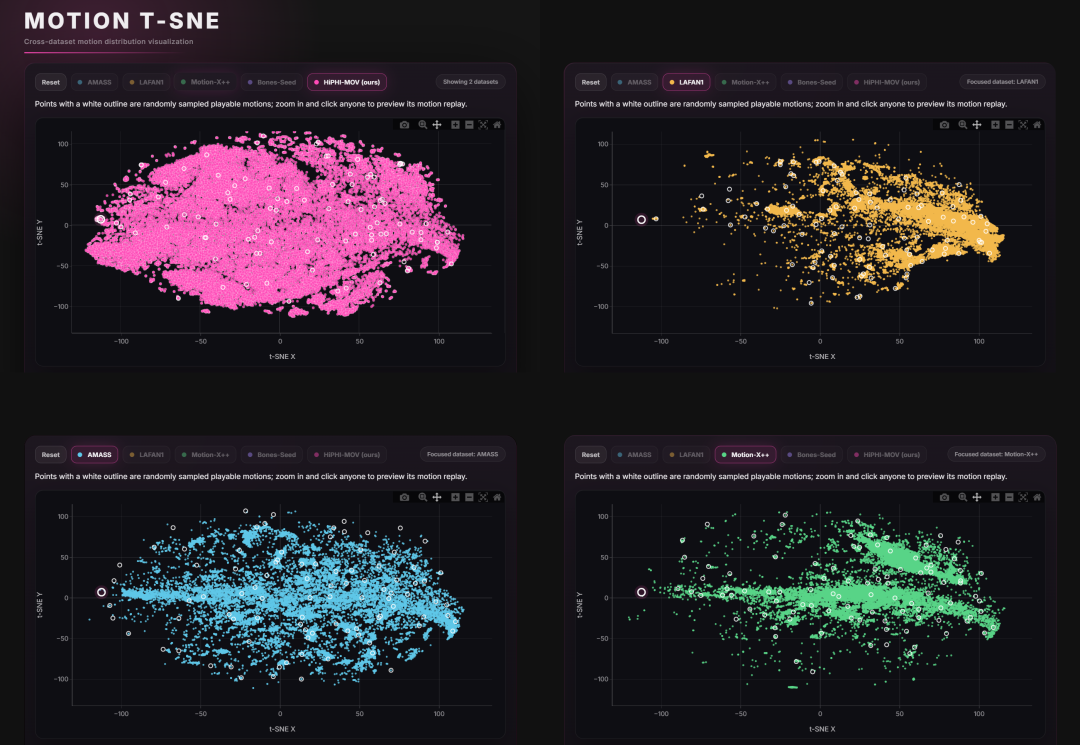
另外一个很大的区别,就是体量。LaFAN我印象里大概只有个位数小时,或者十几个小时。AMASS是德国马普所Michael Black团队做的,非常优秀的数据集。我读书的时候也一直在用。整个数据集大概七十多个小时,其中真正可用的大概四十多个小时。
而我们现在这一类数据已经有八千多个小时,相当于多了两个零,规模已经扩大了一百倍左右。这还是我目前已经拥有的数据体量。
所以对于现在做Whole Body、Loco-Manipulation、Whole Body VLA这些方向来说,这个数据集其实已经可以直接使用了。
MOV数据规模示例
(粉色是MOV,黄色是LaFan,蓝色是AMASS,绿色是MotionX++)
3.OM——多模态灵巧操作数据集
ModalityNet里面第二类数据,是面向精细操作的,尤其是高精度手部动作捕捉,我们叫OM(Omni Manipulation,广谱灵巧操作)。可以把它理解成MOV的一个极度缩小版本。
与MOV的大空间采集不同,OM将原本100平方米、200平方米甚至300平方米的 Tracking Space 缩小到桌面尺度,但对采集精度提出了极高要求。
它采集Finger Pose,要求达到亚毫米级别;同时仍然采集Whole Body Pose;还有第一人称RGB和RGB-D视觉;第三人称、多角度RGB和RGB-D视觉;甚至还有Spatial Audio,也就是空间音频。
为什么还需要音频?很多时候,一个操作任务并不完全依赖视觉。比如我面对大家讲话,把一个东西放到桌子上。这个桌子的存在,对于我来说只是视觉先验。当我把东西放到桌子上的时候,真正确认任务完成的,其实是声音。所以声音也是一种非常重要的信息。
另外还有触觉。比如刚才我做了一个动作,又把东西拿回来,我的眼睛其实没有参与,而是依赖先验知识、力觉、触觉以及本体感觉完成了整个动作。所以在OM这类数据集里面,我们同样会采集这些信息。
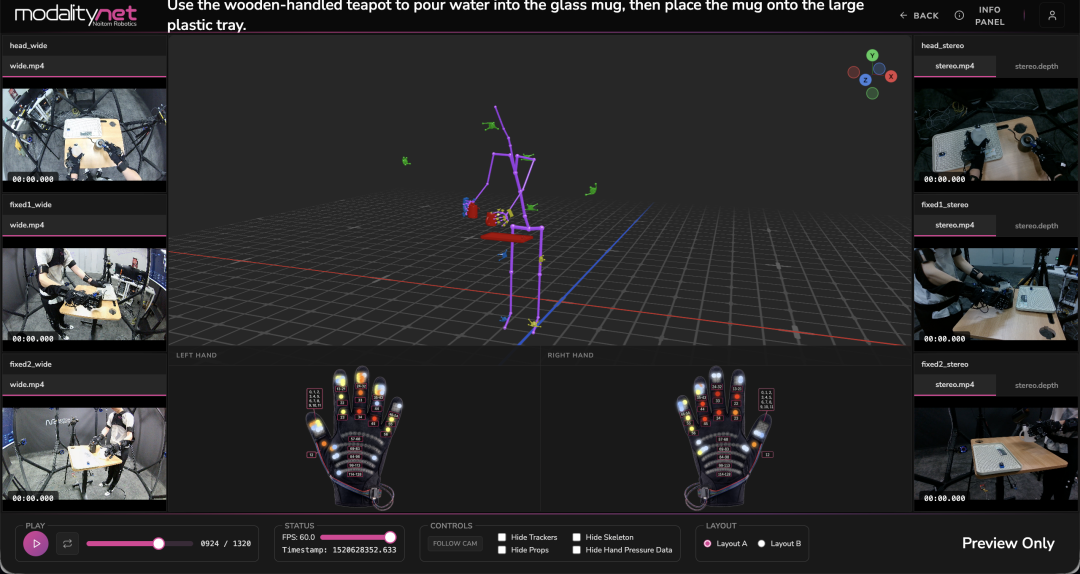
HiPHI-OM数据示例
OM数据的采集方式
在OM的数采空间里,大家会看到许多小隔间,每个隔间里都密集布置了各种传感器和 Camera。它们的目的,就是以超高精度采集人的Manipulation过程,包括In-hand Manipulation、触觉信息、运控信息等等,将这些信息完整采集下来。这就是 ModalityNet 的第二类数据。
首先,我们采用光学与惯性融合的动作捕捉,同时还使用了EMF,也就是磁传感等数据源。不过,精细化手部操作最重要的是触觉,我们把触觉模态也加入进来了。
另外,因为所有操作都围绕一个固定工作空间进行,所以我们增加了第一人称视觉、第一人称深度视觉,以及第三人称视觉、多视角第三人称视觉、多视角深度视觉。
还有一些目前还不知道未来有没有用的模态,例如温度、音频,我全部都采集了,因为我担心以后这些信息会变得有价值。
这类数据精度非常高,而且模态比第一类还要更完整。
第一类Whole Body Control的数据,比如我推着一把椅子慢慢往前走,当我已经有了手部位姿和椅子的Trajectory之后,其实比较容易推断手和椅子之间的关系。
但是如果我要完成一个精细的In-hand Manipulation,仅仅依靠手部位姿和瓶子的状态,其实很难准确估计两者之间非常细微的接触关系。这种接触关系,只有把触觉信息一起采集进来,才能真正描述精细操作过程中人与物体之间的接触状态。
OM的数据规模
这类数据集要小一些,因为它特别难采,也特别贵。目前我们自己手里大概有几千小时的数据。按照前面说的比例,开源部分大概就是除以20,也就是几百小时,大概就是这个体量。
OM这么高精度的手部数据集可以做什么?
第一个作用,它可以训练一个操作基模(Manipulation Foundation Model),可以帮助模型全面理解人类是如何完成Manipulation的,本质上就是一个操作层面的基模,对标身体级别的动作基模Kimodo。
这件事情也是我个人现在非常感兴趣的方向。我目前正在和几位Top Researcher合作做这个方向。
我预计,今年下半年到明年年初,他们可能都会陆续发表相关工作。这些工作会是类似于Manipulation Foundation Model的研究,也就是面向Tabletop Manipulation层面的操作基模。这是OM数据的第一个作用。
第二个作用,是把这套数据对齐到机器人本体上。因为这些数据本来是从人身上采集的,包括人体位姿、手部位姿、触觉以及物体轨迹。如果我把它完整地对齐到某一个机器人本体,比如Unitree的本体配Sharpa Wave灵巧手,我们把这个过程叫做Embodiment Alignment,也就是本体对齐。
这个过程其实非常复杂。里面涉及前向动力学、逆向动力学,需要做Mapping、Retargeting,需要使用强化学习,还需要在仿真环境里面完成大量训练,最后还要完成Sim-to-Real。当这一整套流程全部完成以后,这份数据本质上就已经非常接近遥操作数据了。因为它已经和机器人本体完全对齐。
但是,它又比遥操作更强。很多动作,其实遥操作根本做不出来。比如玩魔方。再比如一些高度依赖力反馈和触觉反馈的精细操作,遥操作很难完成。还有一些精细的抛接动作,遥操作同样做不了。这些动作,人是可以自然完成的。
因此,我们可以先采集Human Data,再把这些动作完整地对齐到机器人本体上。完成对齐之后,它不仅和机器人本体完全一致,甚至还能在Synthetic Space里面直接获得对应的运控信息,进一步生成电机层面的控制数据。
所以,OM数据的第二个作用,就是完成机器人与人的本体对齐之后,作为遥操作数据的替代,而且能够覆盖那些遥操作本身做不了的精细操作任务。
OM数据使用示例
4. MOV和OM这两类数据的关系
(MOV是高精度人体动捕之于人形机器人;OM是高精度手部动捕之于灵巧手吗?)
这样理解对也不对。我认为这两个数据集本质上其实是同一个东西。第一个数据集MOV,是把人的大空间交互行为完整数字化;第二个数据集OM,则是把人的精细操作行为完整数字化。
所以,它们在设备选型、模态构成,甚至整个数据采集软件上,其实都是同一套体系。区别只是一个工作空间是20米×20米,一个是3米×3米。但是,后者的建设成本其实已经与前者非常接近。
动作捕捉只是其中一个模态,我必须强调这一点。Motion或者Pose,并不是机器人数据里最重要的模态,我认为最重要的仍然是视觉。如果让我排序,我会把视觉排第一,触觉排第二,Pose排第三。这里的Pose包括Body Pose和Hand Pose。当然,还有Object Trajectory、Terrain等很多其他模态,机器人其实都需要。
但如果让我只能保留一个模态,我一定会保留视觉;如果只能保留两个,我会保留视觉和触觉;第三个,我才会选择Whole Body Pose;第四个,才会选择Hand Pose。
我是有充分理由这样排序的。因为很多Hand Pose的信息,其实可以通过视觉估计出来,甚至有一部分触觉信息,也能够从视觉中间接推断。但是反过来,视觉一旦没有,就是彻底没有了;触觉一旦没有,当视觉被遮挡的时候,手和身体位姿信息也没有任何办法可以补回来。
所以,你刚才那个理解既对,也不完全对。对的地方在于,我们确实是沿着Human Pose和Hand Pose这条自己最熟悉的技术路线切入的。但如果让我客观评价机器人真正需要哪些模态,我甚至并不认为Pose是最重要的那个模态。
5. ITW——多模态野采主观视觉数据集
ModalityNet里面第三部分的数据,是以Ego Vision为主的野采数据。我们叫ITW,也就是In The Wild,指的是野外采集。这里所谓的In The Wild,真正的含义是非可控环境。Ego Vision指的是人类主观视觉。比如我戴一个摄像头,或者把手机固定在头上,这就是获取人类主观视觉。第三类数据,就是戴着头部设备,在这些真实环境里面完成采集的数据。
为什么强调主观视觉?我们在屋檐下、摄影棚或者实验室里面采数据,布置大量Outside-in Sensor,比如光学动作捕捉摄像头、UWB传感器等等,这些属于In The Factory或者In The Studio的数据,它们都是在可控环境下采集的。
真正的In The Wild,是在非可控的,真实的环境里面获取数据。比如真实的养老院、真实的物流仓库、真实的工厂柔性制造产线。以主观视觉(Ego-vision)为主干模态,我们也会努力在里面加入一些位姿与触觉信息。
在最完美的情况下,我们希望在野采环境(in the wild),尽可能还原人类感知外界时涉及的所有模态,同时拥有触觉、位姿、手部信息、主观视觉,还希望有Ground Truth级别的深度(最好肩膀上再挂一个LiDAR),最后你会发现,我们在数采实验员身上挂满了各种设备,像一棵圣诞树。
这里的观点和我们之前采访的Danfei老师提到的人类数据观点非常类似,关于Danfei老师的采访可以参考专访Danfei Xu:人类数据是伪装成另一种形式的机器人数据
但这样的方案,实际上没有办法真正做到In The Wild,也没有办法做到10万小时、100万小时这样的采集规模。而今年整个行业,对于In The Wild数据的需求已经达到10万到100万小时。因此,在In The Wild的数据采集里面,我们必须做取舍,牺牲一部分模态。
ITW数据采集方式
ITW数据采集方式
(第三类ITW数据,它和前面两类数据有什么区别?另外,它和现在市面上的Ego Vision Data这些数据有什么区别?)
ITW 数据使用的是我们自行设计的一套设备。这套设备搭载了多枚Camera。其中有两个Fish-eye Camera、一个RGB Camera,还有一个可以配置成高精度RGB或RGB-D的Camera。另外还有四个灰度相机,这四个灰度相机主要用于VSLAM、Head Tracking和Hand Tracking,也就是头部追踪和手部追踪。另外这个设备的开放性非常好,随时可以拥抱第三方其他模态采集设备的接入。
因此,我们理解的Ego Vision设备,并不仅仅是在头上戴一个GoPro。本质上,如果一个设备已经戴到了头上,那么它就应该尽可能完整地覆盖所有希望采集的模态或者说信息。
这个设备本身具备存储、计算和数据传输能力,续航时间也很长,一次充电基本可以连续采集一天。另外,它的FOV(Field of View,视场角)几乎完整模拟了人眼的视野。
大家可以估计一下,人眼的FOV有多大?如果眼球固定不动,人眼的视野大概只有110到120度,所以现在大部分VR头显的FOV都设计在105度左右,也有做到120度的,但120度边缘畸变会比较严重,因此主流还是110度左右。但是,我们Fish-eye Camera的FOV是210度。
为什么比人眼还大?因为人眼本身是可以转动的。如果眼球不动,当我正视前方的时候,手移动到一定位置以后,我就已经看不到了。但是因为眼球能够转动,人实际上可以看到耳朵后面的区域,所以真正的人眼可感知视野实际上超过180度,大约可以达到220度。
机器人没有眼球,这个设备也没有眼球,所以我们只能通过210度的大视场角去模拟人眼在眼球转动情况下的整体视野。
另外,周围配置的灰度相机全部采用全局快门,相比普通Rolling Shutter,其时间对齐更加准确,单帧图像上也较少有撕裂和变形,而且灰度波段受自然光干扰更小,因此特别适合完成Hand Tracking和Head Tracking。这就是一个典型的Ego Vision设备。
是不是戴上这样一个Ego Vision设备,数据采集就结束了?答案是Yes and No。
在绝大多数需要大规模采集的场景里,比如要做到10万小时以上的数据规模,或者采用众包模式的时候,这样一台设备基本就是唯一能够要求参与者佩戴的设备。因为我也不太可能要求做众包的人,再额外穿戴动作捕捉设备、触觉手套或者其他复杂设备。
但是,在很多可控环境下,比如我们自己的Fleet,也就是自己的数据采集团队,他们就可以佩戴更多设备,包括动作捕捉设备、触觉手套等,把更多模态一起采集下来。对应到市场需求,现在一些非常领先的机器人团队,他们真正需要的已经不是单纯的Ego Vision,而是这样的Ego Vision Plus。
早些时候,只要头顶一个手机或者GoPro,就可以采回来一些初级的数据,就已经能够满足很多需求。但是现在,这样的数据已经很难完全满足模型训练需求了。这类数据同质化非常严重,即使有人需要,价格也已经变得很低。
现在印度、加拿大法语区、墨西哥、东南亚,包括国内华东、华中的很多省份,都已经有大量团队在采集这种数据。只要是单目视频或者双目视频,下游基本都会要,只是价格会有所区别。真正有门槛的是Ego Vision Plus这类数据,对采集要求会更高。
6. 现在具身数据的需求是什么量级?
从去年到今年,我最大的体感是,下游客户对于数据规模的需求增长速度非常惊人。
去年10月份之前,大家跟我们讨论数据的时候,单位还是"几千小时",基本都是按千小时来聊。
到了年底,Generalist发布了一个工作,公开宣称使用了约27万小时的数据集。虽然它主要是手持夹爪数据,并不是纯Ego Vision,只有少部分带Ego Vision,但从那一天开始,所有来找我们交流的客户,起步就是30万小时。
今年年初,又有Generalist、Sunday等团队,用50万小时甚至上千万条数据去验证Scaling Law,因此整个行业的需求又迅速跳到了50万小时。50万小时已经成为新的起点。
最近几个月,大家开始讨论100万小时的数据规模。甚至有一家海外公司告诉我们:"你们明年要准备迎接1000万小时的数据需求。"
这个数字远远超出了我的预期(虽然我未必信)。
因为到目前为止,自动驾驶行业其实都没有使用过这么大规模的数据。我反而不是担心他们买不起数据,而是担心他们是否真的有足够的算力预算,同时承担数据和训练成本,以及是否真的能“玩得动”这么大体量的数据。
所以目前我认为1000万小时的说法仍有一定夸张成分,但100万小时我认为是真实需求。因此,今年我们扩充产能,也是按照100万小时这个目标去规划的。
7. 数据公司怎么应对数据范式的迭代
如果抽象来看,本质上就是一个问题:下游模型不断变化,到底对我们来说是好事还是坏事?我认为,波动本身一定是好事。在商业竞争里面,最怕的不是变化,而是收敛。
如果下游最后只剩下几家大客户,需求完全固定,价格完全透明,而供应商却越来越多,最终所有人只能不断比价,利润被压到刚刚能够活下来、但赚不到钱的水平,那才是真正危险。
所以,下游不断迭代、不断出现新的技术路线,对数据公司来说反而意味着更多机会。
真正的问题不是如何跟着每一种模型变化,而是退一步思考:这些模型到底在学习什么?我一直特别认可一个观点。这一轮具身智能、人形机器人,包括数据产业的发展,本质上是一场仿生学革命。
机器人本体越来越接近人体结构;模型越来越接近人大脑和小脑的学习方式;数据来源也越来越拟人化,越来越依赖人类真实的交互行为和动作行为。
因此,我们真正应该关注的,不是某一个模型今天需要什么,而是人类完成一个任务时,到底使用了哪些最本源的信息。
我认为,无论模型怎么变化,本质上都在学习两类东西:第一类是规则(Rules),第二类是先验知识(Human Prior)。
所以,我们采集数据时,并不是围绕某一个机器人本体,也不是围绕某一个模型架构,而是围绕人本身。我要保证,人完成一个任务时所依赖的全部物理信息,都能够被数字化,而且精度至少达到人类自身感知系统能够感受到的水平。
举个简单例子。比如我刚才调整了一下自己的坐姿。这是一个非常简单的动作,但实际上我用到了很多不同的信息。
首先是视觉。视觉主要提供的是先验,所以并不需要特别高的精度。我只需要知道大家大概在哪个方向。
其次是本体感觉,也就是我对于自己身体姿态、手部姿态的感知。在人身上,这是小脑完成的;而对于机器人训练数据来说,只能依靠动作捕捉系统去数字化。本体感觉告诉我,我现在是什么姿态,要如何从当前姿态调整到目标姿态。除此之外,还有触觉。臀部、腿部、脚底的触觉,都参与了这个动作。
所以,如果我要把这个能力迁移到机器人身上,我就必须采集这些对应的信息。包括身体位姿、环境信息、地形、椅子的几何模型、工具轨迹、触觉、本体感觉等等。这些模态共同构成了人完成这个动作所依赖的全部信息。
因此,我应对模型范式变化的方法其实很简单。我不管未来是VLA、World Action Model,还是新的模型架构。因为无论采用什么模型,人完成任务时依赖的信息不会变。
我要做的,就是尽可能以合理的成本,把这些真正有价值的人类信息全部数字化。只要这些模态都被完整采集下来,我认为它们不会因为模型范式变化而失去价值。长期来看,这些数据不会被淘汰。
8. 真正重要的数据是重建出人类感知世界的Input
(Danfei Xu老师专访Danfei Xu:人类数据是伪装成另一种形式的机器人数据其实也提到过一个类似的观点。核心问题就是,人到底是如何利用我们的感官完成与世界的交互?机器人又如何复现这些Human Input?)
对。本质上就是围绕人的交互行为,无论是大空间动作,还是精细操作,把所有真正有价值的模态完整数字化。我认为,这件事情本质上就是在蒸馏Physical World,蒸馏人类能力本身。
我再举一个更具体的例子。触觉的感知为什么我们最后选择的是柔性触觉传感器?其实它们并不是精度最高的。原因很简单,因为人的触觉本来就没有那么高的绝对精度。
事实上,人几乎所有的感知都是相对测量,而不是绝对测量。无论是姿态、亮度、疼痛、重量、力量,甚至颜色,我们感知的都是相对变化。比如你一直盯着一块红色屏幕,看久之后再看别的东西,都会觉得偏绿色,因为视觉本身就是相对测量。
因此,当我选择传感器时,如果必须在绝对精度、量程、鲁棒性、稳定性之间做取舍,我往往会优先放弃绝对精度。这一点和很多机器人团队不太一样。
很多人在选择传感器时,首先关注的是精度指标,例如比例因子、交叉耦合误差、RMS等各种性能参数。这些我当然也会看。但如果这些指标与分辨率、量程、稳定性、鲁棒性发生冲突,我会优先选择后者。因为人的感知系统本身就没有那么高的绝对精度,却拥有极高的量程、鲁棒性、稳定性,以及自修复能力。我认为,这才是真正值得机器人学习的地方。
9. 关于World Compiler
关于这个问题,其实我专门写过一篇Blog(https://noitomrobotics.com/world-compiler/),大家可以去ModalityNet官网看看,目前已经发布了两篇Blog。第一篇由我们的首席科学家韩磊博士执笔,第二篇则是我写的,标题叫“World Compiler”。
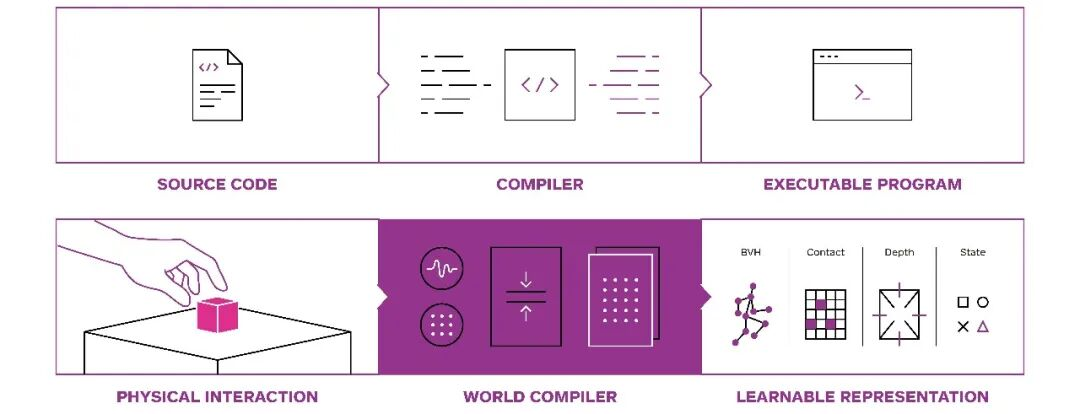
我当时写这篇文章,其实是想写一篇"檄文"。所谓檄文,一方面是写给内部团队看的,另一方面也是写给整个行业看的。互联网是有记录的,我希望把自己的观点提前留在这里。多年以后,即使被证明有些地方不对,我也不怕被打脸。但我希望大家知道,这些观点不是事后总结,而是很多年前我们这群人就已经明确提出过。
刚才我提到,Noitom Robotics现在做的数据业务,本质上是在蒸馏物理世界的信息,也是在蒸馏人类的能力。而这个蒸馏过程,我认为可以分成两个阶段。
第一阶段,是把世界记录下来,也就是完成数据采集。但采集得到的Raw Data,本身其实非常缺乏可学习性(Learnability)。 因为它本质上是不结构化的信息,只包含最原始的传感器数据和视觉数据。当然,大模型作为一个黑盒,可能会在Latent Space中自己学会很多能力。
第二阶段,是把采集下来的Raw Data编译成模型能直接学习的信息。过去这么多年的经验告诉我们,如果能够先对这些原始数据进行一次类似"编译"(Compile)的处理,把它转换成更加结构化的信息,再送入模型训练,训练效率会明显更高,投在数据上的ROI也会更高。这个结构化与抽象化的“编译”的过程也是一个“压缩”的过程,能把最重要的结构化信息提炼出来,让模型聚焦关注学习。
我之所以把这个过程称为“Compile”,其实是借用了软件开发里的概念。我们平时写Python、C++等程序,本质上写的都是一种接近自然语言的高级语言。这些代码本身机器并不能直接执行。只有经过编译器(Compiler)转换之后,机器才能真正理解并执行。
我认为,数据也是一样的。Raw Data就像源代码,它本身并不是最适合模型学习的形式。如果能够经过一层“编译”,把它转换成更加结构化、更容易学习的数据,那么整个训练过程就会更加高效。
举个例子。如果我只有一段Ego Vision视频,它本身只是视觉数据。但如果我进一步从里面估计出Hand Pose、Depth、触觉信息,甚至根据已有的信息进一步推断出全身位姿,那么原本一份比较难学习的数据,就会变成一份更加容易学习的数据。整个过程,其实就是不断提高原始数据的结构化程度,提高它的可学习性(Learnability)。
所以我认为,提高Raw Data的结构化程度、提高数据的可学习性,是未来数据行业一个非常重要的方向。这件事情总归需要有人去做。如果不是我们这些数据公司来做,那最终也一定会由模型公司的数据团队来完成。
不过我对此还是比较有信心,因为很多甲方的数据团队其实只有五六个人,他们很难长期投入大量资源完成这样一套完整的数据编译流程。但我们有一百多人的团队,长期只专注做这一件事情,所以我们能够把这件事情做得更加专业。
因此,我一直认为,提高数据的可学习性,把数据中更多能够被模型学习的信息提取出来,是一件非常有价值的事情。事实上,现在几乎所有客户都提出了类似需求。例如文字标注、语义标注,有的是逐秒、逐帧标注,有的是按场景、按任务进行分段标注。这些工作的本质,其实都是在提升数据的可学习性。
从商业模式来看,如果一家数据公司只是购买大量设备、招聘大量人员,采集完数据之后,原封不动地交付给客户,那么在充分竞争的市场里,它最终能够获得的定价,本质上就是设备折旧加人工成本。
因为市场最终会回归成本定价。你投入什么成本,充分竞争之后,就只能获得与成本相匹配的收益。但数据的可学习性不同。它本质上是一个“黑箱”,也是数据服务商与客户之间真正创造价值的部分。
如果我们能够在这个黑箱里做出更多能力,例如不断提高数据的结构化程度、提炼出更多可学习的信息,那么数据本身就能够形成溢价。这样不仅能够让数据公司建立真正的竞争壁垒,把这门生意做得更好,对模型公司来说,同样能够获得更高质量、更高训练效率的数据,实现双方共赢。
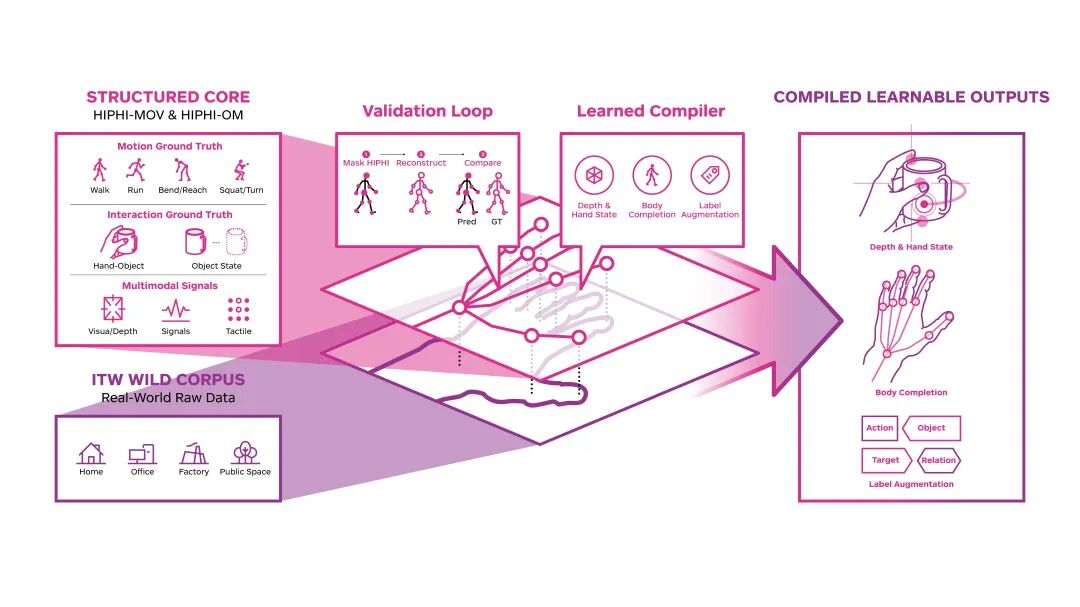
10. 如何提高数据的可学习性?
(刚才我们一直在讨论数据的可学习性(Learnability)。具体来说,有没有一些例子可以说明,如何提升现有数据的可学习性?例如刚才介绍的诺亦腾三类数据,它们分别是如何提高可学习性的?)
首先,刚才提到的三类数据,它们的可学习性其实完全不同。
前两类数据(MOV和OM)的可学习性非常高。原因在于,它们本身已经高度结构化,包含了大量Ground Truth级别的信息,例如Ground Truth级别的触觉、本体姿态等各种真实模态,因此模型学习起来非常直接。
当然,即便如此,它们仍然需要进一步补充一些可学习信息,例如场景标注、过程标注、语义标注等。现在利用多模态大模型,通过Post-training,其实已经能够自动完成质量很高的语义标注。硅谷现在已经有不少团队专门做这件事情。
他们拿到大量Ego Vision数据之后,收费进行自动语义标注。比如每小时数据额外收取几美元,如果处理10万小时的数据,就是几十万美元的生意。这已经成为一个独立的数据服务市场。
相比之下,第三类数据——也就是纯Ego Vision数据——可学习性就差很多。因为它本质上只是前两类全模态数据中的一个真子集,只保留了视觉信息,以及少量稀疏的其他模态,因此天然缺失了大量信息。也正因为如此,它的可学习性明显更低。
需要关注的是,我们的三个数据集是可以互相支撑的,在全模态,全维度的数据积累基础上,我可以把第三类数据做远远优于行业的后处理。可能我的深度估计比别人更准确,我的Hand Pose估计比别人更准确。别人估计Hand Pose可能只有两厘米左右的误差,我可以做到亚厘米级。甚至别人根本没有拍到腿部,我依然能够把腿部姿态估计出来。这些能力,我认为,才是真正有意思的地方。
11. 如何验证数据可学习性的提高?
(这些数据最终都是给模型学习的,但其实我们并不知道模型究竟是通过哪些信息完成学习的。那么,我们如何判断哪些信息是真正有价值的?我们又如何验证?)
其实我可以把这个问题再往底层推进一步。真正的问题其实是:我们自己,以及我们的客户,如何验证一份数据到底是不是好数据?一种可学习性的提升,到底有没有真正产生价值?这其实是整个数据行业最大的挑战。
大家有没有发现,数据交易对于数据供应商来说,其实是一件非常不公平的事情。因为它是一个典型的后验市场。
举个例子。我卖给客户10万小时数据,每小时200元,总共2000万元。客户把数据拿回去训练模型,四五个月、半年以后,如果模型效果不好,Loss降不下来,成功率只有40%,双方一定会开始扯皮。客户会说:“你的数据不行。”我可能会说:“是你的模型团队能力不行。”这种事情几乎不可避免。
而所有后验交易都有一个共同特点,就是利润率不会太高。因为客户控制风险的方法,就是提前压价。客户会认为:“我现在就要付钱,而效果要几个月之后才能知道,所以我一定要把价格压下来。”
因此,数据公司的毛利天然就会受到影响。所以,我认为最好的办法,是在交付之前,就能够在同一条技术路线下证明数据确实有价值。
这也是为什么我们现在八九十位正式员工里面,有二十多位专门做模型研究。很多人会觉得奇怪,一家数据公司为什么需要这么多研究员?其实原因就在这里。
他们的工作主要分为三部分。第一,是做感知交互相关算法。第二,是做数据增广、模态补全以及后处理算法。第三,就是做模型验证。
我们的研究团队会使用和客户相同的技术路线。他们会训练VLA,会训练World Action Model,也会训练动作基础模型和Teleoperation基础模型。当然,我们训练的规模会比客户小得多。因为我们不会真正去训练一个可以商业部署的模型,而是去验证数据。
例如,我们会从完整数据集中随机抽取十分之一、百分之一的数据,观察Loss是否持续收敛。同时,我们还会验证Scaling Law。例如,同样抽取百分之一的数据,来自5000小时数据集和5万小时数据集,看看更大的数据规模以及更好的数据分布是否确实能够带来更好
的训练收益。
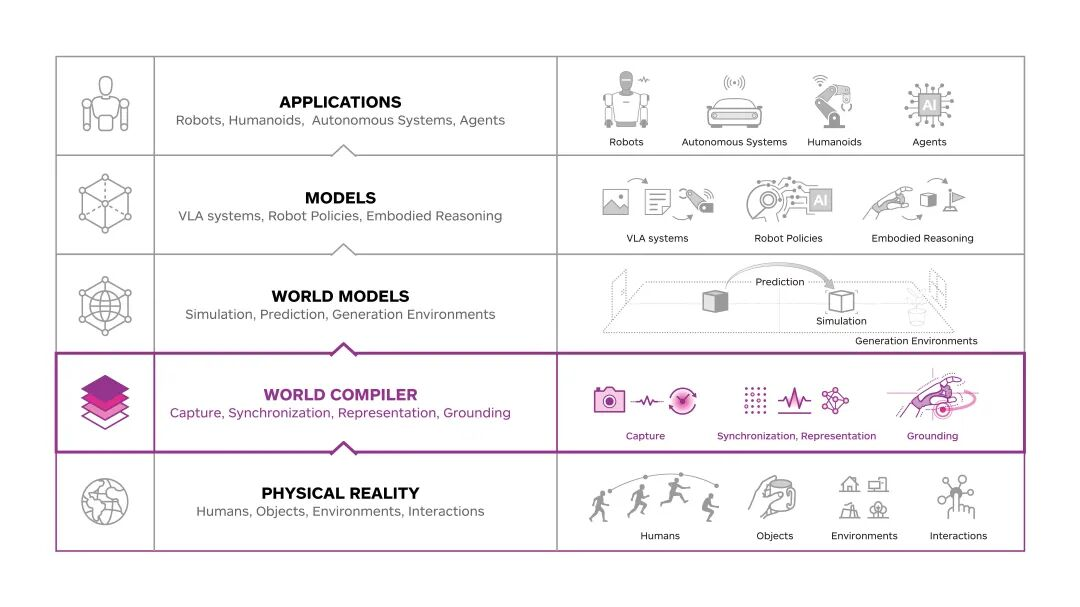
(所以World Compiler这个概念,您真正想表达的是,未来Physical AI真正需要的,并不是简单的数据,而是模型真正能够理解、能够学习的数据。数据公司真正要做的,就是把这些“可学习的特质”提炼出来?)
对。如果再把这个观点说得更简单一点,就是:当我们还没有能力把所有模态、所有维度的数据全部采集下来时,我们有没有能力把缺失的模态和维度补全?而这个补全过程,本质上就是一种解释的过程。也正是“World Compiler”真正想解决的问题。
编者按
“具身数据公司本质上是在蒸馏物理世界和人类的能力,它的价值在于通过将各类传感器采集到的物理世界信号与表征人类能力的信号,编译成可被模型直接学习的数据。”这句话,是我对本期访谈嘉宾核心观点的高度概括,也是这个数据集致力于解决的问题。
Ref:
1. NR官网:
2. ModalityNet:
https://noitomrobotics.com/art-of-modalities/
3. World Compiler:
https://noitomrobotics.com/world-compiler/
Bones Studio: