人形机器人通用控制器系列,我们在专访Xue Bin(Jason) Peng:探索人形机器人全身运控的通用控制器,专访罗正宜:解密PHC——人形机器人通用控制器,以及2025年的Human Data系列总结篇:Human Data—The “Key” to Robot Data的一系列采访都有涉及。这期文章,我再次邀请到了罗正宜博士,来聊一聊在人形机器人全身运控领域家喻户晓的工作SONIC。
罗正宜(Zhengyi Luo)是英伟达GEAR实验室的一名研究科学家,博士毕业于CMU,他的导师是 Kris Kitani 教授。在此之前,他于2019年在宾夕法尼亚大学获得了本科学位,并曾在 Kostas Daniilidis 教授的指导下开展研究工作。罗正宜博士的的研究兴趣主要集中在视觉、学习与机器人技术的交叉领域。主要研究方向包括人体姿态估计、人-物交互建模、人类运动建模等。关于Sonic工作的开源信息,大家也可以关注罗正宜的小红书账号来实时跟进。
本期访谈也可在小宇宙或Apple Podcasts的ReSpark栏目收听。
查看原文目录
以下为本文目录
👇
1. Sonic的核心思想
2. 模型方法介绍
3. Sonic性能的特色
4. Sonic训练数据的特色
5. 关于Data Retargeting
6. Retargeting最难的问题是什么?
7. 人与物体交互的数据
8. Sonic有哪些应用
9. Sonic对不同型号机器人的适配性
10. Sonic的开源状态
11. 一些问题
-retargeting vs SMPL
-惯性动捕 vs VR
-VLA-Controller
-轮式双臂 vs 双足
-跨embodiment的通用controller
-大幅度强交互场景
-通用和专用
-进一步的算力和规模提升
-多模态
1. Sonic的核心思想
如果要概括Sonic的核心,它本质上是在做基于motion tracking的控制方法,并在此基础上进行scale up,把motion tracking的能力扩展到更大的规模和更完整的系统层面,目标是构建一个通用的人形机器人控制器。
所以在主旨和目标上,它和PHC是非常接近的。两者都是围绕“用motion tracking来驱动人形机器人控制”这条技术路径展开的。只是PHC当时是在比较有限的条件下,由个人单独推进完成的,更偏向方法层面的实现和验证。
而现在做Sonic,因为是在一个更大的团队框架下进行,就会引入更多现实和工程层面的考量。也就是说,它不仅要在算法层面成立,还要在系统层面可用。比如会更强调把Sonic做得更加实用,让它能够比较快地进入具体应用场景,作为一个通用控制器被实际部署。
它可以用于真实机器人的数据采集,也可以和更高层级的模型协同,例如VLA,或者我们所说的System One/System Two结构,在这种分层体系下,高层模型负责策略或决策,Sonic作为底层控制模块负责执行。
所以从这个角度看,Sonic更像是PHC在真实人形机器人、在physical robot场景上的一次延展,而且是在规模、系统完整度和应用范围上的进一步拓展。
2. 模型方法介绍
从整体上看,Sonic本质上是一个基于强化学习训练的framework。
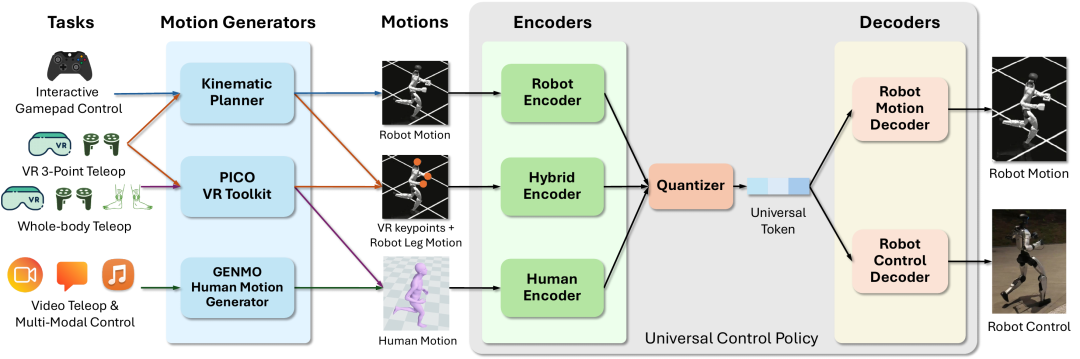
第一步是数据。我们有700小时的人类动捕数据。通过retargeting到G1,我们得到成对的数据,也就是paired data:一边是人的动作,一边是对应的机器人动作。
有了这些数据之后,我们训练了三个encoder,分别对应三种接口。
一个是robot encoder,对应机器人自身的动作输入。
一个是human encoder,对应完整的人类动作输入。
还有一个是hybrid encoder,上半身是三点(比如VR的头和双手),下半身是机器人动作或自动生成的动作。
这三个encoder学习的是把不同形式的输入映射到同一个latent space。因为虽然输入形式不同,但它们在语义上最终对应的是同一种“动作意图”。对于人形机器人来说,所有这些动作最终都可以理解为对人类动作空间的一种表达。
所以我们把这三种表示都对齐到同一个latent space。然后这个latent会送进一个decoder,你可以理解为它把latent表达翻译成具体的机器人关节动作指令。最终输出的是机器人应该如何运动。
整个过程是在强化学习框架下完成的。三个encoder是一起训练的,而不是分开训练。我们使用大量并行环境做RL训练,比如有非常大规模的环境数量,每个encoder分配一部分环境,同时进行训练。
除了RL的主目标外,还会有额外的loss,用来对齐三个encoder的latent space,让它们在隐空间里尽可能一致。通过这种方式,不同接口在底层共享同一个动作表示空间,从而实现无缝切换。
最终得到的,就是现在看到的效果。
3. Sonic性能的特色
network size、dataset volume、算力的提升是相对于什么基准而言的,以及这些数量级的增长具体意味着什么?
其实可以从两个维度去理解这件事情。如果做比较的话,一个维度是和animation或者之前的motion tracking工作去比,比如和PHC比。
在我看来,Sonic在一些效果上其实已经明显超过PHC。PHC还是在虚拟环境里,而Sonic已经是在真实世界、在真实的physical robot上运行。从这个意义上讲,它已经跨过了从simulation到现实的门槛。
如果单纯从motion tracking本身的规模来看,相比之前的PHC、MaskedMimic这些方法,Sonic在数量级上已经有明显提升。它的network规模更大,模型容量更强,通用性也更好。这是和animation方向的motion tracking去比较。
另一个维度是在robotics里去比较。比如在G1这一类平台上,其实在通用motion tracking方面,之前也有很多非常优秀的工作,比如BeyondMimic、GMTHuman Data EP02—MoCap:GMT、AnyTrack等等,这些都是非常扎实的探索。
和这些工作相比,Sonic更强调的是scaling,也就是系统性地把三个维度同时做大:network变得更大,dataset变得更大,compute变得更多。这三者是强耦合的。
首先是data。最关键的是你是否有足够多的人类数据。在teleoperation场景下,比如全身遥操作,我们希望机器人能够复现人所做的动作。这个主旨其实和PHC是一致的。为了实现这一点,我们希望这个通用控制器,也就是这个motion tracker,可以学习“人做什么,机器人就能做什么”。
那么数据量就变得非常关键。之前做PHC的时候,用的是academic dataset,大约40小时。而这次在Sonic里,我们把规模提升到了700小时,这是一个数量级上的跃迁。确实可以看到,当数据规模上到这个级别之后,泛化能力有明显提升。很多Sonic的结果是我们自己也比较惊讶的,比如在摔倒之后不会出现明显失控,在一些更extreme case下仍然保持稳定,这些都说明泛化边界被推开了。
接下来是compute和model size。它们和数据是联动的。当数据规模变大之后,训练所需的compute也必然上升。比如我们现在有700小时的数据,在paper里写到大概对应35万条trajectory。相比之前比如12万条的数据规模,这是显著增加的。
因为我们是基于simulation做强化学习训练,当数据规模变大时,就需要更多并行环境来降低gradient noise。我们在实验中也看到,当number of environments提升、compute提升之后,梯度会变得更稳定,学习速度更快,对dataset的coverage也更好。换句话说,模型可以更充分地吸收这些数据。
而模型规模本身也是同样的逻辑。当行为多样性提升之后,从基本走路到acrobatics、跳跃、更加dynamic的动作,模型需要覆盖的behavior空间显著扩大。如果模型容量不足,是无法承载这些复杂行为的。所以data、compute、model size这三个axis是相互促进、同时放大的。
另外,如果和一些非motion-tracking的humanoid controller比,比如HoME、AMO等这些工作,它们很多采用的是decoupled结构,比如下半身用local motion policy,上半身用IK或neural IK,不直接使用人类数据来驱动机器人。
相比之下,Sonic更强调用motion tracking作为一个高度scalable的任务定义,通过人类数据直接驱动机器人的行为学习,从而打破行为种类上的限制,让机器人支持更丰富、更统一的humanoid behavior。
4. Sonic训练数据的特色
这 700 小时的数据具体由哪些类型构成(是否包含光学 mocap、惯性动捕等)、整体分布如何,以及在动作多样性上相比PHC有哪些提升?
首先,这700小时的数据我们也在推进开源。会有相当大一部分数据对外发布,供社区使用。对于学术界来说,这是一个在数量级上明显更大的数据集,可以让更多人基于同一套高质量数据开展研究。
这个数据集目前全部是光学动捕数据,因此在精度和质量上是非常高的。我们内部也在讨论是否加入一部分惯性动捕数据,这还在评估阶段。我个人觉得惯性动捕的数据肯定是有价值的,只是需要找到更合适的方式去利用它。如果后续加入,我们也会探索怎样把这些数据更有效地整合进训练流程。
关于数据构建本身,我们在采集时是有一整套脚本设计的。这套script会系统性地覆盖各种不同类别的动作,尽量保证动作空间的多样性。这个数据集最初的动机其实并不是为了机器人,而是为了digital human。在英伟达内部,过去就有很多围绕animation和digital human的工作积累,这些数据其实在很早之前就已经开始建设。
我们在机器人方向上更多是做了一套高质量的retarget,使得机器人能够很好地利用这些数据。因为数据本身是为animation、游戏和digital human场景准备的,所以在动作设计上非常丰富。比如会带有text label,也会尽量覆盖人类在游戏或虚拟角色场景中可能涉及的各种行为,比如开门、上下楼梯等。凡是你能在digital human或游戏里想到的动作类型,我们都会尽量纳入。
当然,即便是700小时这样规模的数据集,也远谈不上完备。比如我们就发现,像“弯腰从地上捡东西”这种在现实中非常常见的动作,数据里其实并没有特别多。这说明即使在这个数量级下,依然会存在覆盖不足的区域。
所以我们也希望,通过开源这个数据集,能够鼓励更多机构或团队开放他们的动捕数据。只有在community层面形成更大的数据集合,整个领域才能真正受益。这样collective地扩充数据覆盖范围,对humanoid控制和motion tracking方向的长期发展都会是非常有利的。
即便我们现在已经有700小时的数据、35万条trajectory,人类能够做的动作空间依然是极其庞大的。比如像单脚跳这种动作,在数据集中可能也就几十条或者几百条,其实数量并不算多。因为人类能做、想做的行为本身是高度开放、无限组合的,所以从覆盖角度来看,700小时虽然已经是一个数量级上的提升,但仍然远远谈不上完备。
我认为这已经比过去的数据规模有明显跃迁,但仍然有大量行为可以继续采集。随着数据继续扩展,controller的效果也一定还有提升空间。
5. 关于Data Retargeting
Data retargeting本身依然是一个没有被彻底解决的问题。我们团队在这件事情上投入了非常多时间,而且不只是我们组,英伟达内部原本做digital human的一些团队也参与进来,帮助我们一起优化retargeting流程。这件事情非常耗时耗力,但即便如此,它依然是一个开放问题。
我们在实践中也会参考一些开源方法。比如在文章里提到,我们使用了新开源的GMR,以及Pirocky作为open-source reference,在这些框架之上做二次开发。我们也尝试过不同的开源retargeting方案。但目前来看,retargeting仍然是一个关键且未完全解决的环节。
问题的核心在于embodiment gap。比如当动捕素材中的人做脚尖抬起这样的动作时,人类的脚是高度灵活的,而G1这样的机器人在足部结构上并不具备同样的自由度。人和机器人在物理结构上的差异,会导致某些动作在映射时出现不可避免的偏差。
当我们更换机器人平台时,这个问题会更加明显。尤其是在一些edge cases下,retargeting是否能合理处理这些结构不匹配的问题,会直接影响控制效果。这些细节都非常棘手,而且目前还没有一个通用且完全鲁棒的解决方案。
另外一个重要问题是,retargeting之后一定要形成闭环。也就是说,retarget完之后必须再去训练你自己的控制器,而不能把retarget结果直接当成最终解。
因为在实际做retarget的过程中,我慢慢意识到一个问题:机器人,尤其是人形机器人,对动作的优美程度、smoothness、以及整体流畅性的要求,其实比animation或游戏场景更高。
在游戏或动画里,只要动作“看起来差不多”就可以。比如角色做一个动作,大体形态是对的,哪怕有一点点穿模,或者某些地方有轻微的卡顿,观感上通常是可以接受的。因为它是视觉媒介,观众主要通过屏幕去看,只要整体效果说得过去,就不会有太强的违和感。但机器人有两个本质不同的地方。
第一,它是physical的。它是在现实世界中运动的。只要它走路时有一点打滑,或者脚落地时顿了一下,这种物理上的不连续会直接通过声音、振动和视觉反馈放大出来。它不仅是“看起来不自然”,而是会在真实空间中产生很强的存在感。所以对motion的连续性、对生成动作是否真正“像人”,要求会非常高。
第二,机器人的尺度是实物尺度。我们在看动画或打游戏时,是通过屏幕观看,人物通常只占屏幕的一部分。很多细节即便存在,也不会特别显眼。但当一个一米三或者一米八高的机器人站在你面前时,哪怕它身体稍微后仰了一点,或者某一步落脚稍微顿了一下,这些细节都会被无限放大。那种不自然感是非常明显的。
因此,对motion quality的要求,对生成动作的精确度和流畅度的要求,其实比animation本身还要更高。我甚至会觉得,当时在PHC或PULSE里生成的一些humanoid动作,如果直接放到真实人形机器人上,可能在质量标准上都是不够的。
也正因为这样,retarget之后一定要再通过自己的controller去做闭环训练,让控制策略真正适配机器人的动力学和物理约束,而不是停留在“形似”的层面。
6. Retargeting最难的问题是什么?
其实我觉得 retargeting 本身现在已经发展得相当成熟了。从方法层面来说,整体框架是比较清晰的。现在更大的问题其实在edge cases,本质上是一个长尾问题。
比如说,像基本的走路,如果你的cost function设计得比较好,现在市面上大多数方法都是可行的。通常你会有一套比较标准的目标项,比如要match人的orientation、match人的position,然后通过优化的方式去求解。这一套在常规动作上是成立的。
但问题在于,不同类型的动作往往需要不同的cost设计。比如正常行走是一套cost function,但如果是盘腿坐,可能又需要完全不同的约束结构。如果这些解只是通过kinematic optimization得到,而没有在physics环境里做validation,那么就很容易出现问题。
例如,人类动捕数据本身没有penetration地面,但当你把动作映射到机器人模型上再通过优化求解时,解出来的结果可能会出现penetration。这是因为机器人的动力学结构和人的结构不同,单纯匹配姿态并不能保证物理合理性。
所以我觉得接下来一个很重要的方向,是physics-based retargeting。也就是说,在完成kinematic retarget之后,再在物理环境中把这套动作重新解一遍,让它在动力学上是physically valid的。同时在这个过程中去除一些不希望出现的artifact,比如某些手部非常高频的抖动,或者一些不自然的瞬时速度峰值。
这些问题不一定在主流动作上明显,但在edge cases上会被放大。而这些长尾情况,可能才是下一阶段真正需要系统性解决的部分。
7. 人与物体交互的数据
目前你们加入了多少与物体交互(local manipulation)的数据,未来是否会在这一方向上大幅增加数据规模和投入?
这是一个非常好的问题。我觉得这个问题需要分成两部分来看。
第一部分是关于训练一个通用controller,比如像Sonic这样的controller。当我们把Sonic训练完成之后,在实际使用它去做teleoperation或执行任务时,其实并不需要大量专门针对manipulation的特定数据来训练这个“通用控制器”。
因为从控制器的角度来看,很多动作在动力学层面是等价的。比如我在空中随便挥动手臂,和我手里拿着一个很轻的物体挥动手臂,对于控制器来说,本质上没有太大区别。唯一的区别是物体带来的附加质量和惯性。如果这个物体的重量可以近似忽略,那么只要控制器能够把动作轨迹本身做出来,通过teleoperation或上层指令,它就已经具备执行manipulation的能力。
也就是说,在轻物体loco-manipulation的场景下,通用motion controller本身已经覆盖了很大一部分能力。
但问题会出现在另外一些场景。比如当机器人要和比较大的物体交互,例如推一个箱子,或者搬运一个较重的物体,这时物体的质量、接触力、反作用力都会显著影响动力学行为。在这种情况下,控制策略就不能简单复现原始的人类动作,而必须根据物体属性做出调整。这类interaction数据是可能需要额外收集和建模的。
另外一个维度是terrain和环境交互。比如在不同地面条件下行走,像斜坡、台阶、较大的障碍物,或者楼梯等场景,这些都会对接触模式和重心控制产生显著影响。在这些情况下,仅仅依靠通用的motion tracking数据是不够的,相关的环境交互数据和训练过程还是有必要的。
所以,从控制器角度看,轻量级manipulation并不一定需要大量专门数据,但涉及大负载物体或者复杂地形交互时,额外的数据和训练仍然是必要的。
只要某个动作对机器人自身整体姿态和动力学结构的影响不大,那么在训练一个通用控制器(比如Sonic这种controller)的时候,并不一定需要大量专门的交互数据。
也就是说,如果动作本身主要是在身体自由空间内完成,不涉及明显的外力耦合或者大幅改变系统动力学,那么通用的motion tracking数据基本已经足够支撑控制器学习。
但这些交互数据依然是有价值的,只是用途不同。
比如当我们把通用控制器训练完成之后,要做更具体的任务级应用,例如和物体交互。在Sonic里我们展示过一个例子,比如拿一个苹果,从一个位置移动到另一个位置,这是一个和VLA integration结合的任务。
在这种情况下,loco-manipulation的数据就会变得重要。因为这不仅是复现一个动作轨迹,还涉及到物体接触、抓取稳定性、轨迹规划等问题。
不过,这类数据并不一定必须是光学动捕数据。它可以来自遥操作(teleoperation),也可以来自第三人称视频数据,甚至是基于人类演示的视频数据。这些都可能成为有价值的数据来源,用于在通用控制器之上补充任务级交互能力。
所以通用motion controller的训练和具体manipulation数据的使用,是两个不同层级的问题。前者更多是关于身体运动能力本身,后者则是围绕具体任务和环境交互展开。
也就是说,底层controller主要学习“怎么动”的运动控制本身,不需要大量交互数据,而更高层的“拿什么、怎么拿”的任务理解则更多依赖视频等上层数据来指导——可以这样理解吗?
这里其实还有一个问题,就是要不要在训练阶段就同时引入perception,比如image或3D perception。
像英伟达刚发布的EgoScale,就是用human-centric数据去训练专门做manipulation的模型。这类数据是task-specific的,专门围绕操作任务构建。
而我们训练Sonic用的是光学动捕数据,重点是学习身体运动和通用控制能力。两种数据是互通的,但关注点不同:光学动捕更偏向motion control,本身不依赖perception;而human-centric manipulation数据更强调perception和action的耦合,用于具体任务。
所以它们是两个层级的问题,一个是通用身体控制,一个是具体操作任务。
在controller层面,如果把数据规模从700小时进一步扩大,性能提升是否仍然显著?以及大概到什么数据量级可以认为这个controller已经趋于成熟或接近“完美”?
我觉得这是一个非常好的问题,我们其实也在探索这件事情。现在700小时的数据,对于一些比较基础、通用的动作已经没有太大问题。但最终还是要看需求——你希望机器人做什么。
比如说,如果你想让机器人去叠衣服,就会遇到新的问题。叠衣服需要大量精细的手腕动作,而在我们采集光学动捕数据的时候,并没有特别强调手腕这种高精度局部动作。那么这类数据可能就需要额外补充,要么重新采集,要么做data augmentation。也就是说,虽然当前数据覆盖了比较大的动作类别,但一旦任务变得更细、更专门化,就会暴露数据覆盖不足的问题。
再比如,从地上弯腰捡东西。已经有不少人测试过Sonic做这类动作。一方面是因为G1的手臂长度有限,reach本身受限;另一方面,比如跪在地上去够地面的物体时,有时候确实够不到。这些都说明在某些具体场景下,controller还存在短板,可能需要更多针对性的动作数据来补充。
所以简单来说,是按需求迭代。我们会用Sonic去做各种遥操作演示,然后根据这些具体动作的表现,再去补充数据。比如在宣传片里,有一段是单腿踩垃圾桶把盖子打开,这种动作就需要更deliberate的单腿平衡能力。这种更specialized的数据,可能是现有数据里覆盖不充分的。
甚至不仅是数据层面,在controller formulation上,比如reward设计,也可能需要针对这些特殊动作做一些微调,让系统更好地支持这些行为。
8. Sonic有哪些应用
Sonic从某种意义上来说,是PHC的一个延展。但这个“延展”不只是规模上的,而更多体现在易用性和实用性上。
比如,全身遥操作本身是一件非常直观、也非常强大的事情。人做什么动作,机器人就做什么动作,这在表达能力上是非常完整的。但问题是,全身遥操并不适合长距离移动。比如从A走到B,如果距离很长,人需要一直跟着走,而机器人的步幅、动力学结构和人也不同,所以这种方式效率不高,也不自然。实际使用时,人往往需要跟在后面不断调整。
所以从“navigation从A到B”这个角度来看,我们更需要的是一个planner。就像在游戏里一样,你推一个摇杆,说往前走,角色就会自动往前走。我们希望机器人也有这种能力。
因此我们设计了几种更具应用性的接口。底层始终是同一个motion tracker——你给它一段人或者机器人的动作,它就能复现。
第一种接口是全身遥操。人的动作直接输入给Sonic,它负责tracking。
第二种接口是joystick+kinematic planner。也就是说,当你只给一个高层指令,比如“往前走”“往后退”“跑步”时,我们通过一个kinematic planner(可以理解为一个运动生成器)去生成对应的机器人动作序列,然后再把这些生成的动作发给Sonic。Sonic再把这些动作转成每个关节的控制信号。这样你只需要推一个摇杆,机器人就可以自然地走、跑,而不需要人全身参与。
另外,我们还做了一个三点式的接口,更贴近很多VR遥操场景。很多人并不是全身动捕,而是通过VR控制器控制头和双手三个点。我们设计的是:上半身用VR的三点输入,下半身通过planner自动补全,比如根据“前进/后退”指令生成步态。然后把补全后的完整动作送给Sonic去tracking。这样用户只需要控制上半身和方向,下半身自动生成,实现更轻量的遥操方式。
再比如text-to-motion。我们展示过语音控制跳舞,其实用的是英伟达之前的工作GEMO(一个human motion generation模型),通过音乐或文本生成一段人的动作。然后我们把这段“人类动作”输入给Sonic,接口和全身遥操是一样的——本质都是给它一段人体动作轨迹,它负责在机器人上复现。
所以整个设计思路是:底层统一是motion tracking控制器,上层可以接不同形式的输入——全身动捕、joystick+planner、VR三点控制、甚至text/music生成的动作。这样系统在保持统一底层的同时,大幅提升了实用性和可用性。
9. Sonic对不同型号机器人的适配性
如果是不同的机器人平台,那底层控制器大概率是需要重新训练的。我们也会把训练相关的代码开源出来。虽然现在主要是基于G1,但我们已经有一些非常preliminary的其他机器人支持,也希望开源社区可以一起参与,把更多机器人接入进来。
不过我们设计的这一整套接口是非常general的。你可以想象很多不同的使用方式。
比如做一个长距离遥操作:可以先用planner让机器人从A自动走到B;到达之后,再无缝切换到全身遥操,去做更精细的操作,比如开门、拿东西、叠衣服;做完之后,再切回planner,让它走到下一个位置。整个过程可以非常自然地切换。
之所以可以这么无缝,是因为在训练时,我们把不同接口的latent space学到了一起。也就是说,这几种输入方式在底层共享同一个motion tracking控制器,所以它们之间可以平滑过渡,而不是完全独立的系统。
我们的一个核心想法是:无论是全身动捕、planner生成、还是VR三点控制,它们的本质都是“让机器人动起来”。既然目标都是生成一段机器人动作,那我们就统一用motion tracking这个框架去解决。motion tracking本身是一个非常general的任务——给定一段目标动作,让机器人去track它。
所以不同接口的差别,只在于“动作是怎么来的”:要么是人通过动捕给出来的;要么是通过生成模型生成的;要么是通过planner从高层指令生成的。只要最终我们把目标动作送进同一个motion tracking控制器,就可以统一解决各种输入方式的问题。
否则,如果不是以motion tracking作为底层统一机制,往往会变成:做不同任务就需要设计不同控制器。比如往前走是一套控制器,弯腰是一套,踢腿又是一套。那样系统就会变得碎片化,很难扩展。
我们现在这套设计的关键,就是用一个足够general的motion tracking控制器,把这些不同形式的输入统一起来。
10. Sonic的开源状态
现在开源的是模型和inference;还有整套遥操作,以及基本上你看到的那套deployment——把机器人部署到真机上跑起来,并且达到我们展示的同样效果。这些全部都开源了,包括我们自己的 deployment stack。我们也写了很详细的文档,说明怎么使用。已经有一些小伙伴拿它来做遥操采数据了。训练代码和训练数据暂时还没有开源。
我们自己在实际使用 Sonic 的过程中,也会发现一些问题或者可以优化的地方。只要我们内部验证过、确认改进是稳定有效的,就会陆续更新模型版本。希望通过持续迭代,让 Sonic 用起来更顺手、问题更少,也更稳定。
11. 一些问题
在使用VR进行全身遥操时,不是通过传统retargeting,而是将人体骨骼数据直接映射为机器人关节输入,这种设计背后的核心考虑和优势是什么?
其实如果回看Sonic最早的一些demo,当时中间是接了一层retargeting的。我们用过一个neural retargeter,也自己做过一些实验,效果是可以的。
但之所以后来不把它作为核心路径,是有几个现实考量。
首先,retargeting本身是一件非常困难的事情。你想让retarget出来的动作足够流畅,不滑步、不penetrate地面,这些都不容易。尤其是如果你想效果非常好,很多方法其实是偏offline的——也就是说,你拿到整段sequence,然后做整体优化,让整段动作变得平滑一致。
这种offline优化效果通常很好,因为你可以利用完整的时序信息。但问题是,全身遥操是streaming的数据输入,而且我们希望是高度realtime的。人在动,机器人几乎同步跟着动。
虽然现在也有实时retargeting方法,但实时版本和offline优化版本的效果一定是有差距的。这其实和rendering很像——电影级渲染通常是离线算很久,而实时渲染一定会做很多近似。retargeting也是一样的道理。你给我十个小时做离线优化,和你要求我毫秒级输出结果,本质难度是不同的。
另外,在全身遥操场景里,延迟是非常敏感的。人一做动作,机器人必须几乎立刻响应。如果中间再插一层retargeting,不管是neural的还是analytic的,都会引入额外delay。而且在线retarget本身也是一个open problem,比如sliding window多大、context用多少帧,这些都会影响延迟和效果之间的权衡。
所以我们后来选择了一种更直接的方式:既然我们已经有了paired data——人的动作和对应的机器人动作——那就直接在数据层面建立映射,让底层的neural network controller直接去学这个mapping。
换句话说,不是在线跑一个retargeting模块,而是通过强化学习,让controller本身具备“data retarget”的能力。也就是从人的动作表示直接映射到机器人的控制输出。
实践中我们发现,这种方式效果反而更好。同时我们在自己做neural retarget的过程中,也确实遇到了不少问题,比如在线情况下context怎么选、窗口怎么滑、如何在实时性和稳定性之间平衡,这些都非常棘手。
所以最终的选择,是把映射能力融入到强化学习框架里,而不是把retargeting当作一个独立的实时模块插在中间。
相比穿戴惯性动捕服进行全身遥操,用VR做全身遥操各自的优劣是什么,以及在实时性、准确性和实际落地成本上有什么差异?
因为我们对Sonic的定位很明确——它只是一个底层controller。至于你怎么得到人类动作,其实Sonic并不关心。它只负责接收动作,然后去track。
所以理论上,动捕服我们是完全可以兼容的。而之所以做VR方案,更多是出于易用性的考虑,而不是技术能力上的限制。
我们用的是PICO的全身方案。比如在脚上放两个tracker,就可以实现比较完整的动作捕捉。我们实际测试下来,实时性非常好,reliability也很高,生成出来的动作质量是足够好的。
而且部署成本很低。一个teleoperator基本上五分钟之内就可以把整套系统setup好,然后直接开始操作。不需要穿复杂的动捕服,也不需要反复recalibrate,这在真实应用场景中差别是非常大的。
同时,穿着VR设备本身是比较自由的,不需要额外的服装或复杂设备,操作体验也更自然。所以我们选择VR更多是从实用性和落地角度出发,而不是因为只能用VR。
本质上,Sonic作为controller是输入无关的——只要你能给它一段合理的人类动作,它都可以去track。
在与VLA结合时,是否可以理解为VLA主要输出高层动作指令,而具体的底层运动控制则由controller来执行——两者之间是这样一种分层关系吗?
这其实也是我们一直在探索的方向。在设计Sonic的latent space时,我们就已经在考虑将来VLA要怎么和全身动作控制器进行交互。
所以在设计隐空间的时候,是有前瞻性考虑的。比如我们让三个encoder都映射到同一个latent space,就是希望它成为一个统一的动作接口。这个latent本身是结构化的,不是随便学出来的embedding。
这些内容我们之后都会开源,包括训练代码,以及和第二组Flash/G系列模型打通的整套pipeline——从采集数据,到结合VLA做pick-and-place、trash can opening这类任务,我们都会开放出来。
我们自己也做了一些尝试。一个初步观察是:用已经学好的、结构化的latent space作为接口,比让VLA直接生成全身关节动作要好一些。当然这还是比较早期的结果,但确实有这样的趋势。
我个人对“VLA如何和全身控制器交互”这个问题非常感兴趣。因为全身动作必须通过像Sonic这样的底层policy来执行。理论上,最直接的方式是让VLA输出全身动作。但问题是,如果你只给root velocity或局部控制信号,很多精细动作是做不了的。比如单腿踩垃圾桶开盖这种动作,如果没有全身协调,是无法完成的。
所以理想状态是:VLA能够以某种形式告诉底层控制器“全身应该怎么动”。关键问题在于——这个“怎么给”。
我们尝试过两种方式:一种是直接生成全身动作;另一种是像现在这样,让VLA生成latent表达。目前感觉latent方式更好。因为它是压缩过的动作表示,而且我们的latent不是单帧的,而是包含十几帧的时序信息。这样和VLA结合后,生成出来的动作会更连贯、更流畅,而不是逐帧拼接。
这些探索性的结果,在我们开源代码以及GROOT integration的时候都会一起放出来。目前还属于比较早期的阶段,但方向是清晰的。
相比轮式双臂结构的人机系统,人形机器人由于可以利用海量人类视频数据进行训练,是否在长期数据迭代速度和VLA能力提升上更具优势,甚至可能在未来实现“弯道超车”?
其实双臂轮式机器人和带腿的人形机器人,在manipulation数据层面是高度互通的。对manipulation来说,最关键的是上半身——手、手臂、抓取能力。这部分的数据本质上是通用的。
两者真正的区别在于腿。带腿的人形机器人需要考虑下半身是否参与运动,而轮式双臂机器人下半身是稳定的、固定的,不需要解决步态和平衡问题。所以差别主要在locomotion,而不是manipulation本身。
比如我们刚刚发布的EgoScale,用的是人的egocentric数据,大概2万小时规模,用来训练manipulation模型。这些数据本身就是人类操作数据,本质上和是否带腿没有直接关系。再比如dexterous hand的数据,或者人类第一视角的数据,这些都可以直接用于manipulation学习。
如果带腿,那问题会变得更复杂。因为你不仅要做操作,还要解决站立和平衡问题。也就是说,你一边要稳定身体,一边还要完成manipulation。这确实是难上加难。
所以从能力上限来看,带腿的人形机器人是更高的。它可以去更多场景,可以移动、可以调整姿态、可以跨越空间完成任务。但从实现难度来看,下限也更低——如果系统不够稳定,它可能根本做不好,因为要解决的问题太多。
我觉得在短期内,双臂轮式和带腿人形一定会共存。因为在很多操作场景里,你可以把双臂轮式机器人理解为“站着不动的人”。而带腿的人形机器人,也完全可以选择站在桌子前不动,只做上半身操作。从操作角度看,它们是共通的。
在我们眼里,它们本质上都是humanoid,只是locomotion能力不同而已。
未来是否有可能实现一个通用的controller,可以适配不同结构的人形机器人,而不需要针对每一种形态都单独重新训练?
长期来看一定是可能的,但我觉得在短期内,一个跨embodiment的通用人形控制器,性能上可能很难超过一个专门针对单一人形机器人训练出来的控制器。
原因很现实。现在的network capacity是有限的,而要学习的动作空间又很大。有些行为在不同机器人之间是是互通的,但有些并不是。不同机器人在关节结构、质量分布、自由度设计上都存在差异。
如果你想训练一个模型同时控制H1和G1,那么它所需要的capacity、表示方式以及训练方法,都还是未知数。怎么让一个模型同时学好两个embodiment,目前并没有一个成熟的解决方案。
可能需要online learning,或者某种形式的adaptation,在部署到不同机器人时进行再适配。最近确实有一些相关探索,但整体来说,这仍然是一个开放问题。
跨embodiment 的控制是一个非常值得研究的方向,但它也带来更多挑战。短期内,它的性能可能很难超过一个只在单一embodiment上训练出来的模型,因为后者的capacity可以完全聚焦在一个具体结构上。
当然,这也很难下定论。我们肯定也会做这方面的探索。理想状态当然是一个控制器可以同时支持G1、H2、Booster、Engine、Figure、Tesla——一个模型打通所有人形平台。这是一个非常美好的愿景。
但真正做到这一点,同时还能在每个平台上达到同样高的performance,目前来看还是一个 active research problem,是一个非常开放的课题。
在涉及大幅度交互或复杂环境变化的任务(如上下楼梯、不同地形、失衡恢复、打球等)中,Sonic目前的表现如何,以及在这类强交互场景下能力是否已足够成熟?
简单来说,现在肯定是上不了楼梯的。像上下楼梯、滑板这种动作,对当前这个控制器来说都是out-of-distribution。因为训练时它并没有学过“上楼梯”这类动作。
我们自己也试过。像上下楼梯,其实是一个很实际、很有用的能力,但目前还不在它的能力范围内。滑板这种就更extreme了。
如果单纯去训练一个控制器,让它学会滑板,其实是可以做到的。但问题在于,如果你还希望它同时保持通用性,那就变成一个开放问题了。因为你在增加一个非常特化的能力的同时,可能会影响原本的泛化能力。
所以我觉得,人形机器人的运控问题本身还是有很多值得探索的空间。最近有很多工作在做上下楼梯、跑酷之类的动作,效果非常惊艳。但这些往往是针对特定能力做的优化。
真正难的是:在能做这些高难度动作的同时,还要能支持 VLA 这样的高层任务,还要能做manipulation,还要能autonomous地完成有实际价值的任务。要做一个真正通用、可落地的底层控制器,这件事情仍然需要很多研究和探索。
通用和跑酷之类的有什么矛盾?
其实这两件事情本身并没有本质矛盾。问题更多在于:怎么让一个控制器既能上下楼梯、跑酷,又能同时支持各种全身指令。
比如说,为了让机器人能上下楼梯、跨障碍、做跑酷,底层policy可能必须引入perception。也就是说,运动控制器需要“看到”环境,比如通过depth信息判断前面有一个bump或台阶,然后做出反应。
像PHP(Perceptive Humanoid Parkour)这类工作,本质上是:模型看到depth,然后根据高层指令(比如“往前走”)自己生成具体的步态动作。也就是说,它接收的是high-level command,低层动作是模型内部生成的。
但Sonic的思路不太一样。Sonic更像是外部给定完整的动作轨迹——比如告诉它每个joint应该到哪里,它负责去精确tracking。它是一个motion tracking框架。
这两种方式是有共通性的,但融合起来并不简单。一个是perception-driven、自己生成动作的specialist;另一个是general motion tracker,擅长复现任意给定的全身动作。
问题在于:当你给控制器加入perception,让它学会根据环境自动生成动作时,怎么同时保留“外部给全身指令、它精确执行”的能力?这两种控制范式在接口层面是不同的。
本质上,这是一个generalist和specialist如何融合的问题。怎么让generalist拥有specialist的能力,比如上下楼梯、感知地形,但又不牺牲它原本的通用动作表达能力。
目前来看,这还是一个需要继续探索的方向,还没有一个特别成熟的解决方案。
目前人形机器人是否可以理解为在平地等常规场景下依靠通用控制器已基本够用,但在跳舞、跑酷、上下楼梯等复杂地形或高动态任务中,仍然需要针对性训练的专用policy?
短期来看,基本是这样的。
现在确实有通用控制器,可以支持走路、简单操作、跳舞等基础能力。但如果涉及更复杂的地形(比如楼梯)或更极限的动作(比如高难度跳跃、跑酷),通常还是通过专门训练的specialist policy来实现。
当然,大家都在探索如何把这些能力融合起来,我们也在做类似的尝试。比如Sonic可以跳舞,但它的能力是通用层面的舞蹈动作,而不是那种极限弹跳、空翻、superhero landing级别的specialist动作。
这里面存在一个 trade-off:如果你把模型做得非常专精,它在某些动作上会非常强;但如果你希望它保持通用性,同时还能完成日常可落地、能创造价值的任务,那么在极限能力上可能就不会那么突出。
如何让一个通用控制器既能覆盖日常生产力任务,又能拥有更高阶的specialist能力,同时还保持手腕灵活度、动作质量等细节,这仍然是一个开放问题。
在当前模型的参数规模和算力投入下,是否考虑过进一步扩大训练规模,以验证性能是否还能获得显著提升?
现阶段基本已经把现有数据规模用到了一个比较充分的程度。但接下来如果想同时覆盖更多动作类别、更多任务形态,scale还是要继续往上推。动作种类越多、任务越复杂,就需要更大的模型、更高的compute。
我们的做法其实很简单:尽量往上推Sonic的scale,推到一个阶段——比如在infrastructure 上开始出现瓶颈,或者在model training 继续加规模已经没有明显收益——那说明这个阶段已经接近上限。
目前可以理解为一个阶段性的结果。效果已经不错,但不代表终点。后续肯定还会继续探索更大的数据规模、更大的模型、更系统化的训练方式。这些进展我们也会持续对外分享。
Sonic这类controller目前主要依赖700小时高精度光学动捕数据训练,那未来是否会引入视频/VR等多模态数据来提升能力,还是说底层controller必须依靠这种高精度人体动作数据才能学得好?
当然会考虑。比如像GAE 这类工作,也是从多模态数据中提取人类动作数据,最终还是构造成paired data。只是他们的数据质量可能没有光学动捕那么高,但diversity非常大,也就是覆盖面更广。
我们也考虑过引入更多这类人类数据。只是短期内还没有做特别系统性的尝试。但从直觉和经验来看,只要数据整合方式是合理的,引入更多人类动作数据大概率是有帮助的。
比如在遥操作场景下,更多样化的数据可能会提升控制器的鲁棒性,让它在更多edge case下表现更稳定。所以方向是明确的——更多、更丰富的人类动作数据是有价值的,关键在于怎么加、怎么融合。
References:
Sonic:https://nvlabs.github.io/GEAR-SONIC/
罗正宜社交媒体:
X/Twitter: @zhengyiluo
LinkedIn: Zhengyi (Zen) Luo
Website: https://www.zhengyiluo.com/
Google Scholar: https://scholar.google.com/citations?user=lHPTxGsAAAAJ&hl=en
小红书:正合时宜
石麻好物推荐
在AI逐步涌现能力的时代,作为一个人类幼崽的妈妈,可以一边观察人类智能逐步长成的过程,一边观察AI的逐步成熟。去年我们遇到一个很有意思的儿童对话产品:卡宝,小孩可以随身携带,有很多角色卡片,也可以自己创造角色,产品目前刚刚上线,也推荐给喜欢看石麻笔记的各位读者,产品还在逐步迭代,也欢迎多提意见。