世界模型系列,我们覆盖了第一期基于视频生成的World Action Model(world model as action policy)世界模型EP01:对话高深远——DreamZero&DreamDojo 世界模型与机器人智能的新范式 ,第二期基于2D视觉的可交互世界模型(world model as simulator)世界模型EP02:Interactive World Simulator,第三期基于Dynamics Model的世界模型EP03:Robotic World Model,第四期的统一世界模型世界模型EP04:Motus,第五期的3D世界模型世界模型EP05:对话黄文龙——PointWorld和3D世界模型。
来到第六期,我们采访了国内最早提出WAM思路的工作——VPP的两位一作,胡钰承和郭彦江,他们都是清华大学交叉信息学院陈建宇老师的博士生。VPP这个工作发布在2024年,彼时还是基于VLM做Backbone的VLA路线逐步兴起到日渐火热的阶段,胡钰承和郭彦江在当时非常有预见性的开始了以视频生成做Backbone的WAM路线探索。在2026年上半年“北京有200家世界模型”创业公司的背景下显得额外纯粹和有前瞻性。
我在采访VPP的过程中,也顺带和两位博士交流了他们各自基于VPP这个工作的后续工作,BagelVLA和Ctrl-World。为了方便读者归类,本文覆盖的三个工作可以做如下对应:
VPP vs 世界模型EP01:对话高深远——DreamZero&DreamDojo 世界模型与机器人智能的新范式
BagelVLA vs 世界模型EP04:Motus
Ctrl-World vs世界模型EP02:Interactive World Simulator
查看原文目录
以下为本文目录
👇
第一部分 世界模型
1. 为什么关注世界模型那么早?
2. 世界模型的定义和分类
3. 怎么理解不同路线之间的区别
4. WAM未来怎么拓展?
第二部分 VPP
5. VPP的核心思想
6. VPP的方法介绍
7. VPP给行业带来的启发
第三部分 BagelVLA
8. BagelVLA的核心思想
9. 怎么理解MoT
10. Bagel VLA的训练和数据
VLM和World Model的嵌套
加入VLM的理解更好吗?
11.BagelVLA 数据模块和方法的对应
12. 为什么坚定这个方向?
第四部分 CTRL World
13. Ctrl-World和VPP的区别
14. CTRL-world的方法介绍
15. 关于当前和未来世界模型的思考
第五部分 World Model vs VLA
第一部分 关于世界模型
1. 为什么关注世界模型那么早?
郭彦江:我印象比较深的是2024年初Sora刚发布的时候,大家都很震撼,因为它第一次比较好地建模了物理世界的变化过程。当时我已经在研究基于VLM的VLA通用策略,看到Sora的视频后,我意识到这种视频模型对机器人决策会很有用。
如果我们从第一性原理出发,去判断两件事的难度:是“生成一段机器人操作的视频”更容易,还是“训练一个能完成操作的机器人策略”更容易?哪个更成熟?前者显然更接近当前技术能力。一方面物理世界的操作本身就是一个更难的问题,另一方面大规模预训练的视频模型已经具备很强的泛化能力。如果连“生成通用机器人操作的视频”的问题都无法解决,我很难想象“机器人通用策略”的问题可以被解决。
由于当时的机器人数据规模其实非常有限,我们自己训练的VLA的通用策略感觉没有很好的泛化能力,基本是“给什么学什么”,面对新场景/新任务VLA往往会卡着不动或者漫无目的,很难做出“合理的”动作。最近随着数据质量和规模的提升,VLA也涌现出新任务的泛化能力,例如最近PI发布的pi0.7的工作,这也让我有了一些新的思考。
但在当时的语境下,视频的泛化能力确实深深吸引了我,只要给定当前观测和指令,视频模型就可以向后预测过程。所以我当时的想法是:既然我直接练不出一个有泛化能力的机器人策略,我能不能退一步,先练一个有泛化能力的视频模型,再以此为基础尝试策略的泛化。
2. 世界模型的定义和分类
胡钰承:从定义上看,world model的核心是:基于当前和历史的状态观测,去预测未来的状态。
虽然现在大家提到world model,更多是指视频预测或视频生成(尤其是video prediction),但从更广义的角度看,像VLA或VLM这类方法,其实也可以被视为一种world model——因为它们本质上也是在预测状态,只是没有显式输出图像。
在实际工作中,我们通常会把图像(或视频)和动作一起纳入预测,因为图像中包含了大量有效信息,有助于更好地建模环境。
从当前的发展来看,world model大致可以分为三类:
第一类是基于图像/视频+action的预测,例如VPP、RT-1、OpenVLA等。这类方法通过当前观测来预测未来状态或辅助生成action,目前也可以归为world action model这一类,比较流行。
第二类是基于3D表征的建模,例如李飞飞团队提出的“空间智能”,通过预测或构建3D表示来理解和建模世界。
第三类是基于隐式表征的方法,例如JEPA。这类方法不直接预测像素级图像,而是预测压缩后的特征或latent representation,用于表示未来状态。
整体来看,这三类方法在“预测什么样的未来状态”这一点上有所不同:分别对应显式的图像/视频、3D结构,以及隐式特征表征。
3. 怎么理解不同路线之间的区别
胡钰承:可以打个比方来理解我们(以VPP为代表的World Action Model)和李飞飞他们思路的区别。3D world model,更强调的是rendering质量,也就是未来观测需要尽可能真实地还原世界。这类方法的核心目标,是构建一个高保真的环境模型,因此更适用于simulation、virtual reality等场景。
而VPP这类方法,并不过分强调像素级预测的精确性。我们更关注的是利用视频建模来服务action生成。可以把它理解为一种“action decoder”:通过视频建模,把大量不带动作标注的跨本体数据耦合进来,起到一个桥梁的作用,在VLA框架中连接感知和动作。
当然,这种方法也有缺点。像素级预测虽然包含了丰富信息,但同时也带来了冗余,尤其是背景等与任务无关的部分,也会被一并建模和预测。因此,这类方法的一个缺点是,需要消耗较多算力去重建像素中的冗余信息,尤其是与任务无关的背景部分。但从另一个角度看,它的优势在于保留了完整的信息。虽然存在冗余,但像素中那些真正有效的信息也被一并保留下来了。
相比之下,像JEPA这类方法会对信息进行压缩,虽然更高效,但可能会带来信息损失。而我们这种基于像素的方式,可以看作是一种“近似无损”的信息保留方式。从某种角度看,我们和JEPA其实是有相似之处的——在最终用于action生成时,并不一定直接使用完整的像素。
但关键区别在于训练方式。我们在训练阶段,仍然是在像素空间做完整的重建,也就是显式地预测未来图像或视频;而JEPA更多是在特征或latent空间进行预测,并不直接生成像素。
在使用阶段,我们也不会把完整的视频预测结果作为condition输入到action模块中,而是使用其中的中间表征。所以可以理解为:训练时,我们走的是像素空间的建模路径;但在使用时,更接近于利用隐式表征来辅助action生成。
4. WAM未来怎么拓展?
胡钰承:首先,我们认为当前以WAN等为代表的视频模型,仍然存在一定局限性,尤其是在高层语义理解能力上相对较弱。相比之下,VLM(视觉语言模型)由于经过大量视觉-语言数据训练,在语义理解方面更强。
因此,第一个方向是训练一个视觉语言模型与world model耦合的unified model,这也是我们当前正在探索的重点之一。
第二个方向是数据规模。目前VPP以及相关工作的后训练数据量仍然不够,未来需要引入更多机器人数据,进一步训练更强的world model。
第三个方向是引入更多模态。未来可能会加入触觉等模态,不仅作为condition输入,也作为预测目标之一。不过目前触觉相关的硬件还不够成熟,因此这部分可能会在后续逐步推进。
郭彦江:我觉得基于视频的世界模型最大的优势在于它的scalability。因此一个很重要的发展方向是scale到更大的 manipulation数据集。随着数据规模的提升,很可能会涌现出新的能力。
还有一点我觉得是要学习机器人自己的预训练video model。目前大多数world model工作还是基于video community训练的video foundation model。 但video generation研究人员的训练目标,其实和robot domain并不一致。video模型更关注生成的美学效果,这与机器人操作任务的目标是有差异的。现在的做法,是在这些video foundation model上进行微调,适配机器人任务。
因此,从长远来看,更理想的方向是robot community能够训练自己的foundation model——专门面向manipulation的world model,其优化目标直接服务于操作任务,而不是生成“更好看”的视频。
第二部分 关于VPP
5. VPP的核心思想
郭彦江:当时对我影响最大的是Yilun Du教授的UniPi工作(专访Yilun Du:基于EBM和视频生成的具身智能研究路线)。这篇工作其实非常超前,因为当时甚至还没有“video foundation model”这个概念,视频模型整体能力也比较弱。但UniPi已经提出可以利用视频预测来实现机器人决策。作为开创性工作,它也存在一些小缺陷,最关键的一点是他采用了open-loop control:由于视频生成速度太慢,UniPi先预测完整的视频,再用inverse dynamics model从中提取整条trajectory的action来执行。在看完这篇工作后,我开始思考如何将这种方法改进为closed-loop policy,就开始了VPP的工作。
在具体实现上,我们的一个核心目标就是替换成当时开源的视频基础模型,以及最重要的是大幅加速。我们很直观地分析,视频模型慢的主要原因在于需要多步去噪,一般是10步到50步不等。
我们仔细观察了视频预测去噪的过程,其实大尺度的动态信息在去噪的前几步就已经完成,后期去噪往往是修补细节。因此我们就极限压缩这个过程,直接用一步denoising。如果只用一步,模型推理其实就不慢了。本质上它只是一个几B参数的transformer,推理速度和同规模language model是一个数量级的。
实验中我们发现一步denoising虽然细节不准确,生成结果中已经包含了大量整体的motion信息,比如机器人应该往哪个方向移动、如何接近目标物体。基于这个观察,我们直接使用视频模型中间的latent表征。因为一步denoising本质上可以看作对输入进行了一次前向编码,这使得视频模型可以被视为一个强大的视觉表征编码器。
6. VPP的方法介绍
郭彦江:VPP训练可以分成两个阶段。在第一阶段,我们基于一个通用视频模型,在大量机器人操作数据上继续进行continue trianing。整体训练流程与原始视频模型保持一致,变化主要体现在数据分布上:我们显著增加机器人操作相关数据,同时去除与机器人无关或动态模式差异较大的内容,例如自然风景、山水、人脸等。这样做的目标,是让模型更加聚焦于操作相关的动态建模能力。当时我们是在2024年中开始做这个方向的。那个阶段可用的视频基础模型还不多,不像现在这么丰富。我们当时使用的是一个相对比较早期、但应用较广的模型Stable Video Diffusion,内部是基于transformer U-Net的结构。
第二阶段训练隐式的inverse dynamics model,即 implicit IDM。它的核心思想是:输入并不是两帧都清晰可见的图像,而是由清晰的当前观测和带有一定模糊性的未来预测表征共同构成。这里的模糊性来源于我们只进行了一步前向预测,因此未来细节并不完整。也正因如此,这里的 action prediction 并不等同于严格意义上、完全依赖两帧图像差异进行反推动作的传统 IDM;更准确地说,它是利用视频模型提供的未来信息来辅助动作推断,因此我们将这一机制称为 implicit IDM。
7. VPP给行业带来的启发
郭彦江:关于VPP,我们当时还有一个很重要的观察:视频预测质量与最终决策效果是强正相关的。这一点在我们的paper中被重点阐述。这个观察后来也被后续工作反复验证,几乎所有world action model相关工作都会提到这一点。
在此之前,大多数VLA或相关方法基本都是黑盒系统,很难理解模型内部在做什么。而基于视频模型的VPP,让我们有机会“打开黑盒”,通过预测的视频去间接观察模型的决策过程。这也是我喜欢的地方。
第三部分 BagelVLA
8. BagelVLA的核心思想
胡钰承:我觉得尽量保留VLM(或原有foundation model)的能力,对机器人是非常有价值的。在做完VPP之后,我们也逐渐发现了它的一些问题。与此同时,大约在2025年,尤其是年底,多模态领域开始出现一类“理解-生成一体化”的unified model,并且能力在快速提升。我们发现,这类模型与机器人所需要的能力是非常契合的。在机器人场景中,world model不仅需要做预测,本质上也是对视频数据的一种编码;但与此同时,机器人还需要具备“理解”能力。
因此,我们希望构建一个统一模型,同时具备理解能力和预测能力,并利用理解能力来提升预测效果。在这个思路下,我们开始探索用unified model作为新一代的VLA框架。在具体实践上,2025年初我们基于一个较早的生成-理解一体化模型提出了UPVLA。虽然当时模型还比较初期,但已经具备一定能力。
到了2025年6月,字节跳动推出了Bagel,这是一类更成熟的生成-理解一体化多模态模型。我们看到它在多模态理解和编辑方面的潜力,因此以它为基础,进一步发展出了BagelVLA。这一类方法的核心优势在于:能够结合视觉语言模型的高层语义理解能力,与world model的时序预测能力,从而在统一框架下同时提升理解与决策能力。
这种unified model的优势在于,可以同时耦合不同能力模块。在我们的框架中,不只是简单地融合预测和理解,还进一步把文本推理、未来状态预测以及动作预测统一在一个模型中进行耦合。也就是说,它是一个同时具备理解、推理和预测能力的一体化框架。希望通过unified框架来利用更大规模的数据,学习更丰富的能力。
Unified Model的另一个代表是世界模型EP04:Motus,BagelVLA和Motus一个重要区别在于,他们的视觉语言模型是完全冻结的,只作为一个encoder使用,本质上更像是特征提取模块;而我们的做法是将视觉语言模型与world model进行强耦合,以MOT的方式融合在一起,更接近一个一体化结构。
因此,他们的视觉语言模型不参与推理,也不具备文本reasoning能力;而我们的视觉语言模型是可以进行文本reasoning的,可以同时支持自回归(autoregressive)和diffusion两种模式。
相比之下,他们主要只在做diffusion,用于视频预测;而我们是在一个统一框架中,同时建模理解、推理和预测,这是两者在架构上的一个核心差异。
9. 怎么理解MoT
胡钰承:简单来说,PI的结构是将VLM和一个action expert,通过Mixture of Transformer(MoT)的方式组合在一起。它的核心思路是,在融合action能力的同时,尽可能保留原有VLM的能力。因为在以往的一些方法(比如GROOT、MOTUS)中,如果不对VLM进行冻结或特殊处理,它的能力在联合训练中容易被破坏。
PI通过MoT的结构,让不同模块在一定程度上保持相对独立,从而在学习action的同时,也能保留VLM本身的能力,这是它的一个主要优势。
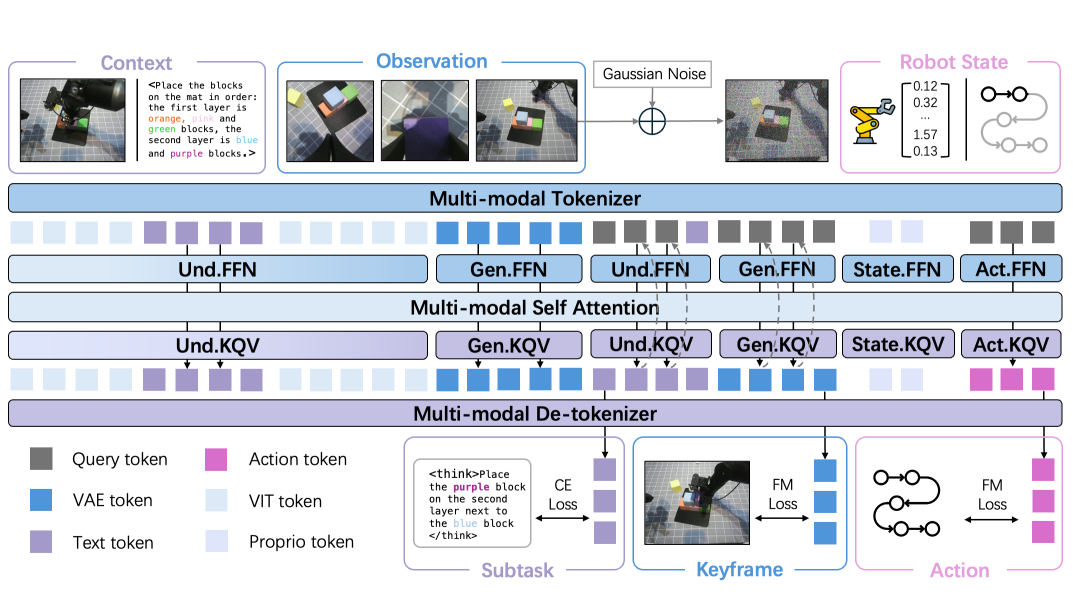
基于这个思路,我们在Bagel或Bagel VLA中,也采用了类似的Mixture of Transformer框架。目标是构建一个unified模型,同时保留三种能力:视觉语言模型的理解能力、world model的未来预测能力,以及action expert的动作生成能力。
10. Bagel VLA的训练和数据
胡钰承:我们的训练是分阶段进行的。第一阶段不会引入带动作标注的数据,而是先训练一个生成-理解一体化的基础模型,然后在后续阶段再学习action expert。
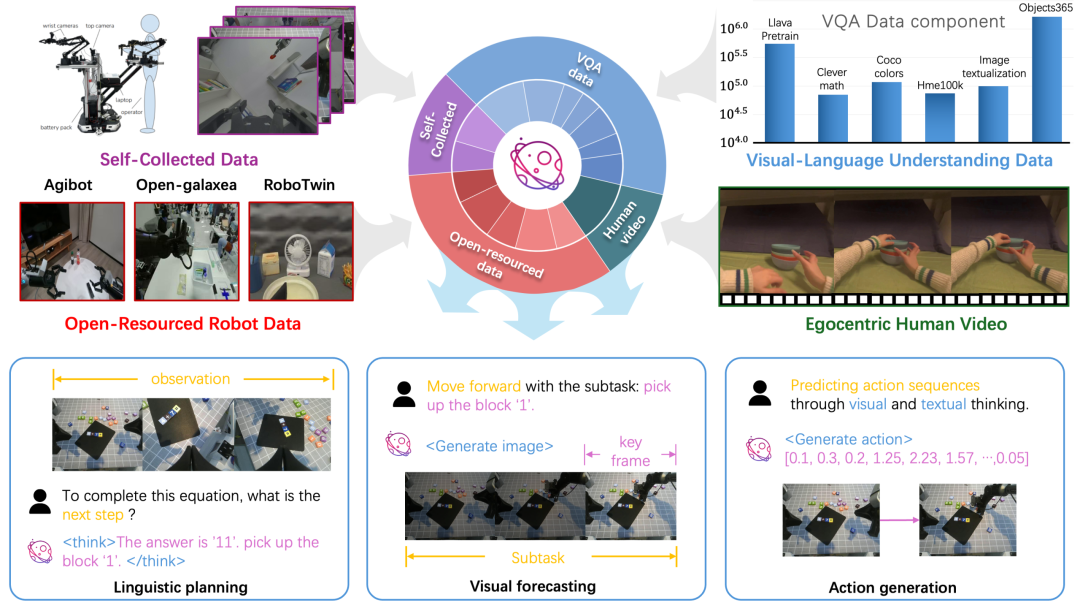
在第一阶段中,主要使用了几类数据:首先是VQA数据,包括Object365等视觉语言数据,用于保留VLM的理解能力。其次是机器人领域的planning数据,主要是任务拆解和规划相关的数据,这部分数据是我们自行处理和构建的。此外,还加入了视频数据、人手操作数据,以及一些开源的机器人数据。对于这些数据,我们也做了进一步处理,比如对任务过程进行切分,标注中间的subtask,用于理解任务结构,同时结合goal image进行预测训练。在预训练阶段,主要使用的就是这些数据。
其中,VQA数据本质上就是视觉语言模型常用的数据形式:给定图像和文本输入,让模型生成对应的文本输出。其实,在训练中引入VQA数据并不是我们独有的做法,很多相关工作也都采用了类似策略。例如PI-0.5,以及ChatVLA等方法,都使用了VQA数据来保留VLM的能力。
我们的不同之处在于,在VQA数据基础上,还加入了机器人领域的planning数据,也就是任务拆解和规划相关的数据。整体上,可以理解为我们结合了开源的通用VQA数据,以及自建的、与机器人任务相关的VQA数据,一起用于训练这个统一的模型,从而同时增强其理解能力和任务规划能力。
VLM和World Model的嵌套
胡钰承:在第一阶段的pre-training中,除了训练VLM相关能力,我们也同时训练了world model部分。因为生成模块本身需要具备预测未来观测的能力,无论是预测未来图像还是视频,所以需要引入world model数据来进行训练。
因此,这一阶段实际上是同时在训练两个能力:一方面是基于VQA数据的理解能力(VLM),另一方面是基于视频数据的未来预测能力(world model)。可以理解为,这一阶段已经在训练“生成专家”,也就是具备未来状态预测能力的模块。
在这个框架中,VLM会先对当前任务进行“理解”和“思考”,然后将这些信息传递给world model,用于未来预测。
这些信息主要有两类:第一类是显式的信息,比如对指令的理解和分解。VLM会对原始指令进行任务拆解,相当于预测“下一步应该做什么”,这些高层语义信息会作为condition输入给world model。第二类是隐式的信息。这些信息不是以文本形式存在,而是存在于VLM中间层的表征中。这些中间表示包含了丰富的高层语义和状态信息。
在MoT(Mixture of Transformer)结构下,world model可以直接从VLM的中间表示中获取这些信息,而不是通过显式的文本传递。也就是说,在attention过程中,这些隐式表征会被自然地传递过去。
因此,VLM传递给world model的输入,本质上包括两部分:一是显式的任务理解(指令分解),二是隐式的高层语义表征。
加入VLM的理解更好吗?
胡钰承:首先,生成-理解一体化模型在图像编辑和预测能力上,显著强于没有引入理解模块(VLM)的模型。从复杂任务的预测效果来看,如果缺少中间的“思考过程”,也就是文本层面的reasoning,模型很难做出高质量的预测。
这一点可以类比当前的语言模型:如果没有中间的thinking或reasoning步骤,模型往往难以一步得到正确答案。因此,我们的目标是构建一种“文本-图像的思维链”,通过引入中间的推理过程,来提升模型在长时序、复杂任务中的预测能力。
11.BagelVLA 数据模块和方法的对应
胡钰承:在BagelVLA中,我们在图像预测上有一个重要区别:预测的不是完整视频,而是keyframe。
具体来说,在数据处理阶段,我们会先对视频进行标注,找到每个subtask对应的keyframe。也就是说,每个子任务都会对应一个关键帧。
在训练时,模型预测的目标就是这些subtask对应的keyframe,而不是连续的视频序列。因此,整个框架中包含两个核心能力:一是linguistic planning,用于生成subtask;二是video forecasting,用于预测对应的keyframe。在这两个能力的基础上,再进行action generation,整体效果会更好。
首先,这一设计的有效性也体现在我们的实验结果中,包括仿真和真机实验。从直觉上来说,这也是比较合理的:最有用的预测其实是不完整图片的预测,而不是完整的去噪。
同时,引入subtask相当于把一个长任务拆解成多个更简单的子任务,这有助于world model进行更准确的预测。因为world model的数据量(尤其是机器人数据)相对有限,它在简单任务上的预测能力通常更强,而对于复杂长指令的直接预测能力相对较弱。
通过“subtask + keyframe”的方式,相当于降低了预测难度,使模型可以逐步完成复杂任务。
可以参考我们论文中Figure 4的结果,我们在其中展示了subtask和keyframe的预测效果。
可以看到,在处理稍微长一些的任务时,引入中间的“文本+图像”的思考过程,会显著降低学习难度。相比直接端到端预测,加入subtask(文本层面的分解)和keyframe(视觉层面的关键状态),能够帮助VLA更容易学习到长时序任务的结构,从而提升整体效果。
12. 为什么坚定这个方向?
胡钰承:我们的一个核心思路,其实是围绕“最大化数据利用”来做模型迭代。
之所以从VLA转向world action model(比如VPP),最初的出发点就是:视频生成是一种自监督训练方式,可以利用大量不带动作标注的数据。这一点非常关键,因为机器人领域本质上是一个“数据永远不够”的工程问题。
因此,除了不断扩充数据规模,更重要的是如何充分利用已有数据,包括跨本体的数据。这也是我们转向world action model的原因,它能够利用这部分无标注数据,从而缓解VLA中数据不足的问题。
但world model本身也有局限——即使是目前最好的视频生成模型也无法产生LLM类似的强大推理能力。
因此,我们进一步提出unified框架,希望同时利用视频数据、机器人数据以及视觉语言数据,把不同来源的数据统一纳入训练,从而最大化数据利用效率。这就是我们整体的工作思路。
其实像MOTUS也可以看作一种unified框架,但它的问题在于,MOTUS并没有真正做到让理解帮助生成。更具体来说,MOTUS中的VLM往往是冻结的,更多是作为一个固定的特征提取器,给生成模型传递的依然是原始的粗颗粒度指令。
从模型结构上看,可以理解为有三个“专家”:理解专家(VLM),负责文本输出和任务理解(subtask);生成专家(world model),负责keyframe预测;动作专家(action expert),负责action生成。这三个专家是同时存在的,并且共享attention计算,但各自有独立参数。也就是说,它们在同一个计算图里交互信息,但功能分工不同。
在输入上,会有不同类型的token:比如text token、visual token(VLM相关)、VAE token(生成模块相关)等,这些token一起参与attention计算,实现信息融合。
在输出上:VLM产生subtask(语言层面的任务拆解),world model产生keyframe(视觉层面的关键状态),两者共同作为condition,输入到action expert,生成最终动作。整体可以理解为一个“统一的大模型”,能够同时吸收多模态信息,并在内部完成理解、预测和决策。
从直觉上看,这种结构既在形式上更统一,也更符合scale的方向:可以持续吸收不同来源的数据,并在同一个模型中进行学习。
第四部分 Ctrl-World
13. Ctrl-World和VPP的区别(或者基于video的世界模型分类)
郭彦江:我们可以先将基于video的world model分成两类:第一大类是video world model as policy,也就是直接将视频模型当错策略使用。本质上是利用视频模型的预测能力来生成optimal的轨迹,辅助生成action。
在world model as policy中,又可以进一步分成几种范式:第一类是两阶段方法,比如UniPi、VPP、Mimic Video、Large Video Planner等。这类方法先做视频预测,再从预测的结果或者表征中提取action。两阶段方法的优势在于能够最大程度保留视频预训练模型的泛化能力。它的缺点是有累积误差:一旦视频预测出错,后续的action基本也会跟着出错。第二类是联合建模预测action和video,例如我之前做的PAD,以及现在的DreamZero,cosmos policy等等。这类方法共享模型参数,优势在于即使video预测出错,action仍然可能是正确的。该类方法的缺点是引入action模态后,会打破原有video模型的预训练。
第二大类是video world model as simulator,即将视频模型作为环境模拟器来使用。在这类方法里,world simulator根据当前观测加上机器人的action,去预测未来的观测,包括成功和失败的未来。这个过程本质上就和simulation是一样的,也就是在建模“执行一个action之后会发生什么”,对应真实世界的dynamics。
在做ctrl-world之前,我已经做了VPP,所以我会想尝试一些不一样的东西。我已经做过world model as policy,就很想看看world model as simulator到底能做到什么程度,后来是在Stanford Chelsea Finn组和Lucy Shi合作完成了这部分工作。
所以我当时的直觉是,world model as simulator一定更难,因为它需要覆盖的分布更大。world model as policy本质上只需要建模相对“最优”的轨迹,它关注的是接近成功的那部分未来;但world model as simulator需要对所有可能结果进行建模,不管action和观测是什么,都要尽量真实地还原结果。
14. CTRL-world的方法介绍
郭彦江:关于数据集选取:World model simulator的质量和数据集关系很大。我最终选择使用Droid数据集,第一点是这个数据集非常diverse。Droid数据集是Chelsea等很多团队用了两年时间基于Franka机械臂收集的,因为当时没有“数据工厂”这种体系,在北美各个学校的实验室里,由很多博士生,本科生等推着Franka机器人一条一条采集出来的,所以数据分布非常丰富。第二点,这个数据集还包含了相当一部分失败数据,这对于world model as simulator是很重要的。现在像RoboArena等一些评测平台,其实也在使用这个数据集。
关于模型架构:在训练过程中,需要对video model做一些调整。因为在world model as simulator中,会引入新的机器人action模态,同时也需要预测多视角,和现在最好的VLA policy能够匹配,从而两者能够交互。让模型学习在“观测+action”的条件下预测未来观测。输出形式本身没有变化,还是预测未来的视频或图像序列。
最终的效果是,你可以随意搭建一个新的Droid平台上,模型就可以泛化到这个新的场景/相机视角,虽然仍然存在不少失败案例。
和世界模型EP02:Interactive World Simulator的工作对比
这两个工作有不同的侧重点,分别关注的是准确性和泛化性。Interactive world simulator主要是针对大约5到6个task,收集了非常大量的数据,在这些特定task上做了非常充分的拟合,因此在这6个任务上的准确性很高,policy evaluation更加准确。而ctrl-world当时使用的是Droid数据集,diversity要高得多,覆盖的是更广泛的分布,所以训练出来的这个control-world,在整个Droid平台上是具备不错的泛化能力,但缺点是在具体单一任务上的精细程度不够高。
这也涉及到world model simulator非常大的挑战:它对数据量的需求非常大,不仅需要成功轨迹,还需要大量失败轨迹,要覆盖的整个state-action的分布。
但从另一个角度,world model simulator它可以吸收和利用失败数据,这似乎又是一个很好的有点。因为VLA或world model as policy,通常只能在optimal数据上训练,我们很难使用失败或者suboptimal的数据。world model as simulator给利用失败的数据提供了一种途径。
15. 关于当前和未来世界模型的思考
郭彦江:当前world model policy和world simulator两种用途区别:World model policy类方法可以直接输出action,用于决策执行。World model simulator一方面可以作为evaluation工具,用来评估policy的效果;另一方面也可以用于online planning, world model可以模拟不同的未来trajectory,生成多个candidate sequence,然后从中选择最优的一个执行。因此,这两类model在实际系统中可以有不同分工,同时也可以融合到同一个决策框架中。整体来看,这些方向都很有价值,也都值得进一步探索。
除了基于video的model,还有一些其他路线:
比如一类是基于3D的方法,代表工作是先做3D reconstruction,再通过rendering,在构建出的3D世界中进行交互和建模。我觉得3D路线的一个核心问题还是数据不足。不像2D视频,几乎整个互联网都是可用数据,而3D数据相对来说非常稀缺。也有一些工作发现,用纯视频做预测,再从中进行3D reconstruction,效果甚至可以超过直接基于3D数据训练的模型。这很大程度上得益于视频数据规模更大、更加scalable。
另一类是LeCun提出的JEPA(Joint Embedding Predictive Architecture)这类方法。它的出发点是认为pixel-level reconstruction过于低效,更关注学习高层的、内在的表征信息。优点是思路非常优雅,缺点是这种表征监督信号比较薄弱,好坏也比较难衡量——不像2D或3D reconstruction,有明确的的监督目标。
此外,还有一些基于graph,particle或dynamics的建模方法,比如Yunzhu Li等人的工作,可以很好利用一些inductive bias,在机器人数据有限的场景会很有用。
整体来看,我个人感觉video这一路线目前是最scalable的,也最容易承载大规模数据,因此最近会相对更受关注。
第五部分. 关于World Model和VLA的一些思考
郭彦江:虽然现在world model很火,但它不一定就比基于VLM的VLA更好。我很早就开始做world model的研究,但我也一直进行着VLA的研究。
很多人因为之前做了比较久的VLA,发现其中有不少问题没有解决,这时候看到world model,就容易把它当成一个“更优解”甚至“救星”。但从我自己的经验来看,并不一定是这样。我观察到在有些任务上, world action model表现更好;但在另一些任务上,VLA反而更有优势。我目前的感觉是,world action model在新任务上的泛化能力,通常会比VLA略好一些,这主要得益于它更好地保留了视频预训练带来的能力。但在一些对精度要求最高、最细致的操作任务,往往还是由VLA方法完成得更好。看了Pi0.7的论文之后,我觉得可能数据足够之后可能两者都可以work,在数据少的时候可能各有优势。
所以我觉得,world model并不是一个“唯一正确”的方向,而是和VLA并行存在的两类modeling方式。在达到足够的数据规模之前,我们很难知道什么才是机器人领域正确的学习目标,到底哪一个监督方式才是机器人领域的“next token prediction”。World model和VLA路线争论的最后,我们可能还是先回到了所有人都在说的数据问题。在我看来,如何构建最有信息熵的数据集,才是今天的通用策略训练的真正门槛所在。
Reference:
郭彦江主页:
胡钰承主页:
https://scholar.google.com/citations?user=WamdPtwAAAAJ&hl=zh-CN
VPP:
https://arxiv.org/abs/2412.14803
ctrl-world:
Bagel VLA:
https://cladernyjorn.github.io/BagelVLA.github.io/